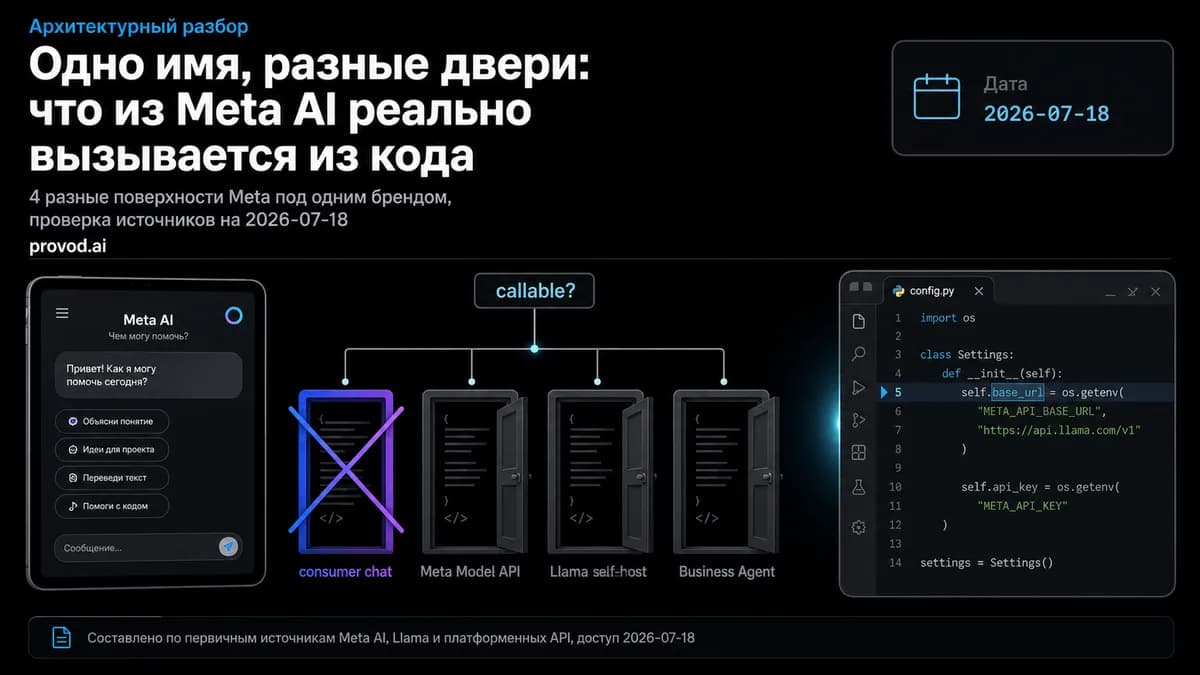
تصور کنید تیمی از برنامهنویسان عبارت «ادغام با Meta AI» را در اسناد فنی خود مینویسند و سپس با یک حقیقت تلخ مواجه میشوند. برای آنها، جولای ۲۰۲۶ تبدیل به یک مطالعهی موردی در این باره شد که چگونه برندینگ شرکتی میتواند واقعیتهای فنی را بپوشاند. این تیمها احتمالاً تصور میکردند که یک نام تجاری واحد، تضمینکنندهی یک دسترسی فنی پایدار است، اما واقعیت چیز دیگری بود.
به گزارش منابع داخلی، در ۶ جولای ۲۰۲۶، متا پیشنمایش عمومی Llama API را تعطیل کرد و پاسخهای مدل را با اعلانهای پایان سرویس (sunset notices) جایگزین نمود. سپس در ۹ جولای، شرکت Meta Model API را معرفی کرد تا دسترسی سلفسرویس به مدل Muse Spark 1.1 را فراهم کند؛ هرچند این دسترسی در ابتدا تنها برای توسعهدهندگان ایالات متحده بود. این دو اتفاق، هفتهای پرهرجومرج را رقم زد که هیچکدام از آنها ارتباط مستقیمی با دستیار چت مصرفکننده که در اپلیکیشنهای موبایل دیده میشود، نداشت.
چون برند «Meta AI» مانند یک چتر برای محصولاتی با چرخهی حیات، شرایط دسترسی و ساختارهای حاکمیتی متفاوت عمل میکند، برنامهریزی بر اساس نام برند بهجای مستندات API، یک خطای معماری بحرانی است. این رویکرد، وابستگیای ایجاد میکند که تا لحظهی استقرار در محیط تولید (production deployment)، قابل بازبینی و تأیید نیست و میتواند کل پروژه را با ریسک توقف ناگهانی مواجه کند.
برای درک وضعیت فعلی پیشنهادات متا تا ۱۸ جولای ۲۰۲۶، باید برند را به سطوح فنی واقعیاش تجزیه کرد. দৃশ্যپذیرترین بخش، دستیار مصرفکننده است که از طریق meta.ai، اپلیکیشن Meta AI و ادغمدر واتساپ، اینستاگرام، مسنجر و فیسبوک در دسترس است. به نقل از مستندات متا، این یک محصول برای استفاده شخصی است که با شعار «بپرس، چت کن، خلق کن» (Ask, Chat, Create) عرضه شده است. نکتهی حیاتی این است که متا هیچ API توسعهدهندهای برای این رابط چت خاص منتشر نکرده است.
اینجاست که نخستین شکاف بزرگ ایجاد میشود: توسعهدهندهای دستیار را میبیند که روی گوشی به سؤالات پاسخ میدهد یا عکس میسازد و به اشتباه تصور میکند API مشابهی برای آن رفتار خاص وجود دارد. در واقعیت، رابط مصرفکننده یک اکوسیستم بسته است و تلاش برای ساخت منطق تجاری بر اساس قابلیتهای ظاهری آن، بدون داشتن یک API مستند، دستورالعمل شکست است. همانطور که در تحلیلهای پیشین ما دربارهی ریسکهای وابستگی به مدلهای بسته اشاره کردیم، تکیه بر قابلیتهای غیرمستند، پایداری سیستم را به خطر میاندازد.
فراتر از رابط مصرفکننده، Meta Model API قرار دارد که اساساً با مورد قبلی متفاوت است. در حالی که دستیار مصرفکننده یک محصول نهایی و بستهبندی شده است، Model API ابزاری برای ساخت محصولات جدید توسط توسعهدهندگان است. معرفی Muse Spark 1.1 از طریق این API، استراتژی متا برای عرضه قابلیتهای خاص مدلها به یک گروه کنترلشده از توسعهدهندگان را نشان میدهد. با این حال، محدودیت دسترسی برای توسعهدهندگانی که صرفاً در ایالات متحده مستقر هستند، پیچیدگیهای ژئوپلیتیک و نظارتی استقرار هوش مصنوعی را برجسته میکند.
برای شرکتهای جهانی، تکیه بر یک API «سلفسرویس» (Self-serve) که دارای دروازههای جغرافیایی (geographically gated) است، به معنای شکنندگی معماری است. اگر API در منطقهای که اپلیکیشن مستقر شده است در دسترس نباشد، ادغام عملاً غیرexistent یا ناموجود است. بنابراین، یک سناریو تنها زمانی باید در نقشهی راه فنی گنجانده شود که هم دارای سطح (surface) مستند باشد و هم دسترسی تأییدشده و بدون محدودیت داشته باشد.
لایه دیگری از پیچیدگی، خانواده مدلهای وزنهای باز (Open Weights) در Llama است؛ یعنی مدلهایی که وزنهای آنها منتشر شده و میتوان آنها را دانلود کرد و روی زیرساختهای خصوصی میزبانی نمود. بسیاری از توسعهدهندگان Llama API (سرویس میزبانیشده و ابری) را با خودِ مدلهای Llama (وزنهای قابل دانلود) اشتباه میگیرند. وقتی متا یک پیشنمایش API خاص را میبندد، به این معنا نیست که مدل حذف شده است؛ بلکه به این معناست که «راحتیِ میزبانی» توسط متا از بین رفته است.
این تفکیک برای پایداری معماری حیاتی است. تیمی که به API میزبانیشده تکیه میکند، کاملاً تابع زمانبندی تعطیلی (sunsetting schedule) ارائهدهنده است، در حالی که تیمی که مدل را روی واحد پردازش گرافیکی (GPU) — همان سختافزار قدرتمندی که مثل موتورخانه برای پردازشهای سنگین عمل میکند — خود میزبانی میکند، کنترل سرنوشت خود را در دست دارد. اشتباه در درک «Meta AI» به عنوان یک سرویس و «Llama» به عنوان یک مدل، منجر به موقعیتهایی میشود که توسعهدهندگان گمان میکنند ادغام پایداری دارند، اما در چرخههای بهروزرسانی بحرانی با خطاهای ۴۱۰ (Gone) مواجه میشوند.
علاوه بر این، ادغام AI در پلتفرمهای اجتماعی مانند واتساپ و اینستاگرام، یک لایه API «پنهان» ایجاد میکند. در حالی که این پلتفرمها APIهای تجاری (Business APIs) خود را دارند، ویژگیهای AI در داخل آنها اغلب به عنوان ویژگیهای داخلی محصول مدیریت میشوند، نه ابزارهای توسعهدهنده خارجی. انتظار همیشگی و رایج میان توسعهدهندگان این است که بتوانند به دستیار Meta AI در یک چت تجاری واتساپ «قلاب» (hook) شوند تا خدمات مشتری را خودکار کنند.
اما مسیر فعلی متا نشان میدهد که آنها ترجیح میدهند منطق سطح بالای دستیار را اختصاصی (proprietary) نگه دارند و در عوض، مدلهای زیربنایی را از طریق Model API برای پیادهسازیهای سفارشی ارائه دهند. این یعنی توسعهدهندگان نمیتوانند صرفاً Meta AI را در باتهای فعلی خود «فعال» کنند؛ آنها باید منطق را خودشان با استفاده از Model API بسازند و سپس آن را از طریق کانالهای پیامرسان پلتفرم مستقر کنند.
این پراکندگی یک «شکاف اعتبارسنجی» (validation gap) ایجاد میکند. در مهندسی نرمافزار سنتی، یک وابستگی با چک کردن شماره نسخه و صفحه مستندات تأیید میشود. اما در عصر فعلی و بهخصوص در اکوسیستم متا، اعتبارسنجی مستلزم بررسی چهار رکن است: برند، نسخه دقیق مدل، درگاه (gateway) API و در دسترس بودن جغرافیایی. اگر هر یک از این چهار ستون غایب باشد، ادغام شما یک «فرضیه» است، نه یک «واقعیت» فنی.
خطر «توسعه برند-محور» این است که ذینفعان را تشویق میکند تا ویژگیها را بر اساس دموهای تبلیغاتی تأیید کنند، نه امکانسنجی فنی. وقتی یک مدیر محصول میگوید «میتوانیم برای این کار از Meta AI استفاده کنیم»، احتمالاً به قابلیتی اشاره دارد که در یک سخنرانی کلیدی (keynote) دیده است، نه قابلیتی که در کنسول توسعهدهنده برای استفاده آماده باشد.
برای کاهش این ریسکها، معماران باید رویکرد سختگیرانه «سطح-محور» (Surface-First) را پیاده کنند. این یعنی هر قابلیت مورد نیاز باید به یک Endpoint مستند متصل شود. اگر قابلیت مورد نظر «خلاصهسازی» است، معمار باید دقیقاً مشخص کند که آیا این کار از طریق یک نمونه Llama میزبانیشده، Meta Model API یا یک ارائهدهنده شخص ثالث انجام میشود. اگر تنها مسیر موجود یک API «پیشنمایش» است، معماری باید حتماً شامل یک مکانیسم جایگزین (Fallback) یا یک برنامه خروج (deprecation plan) شفاف باشد.
اتفاقات جولای ۲۰۲۶ یک هشدار است: انتقال از «پیشنمایش» به «تولید» در دنیای AI اغلب ناگهانی و غیرخطی است. تعطیلی پیشنمایش Llama API شکست فناوری نبود، بلکه یک انتقال برنامهریزیشده به یک مدل دسترسی جدید بود. اما برای کسانی که سطح دقیق API را ردیابی نمیکردند، این اتفاق مانند یک شکست ناگهانی و غیرمنتظره در سیستم آنها بود.
در نهایت، معرفی Muse Spark 1.1 نشان میدهد که متا به سمت رویکردی ماژولار حرکت میکند. بهجای یک مدل غولآسای واحد تحت عنوان «Meta AI»، آنها مدلهای تخصصی برای وظایف مختلف مستقر میکنند. این یعنی «ادغام با Meta AI» دیگر یک تکوظیفه نیست، بلکه مجموعهای از تصمیمات است در این باره که کدام مدل برای کدام کاربرد (use case) مناسب است. مدلی که برای جرقههای خلاقانه (creative spark) بهینه شده است (مانند Muse)، شاید گزینه درستی برای یک تسک استخراج دادههای ساختاریافته نباشد.
متا با بستهبندی اینها زیر یک برند، پیام را برای مصرفکنندگان ساده میکند اما نقشه فنی را برای توسعهدهندگان پیچیده میکند. شغل توسعهدهنده این است که این برند را تجزیه (unbundle) کند و با هر مدل و API به عنوان یک موجودیت مجزا با توافقنامه سطح خدمات (SLA)، مدل قیمتگذاری و منطقه دسترسی خاص برخورد کند.
در مجموع، زیرساخت فعلی هوش مصنوعی متا داستانی هشداردهنده درباره تفاوت بین «برند محصول» و «رابط فنی» است. Meta AI مصرفکننده یک «مقصد» است، در حالی که Meta Model API یک «ابزار» است. اشتباه گرفتن این دو منجر به بیثباتی معماری و شکست در استقرار میشود. تا ۱۸ جولای ۲۰۲۶، تنها راه قابل اعتماد برای برنامهریزی ادغام AI، نادیده گرفتن اصطلاحات بازاریابی و تمرکز انحصاری بر سطوح مستند و حقوق دسترسی تأییدشده است.
تنها در این صورت است که یک توسعهدهنده میتواند از قلمروی «پیشبینی» — یعنی امید به اینکه ویژگی خاصی در دسترس باشد — به قلمرو «واقعیت» نقل مکان کند، جایی که سیستم بر پایه Endpointهای قابل تأیید ساخته شده است. هدف هر تیم حرفهای باید حذف «وابستگیهای نام-برند» و جایگزینی آنها با نقشه دقیقی از سطوح API باشد تا نرمافزار فارغ از اینکه متا در چرخه بهروزرسانی بعدی نام محصولاتش را چه میگذارد، فعال بماند. این رویکرد منضبط، تنها راه عبور از نوسانات «تب طلا»ی فعلی بدون افتادن در تلهی ساختوساز روی شنهای روان است.
گام بعدی شما
- تمام وابستگیهای AI خود را از نام برند (مثلاً Meta AI) به Endpointهای مستند (مثلاً Muse Spark 1.1 via Model API) تغییر دهید.
- برای هر قابلیت پیشنمایشی که استفاده میکنید، یک سناریوی جایگزین (Fallback) در معماری خود پیشبینی کنید.
- دسترسیهای جغرافیایی APIهای مورد استفاده را بررسی کنید تا از قطع ناگهانی سرویس در مناطق مختلف جلوگیری کنید.
اما داستان سختافزاری این تحول و نحوه مدیریت حافظه در مدلهای ماژولار حتی پیچیدهتر است — به تحلیل ما دربارهی بهینهسازیهای استنتاج در مدلهای Llama مراجعه کنید.



گفتگو