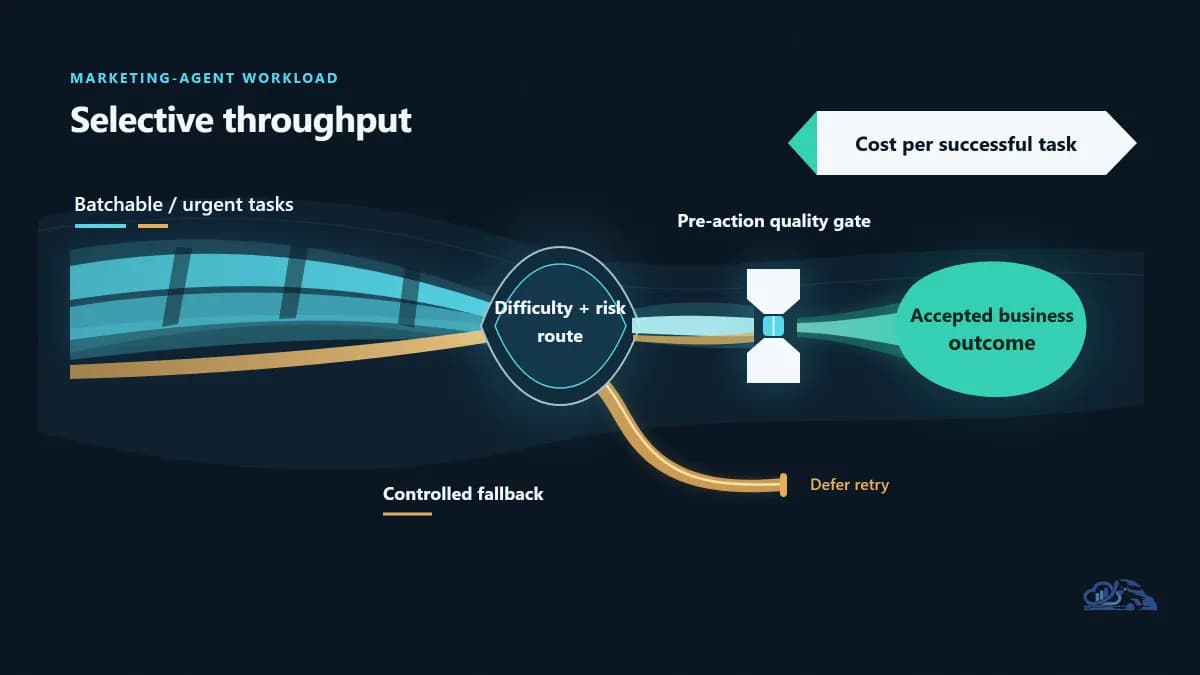
اگر امروز برای هر توکن در API مدلهای زبانی هزینه میدهید، احتمالاً با یک «نشتی مالی» بزرگ روبرو هستید که هیچ داشبورد استانداردی آن را نشان نمیدهد. باید بدانید که در مقیاس واقعی، هزینه یک توکن اهمیتی ندارد؛ آنچه اهمیت دارد این است که یک عامل هوش مصنوعی برای رسیدن به یک نتیجهی پذیرفتهشده، در مجموع چقدر هزینه کرده است.
طبق گزارشهای CNBC و Quartz در ۱۹ ژوئیه ۲۰۲۶، متا (Meta) و آنتروپیک (Anthropic) در حال مذاکره برای قراردادی به ارزش ۱۰ میلیارد دلار طی دو سال هستند. این مذاکرات در واقع تلاشی برای مدیریت منابع عظیم محاسباتی است که در جزئیات توافق ۱۰ میلیارد دلاری متا برای اجاره زیرساختها به آنتروپیک به آنها پرداختهایم. در این توافق احتمالی، آنتروپیک مبالغ ماهانهای را به متا پرداخت خواهد کرد. هرچند این معامله هنوز قطعی نیست، اما ابعاد این گفتگوهای اولیه یک واقعیت مالی عمیق را برای توسعهدهندگان برملا میکند: هزینه واقعی اجرای عاملهای هوش مصنوعی (AI Agents) در مقیاس گسترده، بسیار فراتر از قیمت سادهی توکنها است.
همانطور که در تحلیل قبلی ما دربارهی دلیل بازنشانی مکرر سهمیههای OpenAI و Anthropic اشاره کردیم، این روند نشان میدهد که ظرفیت محاسباتی (Compute Capacity) اکنون به تنگنای اصلی برای عملکرد قابل اعتماد عاملهای هوش مصنوعی تبدیل شده است. اگر محاسبات ارزانقیمت در دسترس نباشد، یک عامل نمیتواند با پایداری کمپینها را اجرا کند، سرنخها (Leads) را مسیریابی نماید یا محتوای مفید منتشر کند. برای یک برنامهنویس، هزینه هر «صندلی» (هزینه دسترسی) یا «توکن» (هزینه مصرف) تنها یک معیار سطحی است. هیچکدام از اینها به شما نمیگوید که یک نتیجه پذیرفتهشده، پس از چندین تلاش ناموفق و پاکسازی دادههای پاییندستی، واقعاً چقدر هزینه برداشته است.

معیار عملیاتی جدید
برای مدیریت این هزینهها، توسعهدهندگانی که به دنبال بهینهسازی هستند، به سمت یک معیار प्राथमिक جدید حرکت کردهاند: هزینه هر وظیفه موفق (Cost per Successful Task). بر اساس تحلیلهای منتشر شده در dev.to، این مقدار از تقسیم مجموع هزینههای مدلها، ابزارها، دفعات تلاش مجدد (Retries)، بازبینیها و اقدامات اصلاحی بر تعداد وظایف پذیرفتهشده به دست میآید.
در این رویکرد، «موفقیت» دیگر با یک پاسخ ساده از API تعریف نمیشود، بلکه باید بر اساس معیارهای سختگیرانهی پذیرش (Acceptance Criteria) سنجیده شود. بسیار حیاتی است که صورت و مخرج این کسر در یک بازه زمانی یکسان اندازهگیری شوند و بر اساس کلاس وظیفه تفکیک گردند. برای مثال، عملیات مسیریابی سرنخها و انتشار محتوا نباید تنها به دلیل استفاده از یک زیرساخت مشترک، را به یک هدف هزینه واحد مرتبط کنند.
کنترل مسیر اجرا
اجرای عملیاتی این استراتژی نیازمند قرار دادن کنترلهای صریح در دل گردشکار است تا این ابزارها یکدیگر را تقویت کنند. این کنترلها شامل موارد زیر است:
- مسیریابی مبتنی بر وظیفه (Task-based routing): هر دسته از وظایف باید به جای اختصاص به یک مدل پیشفرض، به مدل مناسب برای آن کلاس خاص هدایت شود.
- درگاههای کیفی زودهنگام (Early quality gates): قبل از فعال کردن ابزارهای گرانقیمت یا انتشار در مراحل پاییندستی، یک بررسی صحت انجام شود. این کار باعث میشود خروجیهای غیرقابل استفاده، پیش از آنکه باعث ایجاد کارهای بیشتر و هزینههای اضافی شوند، مسدود گردند.
- سقف تلاش مجدد (Retry caps): تعداد دفعات تلاش برای یک وظیفه محدود شود و دلیل شکست ثبت گردد. سپس در صورتی که حد مجاز طی شود، موضوع سریعاً به یک کاربر انسان ارجاع داده شود تا از مصرف بیرویه و نامحدود منابع محاسباتی توسط یک مسیر ضعیف جلوگیری شود.
- دستهبندی (Batching): در مواردی که تأخیر (Latency) پذیرفتنی است، کارهای سازگار با یکدیگر ترکیب شوند تا توان عملیاتی (Throughput) وابسته به درخواستهای تکبهتک نباشد.
- ارکستراسیون قابل انتقال (Portable Orchestration): مدیریت جریانها را قابل انتقال نگه دارید و مسیرهای جایگزین (Fallback) را پیش از آنکه ظرفیت محاسباتی محدود شود، آزمایش و فعال کنید.
ابزارسازی و دادهها
توسعهدهندگان میتوانند هر اجرا را با استفاده از یک رکورد ساختاریافته به نام «رویداد وظیفه» (Task Event) ابزارسازی کنند. این رکورد به تیمها اجازه میدهد توضیح دهند چرا دو وظیفه با مجموع توکنهای مشابه، هزینههای خروجی بسیار متفاوتی داشتهاند. یک رکورد Task Event میتواند از مقادیر جایگزین زیر استفاده کند:
{ "task_class": "<task class>", "selected_route": "<selected route>", "attempt_count": "<recorded count>", "tools_used": ["<tool name>"], "gate_result": "<pass or fail>", "escalation_status": "<escalation status>", "final_acceptance_result": "<accepted or rejected>", "costs": { "model": "<recorded cost>", "tools": "<recorded cost>", "review": "<recorded cost>", "remediation": "<recorded cost>" } }
این تغییر رویکرد نشان میدهد که برخورد با «کیفیت» به عنوان یک «کنترل بودجه»، تنها راه حفظ هزینههای دفاعپذیر در هوش مصنوعی است. انتقال بازبینی کیفیت از انتهای یک گردشکار به ابتدای آن، از «نشتیهای محاسباتی» جلوگیری میکند؛ یعنی از حالتی که یک عامل هزاران توکن را صرف تحقیق، نگارش، تصویرسازی یا مسیرهای توزیعی میکند که از ابتدا محکوم به شکست بودند.
سیاستهای مسیریابی باید مستقل از ارائهدهندگان خاص (Providers) باقی بمانند. اگرچه لایههای انتزاعی (Abstraction layer) هزینههای نگهداری را افزایش میدهند و برخی قابلیتهای خاص هر فروشنده ممکن است یک مسیر تخصصی را توجیه کند، اما قابلیت انتقال (Portability) مانع از آن میشود که نبود یک مسیر خاص، تمام حجم کاری واجد شرایط را به صورت خاموش متوقف کند. یک مسیر جایگزین تستشده، فراتر از داشتن یک اعتبارنامه API دوم است؛ این مسیر باید همان درگاه پذیرشی مسیر اصلی را داشته باشد. اگر مسیر جایگزین نتواند این درگاه را پاس کند، سیستم باید به جای پذیرش خاموش یک نتیجه ضعیف، به صورت آشکار شکست بخورد و موضوع را ارجاع دهد.
در نهایت، هدف این است که بهجای پرسش «آیا عامل کار را تمام کرد؟»، بپرسیم «آیا گردشکار یک نتیجه پذیرفتهشده با هزینهای منطقی تولید کرد؟». رقم ۱۰ میلیارد دلاری در مذاکرات متا و آنتروپیک، یک سیگنال کلان از اشتهای عظیم برای محاسبات (Compute) است که برای تبدیل این عاملها به ابزارهایی قابل اعتماد در محیط تولید نیاز است.
همیشه توازنها (Trade-offs) را در نظر داشته باشید: دستهبندی باعث افزایش زمان انتظار میشود، درگاههای سختگیرانهتر ممکن است حجم پذیرش را کاهش دهند و ارکستراسیون قابل انتقال نیاز به تستهای بیشتر دارد. با گسترش گردشکارهای عاملی، تنگنای بعدی احتمالاً توازن بین تأخیر ناشی از دستهبندی در مقابل هزینه اجرای فوری خواهد بود. شما میتوانید همین امروز با ممیزی خط لوله (Pipeline) خود شروع کنید تا شناسایی کنید در کجا یک «درگاه کیفی زودهنگام» میتواند بیشترین کاهش هزینه اصلاحی را ایجاد کند.
گام بعدی شما
- خط لوله (Pipeline) خود را ممیزی کنید تا نقاطی که یک «درگاه کیفی زودهنگام» میتواند بیشترین کاهش هزینه را ایجاد کند، شناسایی نمایید.
- معیارهای پذیرش (Acceptance Criteria) هر وظیفه را از پاسخ API تفکیک کرده و هزینه واقعی هر نتیجه موفق را محاسبه کنید.
- برای هر کلاس از وظایف، یک مدل جایگزین (Fallback) تستشده تعریف کنید تا توقف عملیات به دلیل نبود ظرفیت رخ ندهد.
اما داستان سختافزاری این تحول حتی شگفتانگیزتر است — به تحلیل ما دربارهی تراشههای Blackwell مراجعه کنید.



گفتگو