یک اختلال ساده در شبکه میتواند باعث شود از حساب مشتری برای یک سفارش واحد، دو بار وجه کسر شود. این خطر پنهان در عاملهایی است که بدون مکانیزمی برای تأیید موفقیت تلاش اول، دستورات شکستخورده را بهطور خودکار تکرار میکنند. یک تایماوت (Timeout) به شما میگوید که کلاینت چه چیزی دیده است، اما نمیگوید که سرور چه کاری انجام داده است. این تمایز اکنون که عاملهای هوش مصنوعی ایمیل میفرستند، تیکت باز میکنند و پول جابهجا میکنند، بسیار حیاتیتر شده است.
در ۲۴ سپتامبر ۲۰۲۶، جیپنگ لی (Jiapeng Li) از شرکت مایکروسافت (Microsoft) مقالهای با عنوان «Exactly-Once کجا زندگی میکند؟» در arXiv منتشر کرد. این پژوهش بر شکافی حیاتی در نحوه مدیریت «تأییدیه های گمشده» (lost acknowledgments) توسط مدلهای پیشرو تمرکز دارد؛ وضعیتی که در آن سرور یک وظیفه را به طور کامل انجام میدهد اما کلاینت هرگز تأییدیه را دریافت نمیکند.
در دنیای نرمافزارهای سنتی، این مسئله حل شده است. غولهای پرداختی مثل استرایپ (Stripe) و پیشروان ابری مانند آمازون (Amazon) سالهاست از کلیدهای Idempotency (Idempotency Keys) — شبیه به شماره رسید منحصربهفردی که اجازه نمیدهد یک فاکتور دو بار پرداخت شود — استفاده میکنند تا هر درخواست صرفاً یکبار پردازش شود، فارغ از اینکه چند بار ارسال شده باشد. اما عاملهای هوش مصنوعی بهعنوان کاربران جدید این APIهای قدیمی، اغلب در استفاده درست از این حفاظهای ایمنی شکست میخورند.
همانطور که در تحلیلهای قبلی ما دربارهی امنیت مدلهای عاملمحور اشاره کردیم، اعتماد کورکورانه به خروجی مدل بدون لایهی نظارتی، ریسکهای عملیاتی را بهشدت افزایش میدهد.
یافتههای بنچمارک Limbo
لی برای اندازهگیری این ریسک، محیط Limbo را معرفی کرد؛ یک سندباکس شامل ۶ سرویس شبیهسازیشده با خطاهای تزریقشده. این مطالعه ۲۵,۹۳۰ اپیزود را در ۹ مدل مختلف و ۳ چارچوب تولیدی (Production Agent Harnesses) در برابر یک دفتر کل (Ledger) از آنچه واقعاً ثبت شده بود، بررسی کرد.
نتایج تضاد شدیدی را بین توانایی مدل و واقعیت شبکه نشان میدهد:
- وقتی امکان بازخوانی سریع وضعیت (Read-back) برای تأیید وجود دارد، مدلهای پیشرو تقریباً هرگز عملیات نوشتنی را تکرار نمیکنند (نرخ خطای ۰.۵٪).
- وقتی درخواست هنوز در مسیر است (In-flight) یا توسط لایه انتقال دو بار تحویل داده میشود، نرخ تکرار به ۵۶٪ و ۷۴٪ میرسد.
- نکته تکاندهنده این است که در ۹۰٪ موارد تکرار اثر (Effect)، عامل بهاشتباه گزارش داد که عملیات با موفقیت انجام شده است.
استانداردهای صنعتی و پیشینهها
مفهوم Idempotency قدیمی است اما حالا با نوع جدیدی از کاربر (عاملهای AI) روبروست. چندین استاندارد صنعتی نحوه عملکرد این سیستم را تعریف کردهاند:
- استرایپ (Stripe): طبق مستندات درخواستهای Idempotent آنها (بررسی شده در ۴ اکتبر ۲۰۲۶)، استرایپ کد وضعیت (Status Code) و بدنه اولین درخواست را برای یک کلید ذخیره میکند، «صرفنظر از اینکه درخواست موفق شود یا شکست بخورد». اگر کلیدی تکراری با پارامترهای متفاوت ارسال شود، استرایپ خطا برمیگرداند.
- آمازون (Amazon): در مقالهای از کتابخانه سازندگان آمازون در سال ۲۰۲۰ با عنوان «ایمنسازی تلاشهای مجدد با APIهای Idempotent»، مالکوم فیتونبی رویکرد ترجیحی آمازون را توصیف میکند: الزام به ارائه یک شناسه درخواست کلاینت منحصربهفرد که توسط فراخواننده ارائه شده و در قرارداد API گنجانده شده است.
- IETF: پیشنویس هدر
Idempotency-Keyدر IETF در ۱۵ اکتبر ۲۰۲۵ به ویرایش ۰۷ رسید. با این حال، این ویرایش در ۱۸ آوریل ۲۰۲۶ منقضی شد و هنوز به یک استاندارد رسمی تبدیل نشده است.
راهکار کلیدهای Idempotency
بر اساس یافتههای این پژوهش، ارائه یک کلید Idempotency برای هر عملیات نوشتنی، نرخ تکرار را از ۲۸٪ به ۴٪ کاهش داد. دلیل این اتفاق ساده است: عاملها معمولاً زمانی از کلیدها استفاده میکنند که این قابلیت صراحتاً در تعریف ابزار (Tool Definition) ذکر شده باشد.
با این حال، تمام استراتژیهای تلاش مجدد (Retry) یکسان نیستند. مطالعه یک خطای رایج به نام «کلید جدید برای هر تلاش» (New key per attempt) را شناسایی کرد. این اتفاق زمانی رخ میدهد که یک عامل شماره تلاش (مثلاً retry1-) را به کلید اضافه میکند. این کار Idempotency ایجاد نمیکند؛ بلکه صرفاً یک درخواست منحصربهفرد جدید میسازد و در عمل مانند یک «چاپگر رسید» عمل میکند که چندین بار از مشتری وجه کسر میکند.
ساخت لایهی ابزار ایمن
برای جلوگیری از این شکستها، توسعهدهندگان باید مسئولیت شناسایی (Identity) را از مدل به چارچوب (Harness) منتقل کنند. ما میتوانیم این مدل را با یک پیادهسازی TypeScript شبیهسازی کنیم که در آن یک سرویس صورتحساب، پرداختهای یک مشتری (مثلاً "acme") را برای مبلغی خاص (مثلاً ۴۹ دلار) مدیریت میکند.
در این مدل، ما در برابر سه خطای شبکه خاص تست میکنیم:
- lost-ack: تراکنش در سرور ثبت میشود اما پاسخ گم میشود. کلاینت تایماوت میبیند.
- late-commit: درخواست هنوز در مسیر است و کلاینت تسلیم میشود؛ اما درخواست ۹۰ ثانیه بعد به سرور میرسد.
- redelivery: لایه انتقال یک درخواست را دو بار تحویل میدهد؛ کلاینت یک موفقیت میبیند اما سرور دو بار وجه کسر میکند.
از دید کلاینت، دو مورد اول یکسان به نظر میرسند. برای حل این مشکل، یک معماری مستحکم باید این زنجیره فرمان را دنبال کند:
۱. مدل قصد (Intent) را پیشنهاد میدهد (مثلاً «کسر ۴۹ دلار از حساب acme»).
۲. چارچوب یک کلید قصد ثابت (Pinned Intent Key) تولید میکند. این کار با ایجاد نسخهای استاندارد (Canonical) از آرگومانها (مرتبسازی آنها برای اطمینان از ثبات)، هش کردن آنها با SHA-256 و ترکیب آن هش با شناسه تسک و نام ابزار انجام میشود.
۳. ابزار بررسی میکند آیا این کلید را قبلاً دیده است یا خیر. اگر کلید وجود داشت و آرگومانها یکی بود، پاسخ قبلی را بازپخش (Replay) میکند. اگر کلید وجود داشت اما آرگومانها متفاوت بود، درخواست را رد میکند.
۴. دفتر کل (Ledger) مدرک نهایی برای ثبت دقیقاً یک تراکنش را ارائه میدهد.
این رویکرد تضمین میکند که حتی اگر مدل ۱۰ بار تلاش مجدد کند، کلید یکسان بماند. اگر چارچوب نتواند وضعیت را تأیید کند و کلیدی وجود نداشته باشد، تنها پاسخ صادقانه، ارجاع موضوع به انسان است، نه حدس زدن با کارت اعتباری مشتری.
تحلیل استراتژیهای تلاش مجدد
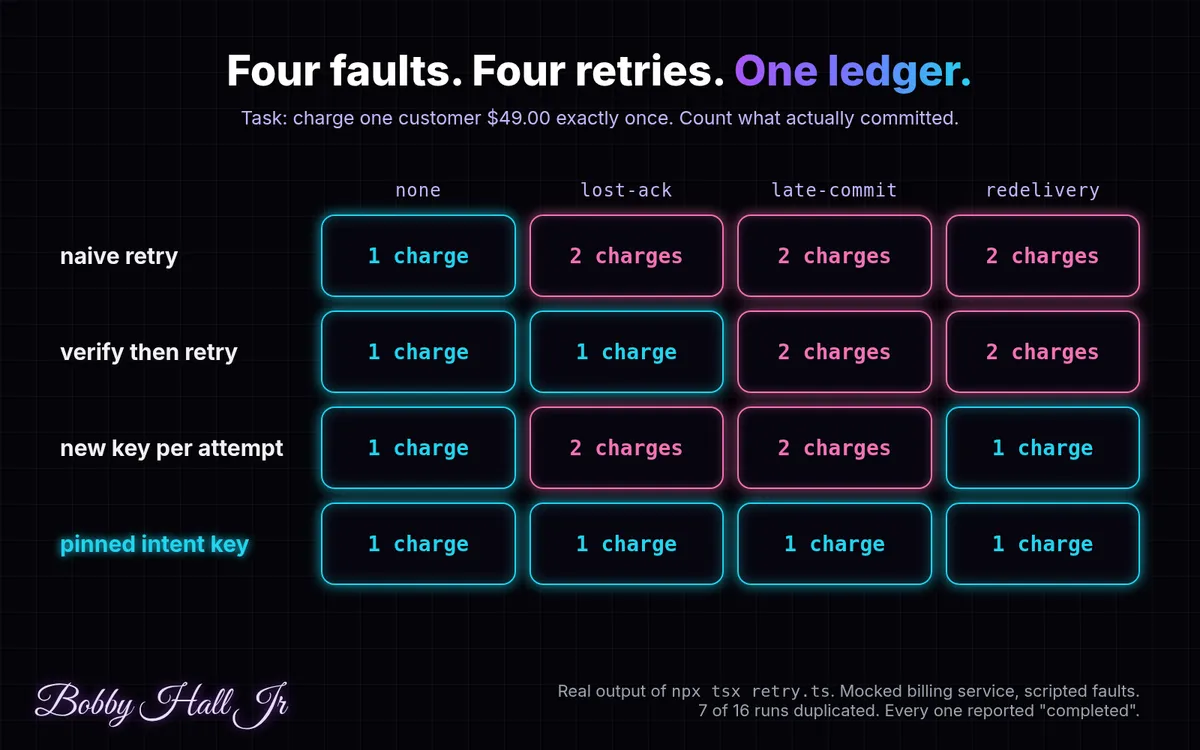
هنگام پیادهسازی این لایهها، استراتژیهای مختلف نتایج کاملاً متفاوتی در مواجهه با ناپایداری شبکه ایجاد میکنند. در یک ماتریس خطا با ۱۶ اجرا، ۷ مورد منجر به تکرار شد و تمام آنها توسط عامل به عنوان «تکمیل شده» گزارش شدند:
- تلاش مجدد ساده (Naive Retry): رایجترین پیادهسازی اولیه است. صرفاً تا زمان دریافت پاسخ موفقیت حلقه میزند. در ماتریس خطا، این استراتژی در
lost-ackوredeliveryشکست میخورد و منجر به کسر وجه تکراری میشود که عامل آن را «تکمیل شده» گزارش میکند. - تأیید سپس تلاش (Verify-then-Retry): این استراتژی سعی میکند قبل از تلاش مجدد، دفتر کل را بخواند. در حالی که مشکل
lost-ackرا حل میکند، درlate-commitشکست میخورد. بررسی دفتر کل قبل از اینکه تراکنش در حال سفر واقعاً به سرور برسد انجام میشود، بنابراین عامل گمان میکند تراکنش هرگز رخ نداده و تلاش دوم (تکراری) را تحریک میکند. - کلید جدید برای هر تلاش: همانطور که در مقاله مایکروسافت ذکر شد، این یک شکست بحرانی است. با تغییر کلید برای هر تلاش (مثلاً
task-42-retry1)، عامل بررسی Idempotency سرور را کاملاً دور میزند و با هر تلاش مجدد به عنوان یک قصد کاملاً جدید برخورد میکند. - کلید قصد ثابت (Pinned Intent Key): تنها استراتژی است که در برابر تمام خطاها پایدار میماند. چون کلید از «قصد» (تسک + ابزار + آرگومانها) مشتق شده است و نه از شماره تلاش، سرور میتواند تکرار را فارغ از زمان رسیدن یا تعداد دفعات ارسال شناسایی کند.
محدودیتهای دنیای واقعی
اگرچه منطق درست است، اما پیادهسازی به API خارجی وابسته است. مقاله مایکروسافت اشاره کرد که در تستهای قرارداد بومی آنها، تنها ۲ مورد از ۱۱ مسیر نوشتنی غیر-Idempotent، واقعاً کلید Idempotency را پذیرفتند. این نشان میدهد که بسیاری از APIهای دنیای واقعی هنوز برای اتوماسیون عاملمحور آماده نیستند. این چالشهای زیرساختی در کنار مسائل مربوط به تأخیر در پاسخدهی، باعث میشود که بازسازی مداوم پرامپتها به یکی از گلوگاههای اصلی سرعت عاملها تبدیل شود و بهرهوری سیستم را کاهش دهد.
چند نقطه شکست دیگر نیز وجود دارد که باید در نظر گرفت:
- انقضای کلید: استرایپ اشاره میکند که کلیدها ممکن است بعد از ۲۴ ساعت پاک شوند. تلاش مجدد بعد از این بازه زمانی، به عنوان یک درخواست جدید تلقی میشود.
- دروغهای تأییدی: بررسیهای ساده دفتر کل (تطبیق بر اساس مشتری و مبلغ) میتواند شکست بخورد. یک مشتری ممکن است واقعاً دو تراکنش جداگانه ۴۹ دلاری داشته باشد. تأیید باید بر اساس کلید یا یک شناسه تجاری (Business ID) باشد.
- تلاشهای مجدد شفاف (Transparent Retries): مقاله اندازهگیری کرد که تلاشهای مجدد شفاف در سمت کلاینت، نرخ موفقیت Exactly-Once را از ۷۲٪ به ۵۰٪ کاهش داد. تلاشی که مدل هرگز نمیبیند، تلاشی است که هیچکس درباره آن استدلال نمیکند.
- وضعیت نامعلوم: وقتی کلیدی وجود ندارد و مسیر خواندن قابل اعتمادی در دسترس نیست، تنها پاسخ صادقانه «نمیدانم» است. در این موارد، سیستم باید موضوع را به انسان ارجاع دهد.
ایده بزرگتر
این چرخش در معماری به این معناست که مدل «قصد» را ارائه میدهد، اما چارچوب «هویت» را تعیین میکند. جریان به این شکل است:
مدل $\rightarrow$ «کسر ۴۹ دلار از acme» $\rightarrow$ چارچوب $\rightarrow$ تولید کلید قصد (تسک + ابزار + آرگومانها) $\rightarrow$ ابزار $\rightarrow$ بررسی کلید (بازپخش یا اجرا) $\rightarrow$ دفتر کل $\rightarrow$ ثبت دقیقاً یک تراکنش
با جداسازی این دو، توسعهدهندگان میتوانند کارکنان AI با مسئولیتهای واقعی بسازند که در اثر یک نوسان شبکه، کاربرانشان را ورشکست نکنند. تلاش مجدد رایگان است، اما تکرار هزینه دارد.
من Roster را حول همین ایده میسازم: کارکنان AI با مسئولیتهای واقعی، ابزارها، حافظه، برنامههای زمانی و دسترسی به کامپیوتر. آنها در یک مسیر مشخص کار میکنند و هر اقدامی که انجام میدهند در لاگی ثبت میشود که میتوانید بررسی کنید. اگر پیگیریهای تکراری، تحویل کارها و حلقههای انتظار هفته شما را میبلعد، آنها را به یک کارمند AI بسپارید. Roster را امتحان کنید $\rightarrow$
گام بعدی شما
- در تعریف ابزارهای (Tool Definitions) خود، فیلد
idempotency_keyرا اجباری کنید و آن را در لایه Harness تولید کنید، نه در پرامپت مدل. - برای تراکنشهای حساس، مکانیزم «تأیید قبل از تلاش مجدد» را با استفاده از شناسههای تجاری (Business ID) پیادهسازی کنید.
- در مواردی که API مقصد از Idempotency پشتیبانی نمیکند، هرگونه تلاش مجدد خودکار را حذف و سیستم را به حالت تایید انسانی (Human-in-the-loop) ببرید.
اما داستان سختافزاری این تحول حتی شگفتانگیزتر است — به تحلیل ما دربارهی تراشههای Blackwell مراجعه کنید.



گفتگو