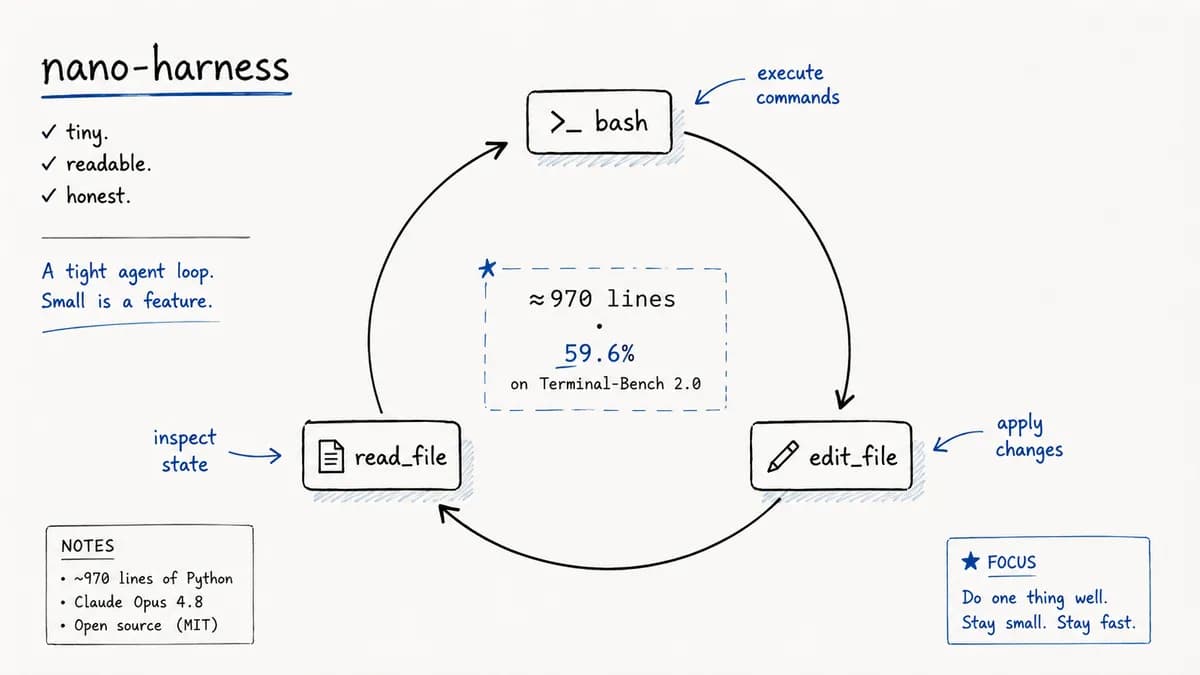
تصور کنید یک برنامهنویس بخواهد پیچیدگیهای عظیم عاملهای هوش مصنوعی را کنار بزند و فقط با ۹۶۷ خط کد پایتون (خطوط غیر-خالی)، سیستمی بسازد که واقعاً کار کند. اگر امروز در حال توسعه ابزارهای خودکارسازی کد هستید، باید بدانید که گاهی حذف ویژگیهای اضافی، مؤثرتر از افزودن آنهاست.
در ۲۱ جولای ۲۰۲۶، توسعهدهندهای به نام تروی لورنتس (Troy Lorents) نتایج پروژهای به نام nano-harness را منتشر کرد تا نشان دهد یک چارچوب مینیمال و خوانا میتواند اعداد قابلتوجهی در بنچمارکها ثبت کند. طبق گزارش منتشر شده در dev.to، این سیستم با استفاده از مدل Claude Opus 4.8 توانست به نرخ موفقیت ۵۹.۶ درصد در مجموعه آزمونهای Terminal-Bench 2.0 دست یابد. این دستاورد در حالی است که رقابت میان مدلهای کدنویسی برای رسیدن به تعادل میان کیفیت و هزینه شدت گرفته و مدلهایی نظیر Qwen3-Coder-30B تلاش میکنند در این میدان بر رقبایی چون DeepSeek پیشی بگیرند.
بسیاری از پروژههای فعلی روی ویژگیهای پیچیدهای مثل گرافهای ارکستراسیون (Orchestration Graphs)، سیستمهای حافظه یا داشبوردهای رابط کاربری (UI Dashboards) تمرکز کردهاند. این افزودنیها اغلب مهندسی اصلی «هارنس» (Harness) — یعنی همان حلقه و ابزارهایی که یک عامل هوش مصنوعی را در حال اجرا و صادق نگه میدارند — را میپوشانند و پنهان میکنند. لورنتس با الهام از رویکرد آندری کارپاتی در پیادهسازیهای مینیمال، به دنبال یافتن بیشترین میزان «امتیاز به ازای هر خط کد» بود.
این پروژه در واقع یک عامل (Agent) — شبیه به دستیاری است که نه تنها دستور میگیرد، بلکه خودش ابزارها را اجرا کرده و نتیجه را میبیند — است که بر پایه یک حلقه ساده و سه ابزار اصلی بنا شده است:
- bash: یک پوسته (Shell) پایدار که وضعیت محیط (Environment State) و مسیر جاری (Working Directory) را بین فراخوانیهای مختلف حفظ میکند.
- read_file: ابزاری برای خواندن فایلها با شماره خط که از برش (Slicing) برای خواندن بخشهای خاصی از فایل پشتیبانی میکند.
- edit_file: ابزاری برای جایگزینی دقیق رشتههای متنی بر اساس تطبیق منحصربهفرد.
بر اساس مستندات پروژه، این چارچوب دو هدف اصلی دارد: «زنده نگه داشتن» اجرا (Keeping it alive) و «صادق نگه داشتن» آن (Keeping it honest). «زنده نگه داشتن» شامل تلاش مجدد هنگام شکستهای API، کوتاه کردن تاریخچه برای جلوگیری از سرریز پنجره متنی (Context Window) — که مثل میز کاری است که فقط جای چند ورق دارد، نه کل کتابخانه — و بازگرداندن پوستههایی (Shells) است که در وضعیت معلق (Hang) قرار گرفتهاند. «صادق نگه داشتن» بر محور یک «دروازه تأیید» (Verify Gate) میچرخد؛ این دروازه اولین سیگنال «تمام شد» (Done) را به چالش میکشد و مدل را مجبور میکند دوباره تکلیف را بخواند و موفقیت خود را با شواهد استخراج شده از ابزارها ثابت کند.

لورنتس این سیستم را از طریق Harbor و در ۸۹ مسئله مجزا، که هر کدام در یک کانتینر داکر ایزوله شده بود، آزمایش کرد. روند پیشرفت امتیازات نشان میدهد که پالایش و سختسازی (Hardening) سیستم چه تأثیری بر عملکرد دارد:
- Haiku 4.5 (در یک برش ۱۰ مسئلهای): ۲۰٪
- Opus 4.8 (در یک برش ۱۰ مسئلهای): ۷۰٪
- Opus 4.8 + دروازه تأیید (در یک برش ۱۰ مسئلهای): ۸۰٪
- Opus 4.8 (پیش از سختسازی) (در تمام ۸۹ مسئله): ۵۳.۹٪
- Opus 4.8 (پس از سختسازی) (در تمام ۸۹ مسئله): ۵۹.۶٪
این اجرای نهایی ۱۶.۵ ساعت زمان برد و حدود ۴۵ دلار هزینه استنتاج (Inference) داشت. این هزینه بر اساس مصرف ۳ میلیون توکن با نرخهای جولای ۲۰۲۶ (۵ دلار برای هر میلیون توکن ورودی و ۲۵ دلار برای هر میلیون توکن خروجی) محاسبه شده است.
نقطه عطف این پروژه زمانی رخ داد که از GPT Sol 5.6 برای انجام یک بازبینی کد (Code Review) خصمانه روی هارنس استفاده شد. مدل به این کد امتیاز ۴ از ۱۰ داد و یک نقص حیاتی را شناسایی کرد: ابزار bash خروجی را میگرفت اما وضعیت خروج (Exit Status) یا همان Exit Code را نادیده میگرفت. این یعنی یک مجموعه تست شکستخورده، برای مدل مانند یک موفقیت به نظر میرسید و «دروازه تأیید» را عملاً میشکست.
لورنتس برای رفع حدود ۲۰ باگ واقعی، یک «گاندول» (Gauntlet) شامل سه مرحله بازبینی مستقل اجرا کرد. اصلاحات فنی کلیدی شامل موارد زیر بود:
- وضعیت غیرصفر پوسته (Nonzero shell status) اکنون بهدرستی باعث ایجاد خطای ابزار میشود.
- ابزار edit_file اصلاح شد تا بیتهای اجرایی (Executable bits) را در کانتینرهای لینوکس حفظ کند و پیوندهای نمادین (Symlinks) را بدون جایگزینی آنها مدیریت نماید.
- سیستمهای کشتن درخت-پروسه (Process-tree killers) اضافه شدند تا از تجمع پوستههای زامبی در زمان وقوع Time-out جلوگیری شود.
- کوتاه کردن متن (Context-truncation) در تمام نقاط ذخیرهسازی فراخوانی ابزارها همگامسازی شد تا از تورم مخفی آرگومانها (Silent re-inflation) جلوگیری شود.
نتیجه این سختسازی، افزایش ۵.۷ درصدی دقت بود و نرخ موفقیت را از ۵۳.۹٪ به ۵۹.۶٪ رساند. هرچند این اصلاحات حدود ۱۸۰ خط کد اضافه کرد، اما توسعهدهنده اشاره کرد که مهمترین بهبود از این حاصل شد که «شکست، شبیه شکست به نظر برسد». وقتی چارچوب دیگر درباره نتایج دستورات دروغ نمیگفت، توانایی مدل در تصحیح خودکار (Self-correction) افزایش یافت. این نوع سختسازی فنی، شباهت زیادی به رویکردهای امنیتی دارد که در ۵ حفاظ فنی برای جلوگیری از تخریب مخازن کد توسط عاملهای هوش مصنوعی برای کنترل رفتارهای خودمختار مدلها پیشنهاد شده است.
هرچند سیستمهایی مثل Codex CLI + GPT-5.5 با ۸۲.۲٪ و WOZCODE + Opus 4.7 با ۸۰.۲٪ در صدر جدول رسمی Terminal-Bench 2.0 هستند، اما آن هارنسها شامل هزاران خط کد هستند. nano-harness به عنوان یک اثبات مفهوم (Proof of Concept) نشان داد که یک پیادهسازی خوانا و بازمتن (تحت لایسنس MIT) میتواند از طریق مدیریت دقیق خطاها، به نتایج این سیستمهای پیچیده نزدیک شود یا با آنها رقابت کند.
این تجربه نشان میدهد که وظیفه اصلی چارچوب یک عامل، «هوشمند بودن» نیست (چون هوش بر عهده مدل است)، بلکه حفظ محیط اجرا و تحمیل سختگیرانه حقیقت خروجی است. برای توسعهدهندگان، این یعنی ارزشمندترین بهینهسازیها، نه افزودن ویژگیهای جدید، بلکه حذف «شکستهای خاموش» در حلقه ابزارهاست.
شما میتوانید مجموعه کامل ۸۷ تست و سوابق هر مسئله را با کلون کردن مخزن پروژه در github.com/TroyJLorents-GH/nano-harness بررسی کنید تا ببینید آیا «باگ شماره ۲۱» هنوز در کد مخفی شده است یا خیر.
گام بعدی شما
- مخزن پروژه را در github.com/TroyJLorents-GH/nano-harness کلون کنید تا ساختار مینیمال ابزارهای bash و edit_file را بررسی کنید.
- در پروژههای خود، بررسی کنید که آیا ابزارهای شما وضعیت خروج (Exit Code) را به مدل گزارش میدهند یا فقط متن خروجی را میفرستند.
- از یک مدل استدلالی قویتر برای بازبینی کد (Code Review) چارچوبهای اجرایی خود استفاده کنید تا شکستهای خاموش را بیابید.
اما تأثیر این رویکرد بر کاهش هزینههای توکن در مقیاس صنعتی موضوع دیگری است — در تحلیل ما درباره استراتژیهای کاهش هزینه استنتاج بیشتر بخوانید.



گفتگو