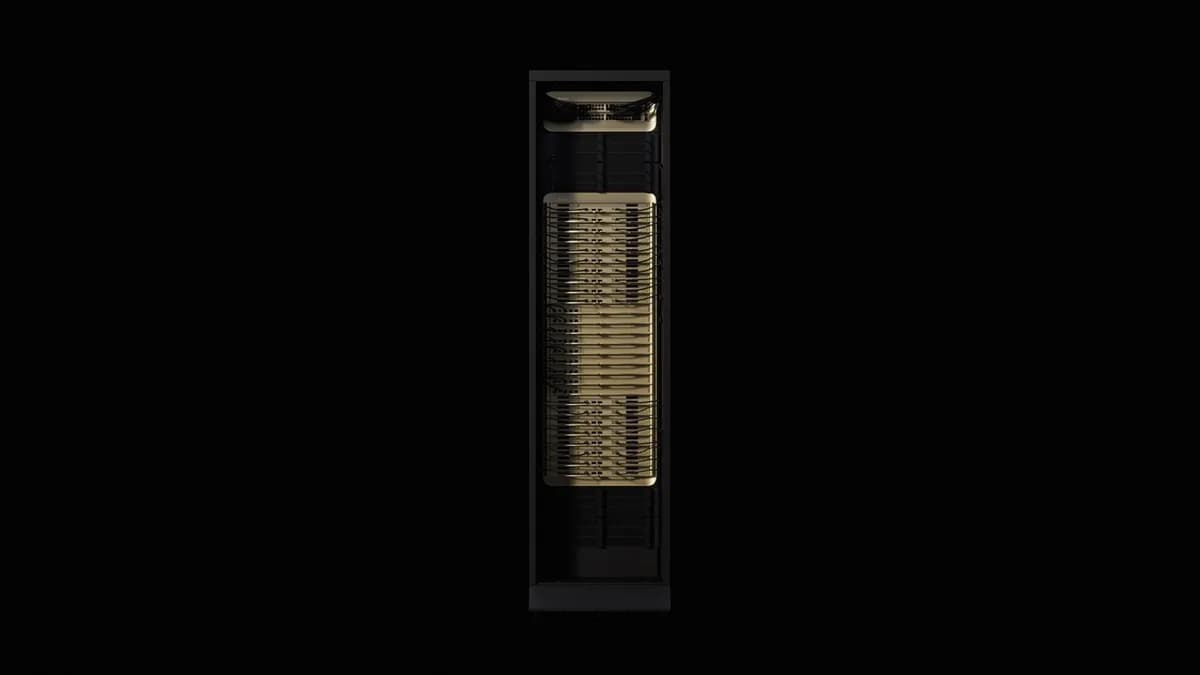
استقرار Vera Rubin در Azure میتواند استنتاج را ۲.۵ برابر سریع کند. این همکاری، آیندهٔ محاسبات سازمانی را برای عاملمحور تغییر میدهد.
قبل از این، مایکروسافت و انویدیا در یک پروژهٔ مشترک هوش مصنوعی کار میکردند. در ۱۹ نوامبر ۲۰۶، در جریان Microsoft Ignite، این همکاری گسترش یافت. هدف، اجرای سریعتر مدلهای بزرگ در محیطهای سازمانی بود.
مدل زبانی بزرگ (LLM) — مثل کتابخانهداری که میلیاردها صفحه را خوانده و حالا با همان لحن کتابها جواب میدهد — اکنون میتواند در Azure پاسخ دهد. به نقل از انویدیا، این سامانهها برای استدلال، عامل و آموزش بزرگ طراحی شدهاند.
Azure نسخهٔ آزمایشی Vera Rubin NVL72 را ارائه داد. این سامانه برای محاسبات پیچیده ساخته شده است. به گزارش مایکروسافت، این امکان را میدهد تا مدلها بدون بازسازی خط لولهٔ توسعه به تولید بروند.
Vera Rubin برقی طراحی شده و برای آموزش و استنتاج زیاد مناسب است. Nemotron مدلهای باز هستند. Foundry پشتیبانی از این مدلها را افزایش داد.
محاسبات رمزنگاری هم بخش دارد. انویدیا خدمات محاسبات رمزنگاری و تأیید را دارد. مشتریان میتوانند یکپارچگی محیط را بررسی کنند. مایکروسافت از این امکان در Foundry استفاده میکند.
انرژی یکی از محورهای کلیدی است. انویدیا از فناوری MaxLPS استفاده میکند. این فناوری میتواند مصرف توان را بالا ببرد. مایکروسافت از NVIDIA Dynamo برای آموزش استفاده میکند. این سامانه مدل را مدیریت میکند.
برای توسعهدهندگان، Foundry Managed Compute امکان اجرای مدلهای سفارشی را فراهم میکند. این کار تنظیم دقیق (Fine-tuning) را ممکن میسازد. مثل وقتی به یک پزشک عمومی، تخصص پوست میدهیم؛ مدل کلی است، روی یک حوزه دقیق میشود.
این همکاری استراتژیک است. به نظر ما، این اقدام به پلتفرمهای کامل هوش مصنوعی اشاره دارد. شرکتها سختافزار، محاسبات و خدمات را یکجا میکنند.
مشاوران انتظار دارند زمان نتیجه کمتر شود. به گزارش انویدیا، بهبود تا ۲.۵ برابر در هر وات است. مایکروسافت گزارش میدهد که تأخیر پایانبهپایان ۳۰٪ کم شد.
این همکاری شامل RTX PRO 6000 Blackwell نیز میشود. این کار برای جستجوی Bing استفاده میشود. این نشان میدهد انویدیا در زنجیرهٔ مایکروسافت گسترده است.
برنامهٔ Foundry شامل آموزش برنامهنویسی بدون سرویس است. این کار کنترل دقیق دارد. مایکروسافت مدلهای سفارشی را اجرا میکند.
این اتحاد سیاست راهبردی است. به گزارش انویدیا، سامانههای Vera Rubin در Azure نخستین بار است. این سرویس در خانه ساخته شده است.
بنابراین، NVIDIA و Microsoft در حال ساختن است. این پروژه برای تیمهای سازمانی اهمیت دارد. این همکاری میتواند سرعت را بالا ببرد.
جزئیات
Vera Rubin NVL72 در مراکز داده Azure به صورت ماشینهای مجازی عرضه میشود. معماری NVL72 برای استدلال، برنامههای عاملمحور و آموزش و استنتاج مقیاس بزرگ ساخته شده است. یکپارچگی این سیستمها در بافت محاسبه Azure به توسعهدهندگان اجازه میدهد بدون بازسازی خط لوله از توسعه مدل به تولید بروند. پیشنمایش شامل افزونههای محاسبه محرمانه است که دادههای مالکیت و بارهای تنظیمشده را در سطح سختافزار و راک محافظت میکند. خدمات محاسبه محرمانه و گواهی NVIDIA به مشتریان امکان میدهد یکپارچگی محیط اجرا را قبل از انتشار مدلهای حساس، دادهها یا کلیدهای رمزنگاری تأیید کنند. کارهای جاری هدف دارد این حفاظتها را بر روی زیرساختهای کارخانه هوش مصنوعی متصل گسترش دهد.
فناوری MaxLPS از NVIDIA برای افزایش کارایی انرژی در مراکز داده به کار میرود. این تکنولوژی به استخراج عملکرد بیشتر در هر وات کمک میکند و محدودیتهای توانایی کارخانههای هوش مصنوعی را کاهش میدهد. واحد هوش مصنوعی Microsoft از NVIDIA Dynamo برای استنتاج رولاوت تقویت یادگیری در مرحله پس از آموزش استفاده میکند. این مرحله محاسبهمحور تجربه تولید میکند تا مدلها را بهینه کند. Dynamo استنتاج را در ناوگان عظیم GPU هماهنگ میکند، تدفق را بهینه میکند، مسیریابی درخواست، بهروزرسانی مدل و بازیابی خطا را در استقرار مشترک مدیریت میکند. همچنین Microsoft از کارتهای گرافیکی RTX PRO 6000 Blackwell برای تسریع مدلهای جستجوی Bing بهره میبرد که گستردگی سیلیس NVIDIA در پورتفوی Microsoft را نشان میدهد.
Foundry ارائه Programmed Training بدون سرور کنترل دقیق بر روی گردش کار پس از آموزش را با انتزاع زیرساخت فراهم میکند. Foundry Managed Compute اکنون استقرار مدلهای Nemotron سفارشی را پشتیبانی میکند تا سازمانها بتوانند پایههای باز را روی دادههای مالکیت خود تنظیم دقیق کنند بدون مدیریت خوشه. مسیرهای جدید استقرار در محل و لبه انعطافپذیری اجرا استنتاج را در نزدیکی منابع داده در تولید، بهداشت و خردهفروشی میدهد.
تحلیلگران انتظار دارند نقشه راه مشترک زمان تا ارزش برای استقرار مدلهای زبانی بزرگ را کوتاه کند و پذیرش هوش مصنوعی عاملمحور در صنایع تنظیمشده را تسریع نماید. با تداوم هممهندسی سیلیس، نرمافزار سیستم و خدمات ابری، این شراکت معیار جدیدی برای زیرساخت هوش مصنوعی سازمانی تعیین میکند.
ناظران صنعت اشاره میکنند که یکپارچهسازی Vera Rubin NVL72 در Azure نخستین بار است که یک پلتفرم شتابدهنده مقیاس راک و خنکسازی مایع به عنوان سرویس بومی ابری عرضه میشود که میتواند سرمایهگذاری اولیه شرکتهایی که قبلاً کارخانههای هوش مصنوعی سفارشی میساختند را کاهش دهد. دادههای اولیه معیاردهی NVIDIA نشان میدهد تا ۲.۵ برابر بهبود در توکن بر ثانیه در هر وات نسبت به نسل قبلی Hopper. Microsoft گزارش میدهد ۳۰ درصد کاهش تأخیر پایانبهپایان برای گردش کار عاملمحور که مدلهای زبانی را با موتورهای تصمیمگیری بیدرنگ ترکیب میکنند. شراکت به ابزارهای نرمافزاری نیز گسترش یافته: یک SDK مشترک APIهای یکپارچه برای چکپوینتگذاری مدل، هماهنگی آموزش توزیعشده و تأمین انکلایو امن را فراهم میکند تا توسعهدهندگان یک بار بنویسند و در ابری، لبه و در محل استقرار دهند. شرکتها به یک کادانس نوآوری مشترک سهماهه متعهد شدهاند که خانوادههای جدید Nemotron بهینه برای وظایف عمودی مانند تحلیل تصویر پزشکی، مدلسازی ریسک مالی و کنترل رباتیک خودمختار را تحویل میدهد. این نقشه راه با فشار روزافزون تنظیمگرانه برای زنجیره تأمین هوش مصنوعی شفاف همسو است و افزونههای محاسبه محرمانه انتظار میرود الزامات آییننامه هوش مصنوعی اتحادیه اروپا برای سیستمهای پرریسک را برآورده کند. با تسریع پذیرش هوش مصنوعی مولد و عاملمحور توسط شرکتها، پشته ترکیبی NVIDIA-Microsoft خود را به عنوان استاندارد پیشفرض برای زیرساخت هوش مصنوعی امن، مقیاسپذیر و آگاه از انرژی قرار میدهد.
زمینه
شراکت استراتژیک بین NVIDIA و Microsoft بر پایه همکاریهای قبلی در حوزه هوش مصنوعی بنا شده است. هر دو شرکت در توسعه سختافزار تخصصی، نرمافزار سیستم و خدمات ابری سرمایهگذاری کردهاند. گسترش این اتحاد نشاندهنده روند صنعت به سمت پلتفرمهای کامل است که سختافزار، محاسبه محرمانه و خدمات مدیریت شده را در یک بسته یکپارچه ارائه میدهند.
گام بعدی شما
- [خواننده باید برای Foundry امکان اجرای Nemotron را امتحان کند.]
- [توسعهدهندگان باید Vera Rubin را در Azure در نظر بگیرند.]
- [مدیران باید هزینهٔ انرژی را با MaxLPS بررسی کنند.]
گفتگو