
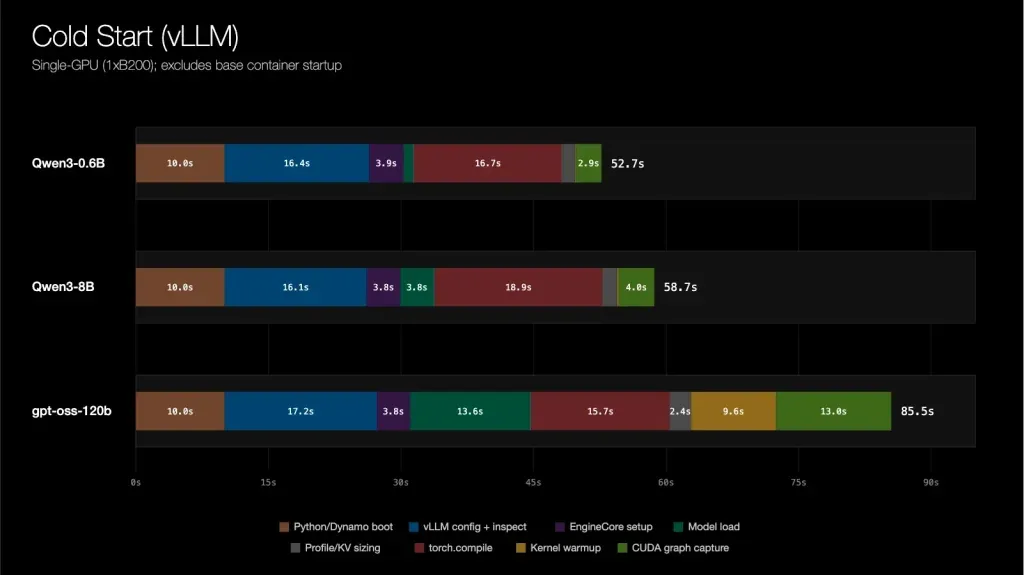
اگر مدیریت استقرار مدلهای هوش مصنوعی در مقیاس بزرگ روی کوبرنتیز (Kubernetes) را بر عهده دارید، با کابوس «استارت سرد» (Cold Start) آشنا هستید: دقایق طولانی که پردازندههای گرافیکی بدون هیچ فعالیتی منتظر میمانند تا کانتینرها دانلود و مدلها بارگذاری شوند، که این امر هم باعث اتلاف هزینه میشود و هم رعایت توافقنامههای سطح خدمات (SLA) را دشوار میکند. انویدیا (NVIDIA) با معرفی Dynamo Snapshot این مشکل را حل کرده است؛ سیستمی که اجازه میدهد کارکنان استنتاج (Inference Workers) را تقریباً بهصورت آنی «منجمد» و سپس «ذوب» کرد.
در محیطهای عملیاتی، تقاضا بهشدت نوسان میکند. برای مقیاسپذیری منعطف (Elastic Scaling)، سیستمها باید بتوانند سریعاً نسخههای جدیدی (Replicas) از مدل را فعال کنند. با این حال، یک استارت سرد استاندارد شامل زنجیرهای طاقتفرساست: دریافت تصاویر کانتینر، بارگذاری وزنها در حافظه GPU، گرم کردن هستههای CUDA و کامپایل گرافهای CUDA. برای یک مدل vLLM (نسخه v0.20.0) در یک GPU، این فرآیند اغلب چندین دقیقه زمان میبرد که در این مدت سختافزار هیچ توکنی تولید نمیکند و هیچ درخواستی را پاسخ نمیدهد. این تأخیر، ریسک نقض SLA را در زمان پیک ترافیک بهشدت افزایش میدهد، زیرا سیستم نمیتواند با سرعت کافی برای جذب افزایش ناگهانی تقاضا مقیاس یابد.
طبق گزارش فنی انویدیا، Dynamo Snapshot با استفاده از رویکرد «نقطه بازگشت/بازیابی» (Checkpoint/Restore)، کل این توالی را دور میزند. بهجای شروع از صفر، سیستم وضعیت دقیق یک Worker در حال اجرا را از یک اسنپشات بازیابی میکند و اجازه میدهد اجرا دقیقاً از همان دستورالعملی که منجمد شده بود، ادامه یابد؛ بهطوری که مدل اصلاً متوجه وقوع این فرآیند ثبت یا بازیابی نمیشود.
مکانیسم منجمد کردن و ذوب کردن
برای ثبت وضعیت یک Worker در حال اجرا، Dynamo Snapshot از دو ابزار اصلی برای مدیریت دامنههای مختلف حافظه استفاده میکند. وضعیت قابل ثبت یک Worker استنتاج شامل «وضعیت دستگاه» (Device State) و «وضعیت میزبان» (Host State) است:
- cuda-checkpoint: این ابزار وضعیت سمت GPU، شامل کانتکستهای CUDA، استریمها، حافظه دستگاه و نگاشتهای آدرس مجازی را سریالسازی میکند. چون این وضعیت برای میزبان (Host) قابل مشاهده نیست،
cuda-checkpointاز قابلیتهای درایور CUDA استفاده میکند تا وضعیت دستگاه را در حافظه CPU مربوط به پردازشی که مالک هر کانتکست CUDA است، تخلیه (Dump) کند. - CRIU (Checkpoint/Restore in Userspace): این ابزار وضعیت سمت میزبان را مدیریت میکند. CRIU با بررسی دفتر کل هسته لینوکس، وضعیت درخت پردازش — شامل حافظه CPU، رشتهها (Threads)، توصیفگرهای فایل و فضای نامها (Namespaces) — را روی دیسک سریالسازی میکند.
این فرآیند ترتیب دقیقی دارد. در مرحله ثبت (Checkpointing)، ابتدا cuda-checkpoint وضعیت GPU را به حافظه CPU منتقل میکند و سپس CRIU تمام وضعیت درخت پردازش میزبان را در یک پوشه در فضای ذخیرهسازی میریزد. هنگام بازیابی در همان گره یا گرهی دیگر، ابتدا CRIU درخت پردازش را از ذخیرهساز توزیعشده (مانند NFS یا SMB) بازسازی میکند و سپس cuda-checkpoint وضعیت GPU را از آنچه اکنون در حافظه CPU قرار دارد، به GPUهای جدید منتقل میکند.
یکپارچگی با کوبرنتیز از طریق snapshot-agent
انویدیا این قابلیت را از طریق یک snapshot-agent (به صورت DaemonSet) پیادهسازی کرده که با Helm Chart نصب میشود و دسترسی Privileged دارد. این عامل روی هر گره اجرا شده و بدون نیاز به تغییر در خودِ runc، عملیات ثبت و بازیابی کانتینرهای مدیریت شده توسط runc را مدیریت میکند.
جزئیات گردش کار این عامل به شرح زیر است:
- فاز ثبت (Checkpoint Phase): عامل منتظر میماند تا Probe آمادگیِ Workload فعال شود، سپس
cuda-checkpointو CRIU را از سمت میزبان فراخوانی کرده و آرتیفکت (Artifact) حاصل را در ذخیرهساز مشترک مینویسد. از آنجایی که اسنپشاتهای CRIU حاوی ارجاعاتی به لایه فایلسیستم قابل نوشتن کانتینر هستند، عامل همچنین هر فایلی که پس از مرحله CRIU در لایه Overlay FS کانتینر ایجاد یا حذف شده باشد را ثبت میکند. - فاز بازیابی (Restore Phase): عامل یک Pod کمحجم به عنوان جایگاه (Placeholder) اجرا میکند، فایلسیستم Overlay را بازیابی میکند و سپس اسنپشات CRIU/CUDA را در فضای نامهای (Namespaces) مربوطه بازمیگرداند.
- موازیسازی: هر عامل بهطور مستقل روی گره محلی خود عمل میکند، که باعث میشود عملیات ثبت و بازیابی در سطح کلاستر بهطور طبیعی موازی شوند.
این رویکرد DaemonSet به سه دلیل بر پشتیبانی بومی کوبرنتیز از Checkpoint/Restore در runc ترجیح داده شد: اول، کاملاً قابل انتقال (Portable) است و به Feature Gateهای ارائهدهندگان ابری وابسته نیست؛ دوم، کنترل دقیقتری روی CRIU برای تنظیمات عملکردی (Performance Tuning) فراهم میکند؛ و سوم، اجازه میدهد آرتیفکتهای اسنپشات در بکاندهای ذخیرهسازی منعطف قرار گیرند، بهجای آنکه در تصاویر OCI جاسازی شوند.
حل مشکل اتصالات: قلابهای Quiesce/Resume
یک مانع بزرگ این است که CRIU نمیتواند اتصالات فعال TCP را ثبت کند. اگر اسنپشاتی بعد از اتصال Worker به صفحه کنترل (Control Plane) گرفته شود، Worker بازیابیشده دارای یک سوکت «مرده» خواهد بود.
انویدیا این مشکل را با تقسیم مقداردهی اولیه Worker به دو فاز منظم حل کرد:
۱. مقداردهی اولیه موتور (Engine Initialization): ارتباطگرها (Communicators) مقداردهی میشوند، وزنها بارگذاری میگردند، هستهها گرم شده و گرافهای CUDA کامپایل میشوند. در این مرحله مدل کاملاً «گرم» است اما هنوز در خارج از Pod قابل شناسایی نیست.
۲. راهاندازی زمان اجرای توزیعشده (Distributed Runtime Startup): Worker به صفحه کنترل Dynamo متصل شده و خود را در بکاند شناسایی (Discovery Backend) ثبت میکند. اتصالات TCP باز از این لحظه به بعد برقرار میشوند.
مکانیسم Quiesce/Resume
برای جلوگیری از ثبت سوکتهای فعال، Worker بعد از مقداردهی اولیه موتور و قبل از شروع زمان اجرای توزیعشده، یک فایل سیگنال «آماده برای ثبت» (ready for checkpoint) مینویسد. سپس Worker وارد یک حلقه نظارتی (Polling Loop) میشود و منتظر فایل سیگنال «بازیابی کامل» (restore complete) میماند، در حالی که عامل اسنپشات بهطور خارجی از آن ثبت را انجام میدهد.
چون CRIU اجرا را دقیقاً از همان دستورالعملی که ثبت رخ داده بازمیگرداند، Worker مستقیماً داخل این حلقه نظارتی بیدار شده، فایل سیگنال را شناسایی میکند و بدون نیاز به همگامسازی اضافی، مقداردهی اولیه زمان اجرای توزیعشده را ادامه میدهد. این الگو برای اسنپشاتهای برنامهریزی شده در چند GPU و چند گره نیز حیاتی است، زیرا اتصالات TCP خروجی برای RPC به دلیل تغییر IPهای Pod قابل ثبت نیستند و ثبتهای RDMA و وضعیت NIC باید پس از بازیابی مجدداً ایجاد شوند.
بهینهسازی اول: حذف نگاشت KV Cache
بخش عظیمی از حافظه GPU یک مدل، بافر KV Cache است که موتورهای استنتاج آن را پس از جایگذاری وزنها و گرافهای CUDA از حافظه باقیمانده تخصیص میدهند. چون اسنپشاتها قبل از پاسخ به هر درخواستی گرفته میشوند، این بافر خالی است و نیازی به ذخیره ندارد.
با این حال، آدرس مجازی باید ثابت بماند زیرا در گراف CUDA تثبیت (Bake) شده است. انویدیا برای حل این موضوع از API مدیریت حافظه مجازی CUDA استفاده میکند:
- KV Cache از طریق
cuMemCreateوcuMemMapتخصیص مییابد. - حافظه فیزیکی با استفاده از
cuMemUnmapوcuMemReleaseآزاد میشود. - نکته حیاتی این است که
cuMemAddressFreeفراخوانی نمیشود تا محدوده آدرس مجازی دستنخورده باقی بماند.
این قابلیت بهصورت بومی در vLLM از طریق sleep() و wake_up() و در SGLang از طریق torch_memory_saver در دسترس است. در مدل Qwen3-0.6B روی GPU B200، این کار حجم آرتیفکت را از ۱۹۰ گیگابایت به تنها ۶ گیگابایت کاهش داد. این مزایا برای مدلهایی که وزنهای کوچکتری نسبت به کل اندازه GPU دارند، مشهودتر است.
بهینهسازی دوم: شتابدهی به بازیابی CRIU
حتی با آرتیفکتهای کوچکتر، بازیابی استاندارد CRIU برای مدلهای بزرگ بسیار کند بود؛ در برخی موارد، زمان بازیابی حتی از زمان استارت سرد بیشتر میشد. انویدیا دو بهینهسازی خاص را توسعه داد (که در حال حاضر در انتظار ادغام در CRIU اصلی هستند):
۲.۱ بازیابی موازی memfd
قابلیتهای sleep()/wake_up() در vLLM و torch_memory_saver در SGLang، تخصیصهای GPU برچسبگذاری شده به عنوان وزن را به بافرهای سایه (Shadow Buffers) پینشده در CPU منتقل میکنند. در هسته لینوکس، اینها به عنوان memfds ظاهر میشوند: فایلهای بدون نام و مبتنی بر RAM که با MAP_SHARED نگاشت شدهاند. برای مدل gpt-oss-120b، این بافرها بیش از ۱۲۰ گیگابایت حافظه را اشغال کرده بودند که بین بسیاری از بافرهای مستقل ۲ گیگابایتی یا کوچکتر تقسیم شده بود.
نسخه اصلی CRIU این بافرها را بهصورت سریال (ایجاد، تغییر اندازه، نگاشت، خواندن) بازیابی میکند. نسخه اصلاحشده انویدیا تمام اشیاء مبتنی بر shmem را شناسایی کرده و از یک Thread Pool برای بازیابی موازی آنها استفاده میکند تا از تمام پهنای باند ذخیرهساز و موازیسازی CPU بهره ببرد.
۲.۲ استفاده از AIO بومی لینوکس برای حافظه Anonymous
نسخه اصلی CRIU از یک حلقه preadv همگام با تنها یک عملیات خواندن در جریان استفاده میکند که باعث بیکار ماندن دستگاههای ذخیرهسازی بین درخواستها میشود. نسخه اصلاحشده از Linux Native AIO استفاده میکند:
- CRIU دستههایی از
iocbsرا از طریقio_submitارسال میکند. - یک پنجره لغزان (Sliding Window) تا ۱۲۸ خواندن همزمان را مدیریت میکند.
- تکمیل عملیات از طریق
io_geteventsمدیریت شده و ارسالهای جدید پنجره را پر میکنند. - در صورت پشتیبانی، خواندنها از
O_DIRECTبرای جلوگیری از فشار روی Page Cache استفاده میکنند. لازم به ذکر است که AIO تنها روی فایلهایO_DIRECTواقعاً ناهمگام است؛ در استقرارهای NFS بدونO_DIRECTسیستم به I/O بافره با readahead متوالی بازمیگردد که باعث کاهش دستاوردها میشود.
نتایج بهینهسازیهای CRIU
نتایج ترکیبی در سه مدل (پس از حذف نگاشت KV Cache) شتابهای قابل توجهی را به سمت «سرعت نور» (SOL) — یعنی حداکثر سرعت تئوریک بازیابی با توجه به پهنای باند ذخیرهساز — نشان میدهد:
- Qwen3-0.6B (۶.۲ گیگابایت): نسخه اصلی ۶.۸ ثانیه $\rightarrow$ AIO ۲.۹ ثانیه $\rightarrow$ AIO+memfd ۲.۴ ثانیه (شتاب ۲.۸ برابری؛ SOL ۰.۹۵ ثانیه).
- Qwen3-8B (۲۶ گیگابایت): نسخه اصلی ۲۴ ثانیه $\rightarrow$ AIO ۱۱ ثانیه $\rightarrow$ AIO+memfd ۴.۷ ثانیه (شتاب ۵.۱ برابری؛ SOL ۱.۸ ثانیه).
- gpt-oss-120b (۱۲۹ گیگابایت): نسخه اصلی ۱۱۹ ثانیه $\rightarrow$ AIO ۵۴ ثانیه $\rightarrow$ AIO+memfd ۱۵ ثانیه (شتاب ۷.۹ برابری؛ SOL ۱۱ ثانیه).
بهینهسازی سوم: سرویس حافظه GPU (GMS)
با وجود بهینهسازیهای CRIU، یک گلوگاه سریال باقی مانده بود: cuda-checkpoint نمیتواند حافظه GPU را بازیابی کند تا زمانی که CRIU تمام وزنها را بهطور کامل در حافظه میزبان مادی (Materialize) کند. برای شکستن این وابستگی، انویدیا GPU Memory Service (GMS) را ایجاد کرد.
GMS از API مدیریت حافظه مجازی CUDA (VMM) استفاده میکند تا وزنهای مدلهای بزرگ را از چرخه حیات پردازش Worker جدا کرده و آنها را به یک آرتیفکت مجزای GMS منتقل کند. این کار اجازه میدهد بازیابی وضعیت پردازش (CRIU) و بازیابی وزنها (GMS) بهطور همزمان و از طریق کانالهای پهنای باند حافظه متفاوت اجرا شوند. بازیابی وزنها اکنون میتواند از سریعترین مسیرهای موجود مانند GPUDirect Storage (GDS) یا RDMA/NVLink بین GPUها استفاده کند.
مقایسه اندازه آرتیفکت (پایه CRIU در مقابل GMS):
- Qwen3-0.6B: پایه ۶.۲ گیگابایت $\rightarrow$ ۴.۳ گیگابایت CRIU + ۱.۲ گیگابایت آرتیفکت GMS.
- Qwen3-8B: پایه ۲۶ گیگابایت $\rightarrow$ ۴.۸ گیگابایت CRIU + ۱۵ گیگابایت آرتیفکت GMS.
- gpt-oss-120b: پایه ۱۲۹ گیگابایت $\rightarrow$ ۶.۷ گیگابایت CRIU + ۷۴ گیگابایت آرتیفکت GMS.
در یک اثبات مفهوم (PoC) با استفاده از ۸ حافظه NVMe SSD موازی (Striped)، زمان استارت-آپ سرتاسری برای gpt-oss-120b به زیر ۵ ثانیه کاهش یافت؛ یعنی کاهش ۲۱ برابری نسبت به حالت پایه. (زمانهای بازیابی از یک برچسب زمانی مشترک اندازهگیری شده و استارت-آپ کانتینر را شامل نمیشود).
الزامات استقرار و محدودیتها
استقرار این سیستم شامل سه منبع کوبرنتیز است: DaemonSet مربوط به snapshot-agent (از طریق Helm)، منبع سفارشی DynamoCheckpoint (dckpt) برای تعریف پیکربندی مدل، و منبع سفارشی DynamoGraphDeployment برای بازیابی.
پیشنیازها (نسخه ۱.۱.۱):
- گرههای GPU با معماری x86_64 (amd64).
- درایور انویدیا ۵۸۰.xx به بالا (۵۹۰.xx برای اسنپشاتهای چند-GPU).
- ذخیرهساز ReadWriteMany برای بازیابی بین-گرهای.
شناسه اسنپشات (Checkpoint Identity): این شناسه یک هش SHA256 شانزده کاراکتری از فیلدهایی است که بر وضعیت زمان اجرا تأثیر میگذارند: مدل، backendFramework، نسخه dynamo، اندازه TensorParallel، اندازه PipelineParallel، نوع داده (dtype)، حداکثر طول مدل (maxModelLen) و پارامترهای اضافی. فیلدهایی مانند تعداد Replicaها و محدودیتهای منابع بر این هش تأثیری ندارند.
حالتهای استقرار:
۱. حالت صریح checkpointRef: ارجاع به یک DynamoCheckpoint آماده از طریق نام.
۲. حالت خودکار (Auto mode): اپراتور هش را محاسبه کرده و تنها در صورتی که تطابقی وجود نداشته باشد، اسنپشات ایجاد میکند (اولین Worker استارت سرد میزند و اسنپشات در پسزمینه برای موارد آینده ایجاد میشود).
محدودیتهای فعلی:
- پشتیبانی پیشنمایش محدود تنها برای Workerهای vLLM.
- عدم پشتیبانی از Workerهای تخصصی (Multimodal، Embedding، Diffusion).
- اعتبارسنجی محدود برای پیکربندیهای Tensor-Parallel در چند GPU.
- مسیر بازیابی GMS هنوز در دسترس نیست؛
snapshot-agentباید با دسترسی Privileged اجرا شود؛ و بازیابی نسبت به وضعیت زنده سوکتهای TCP حساس است.
این معماری تغییری بنیادین در نگاه ما به مقیاسپذیری هوش مصنوعی است. انویدیا با تبدیل یک مدل «گرم» به یک تصویر استاتیک (به جای پردازشی که باید بوت شود)، استنتاج هوش مصنوعی را به مقیاسپذیری آنیِ توابع Serverless نزدیک میکند. برای کسانی که این سیستم را پیاده میکنند، نقاط عطف بعدی، انتشار مسیر بازیابی GMS با بکاندهای قابل تعویض (GDS, UCX) و گسترش پشتیبانی برای TensorRT-LLM خواهد بود.



گفتگو