اگر امروز در حال طراحی زیرساختهای مرکز داده برای عاملهای هوش مصنوعی هستید، باید بدانید که قدرتمندترین پردازنده Arm بازار، با یک استراتژی بازاریابی متناقض همراه شده است. NVIDIA Vera یک غول پردازشی واقعی است، اما پایه و اساس معرفی رسمی آن بر توهمات فنی بنا شده است. در حالی که دادههای مستقل اولیه نشان میدهد این تراشه پرفورمنسترین پردازنده سرور Arm است که تاکنون در تستهای عمومی دیده شده، مستندات فنی ۴۵ صفحهای انویدیا که در ۲۱ ژوئیه ۲۰۲۶ منتشر شد، تلاش میکند این دستاوردها را از طریق بصریسازی گمراهکننده دادهها، به یک پیروزی اخلاقی و فنی بر معماری x86 تبدیل کند.
این تنش در حالی رخ میدهد که نبرد برای مراکز داده هوش مصنوعی از GPUها به سمت CPUهایی منتقل شده است که آنها را تغذیه میکنند. سالهاست که غولهای x86 مانند AMD و Intel بر فضای سرور تسلط دارند، اما انویدیا اکنون با هسته Olympus در تلاش است تا کل پشته سختافزاری را به صورت عمودی یکپارچه کند. هدف، ایجاد یک خط لوله یکپارچه است که در آن CPU منطق پیچیده و مراحل محیطی عاملها (AI Agents) را مدیریت کرده و دادهها را بدون ایجاد گلوگاه به شتابدهندههای GPU میرساند.
همانطور که در تحلیلهای پیشین ما دربارهی استراتژی یکپارچگی سختافزاری انویدیا اشاره کردیم، این شرکت تمایل دارد اکوسیستم بسته خود را به قیمت حذف رقبا گسترش دهد.
معماری هسته Olympus
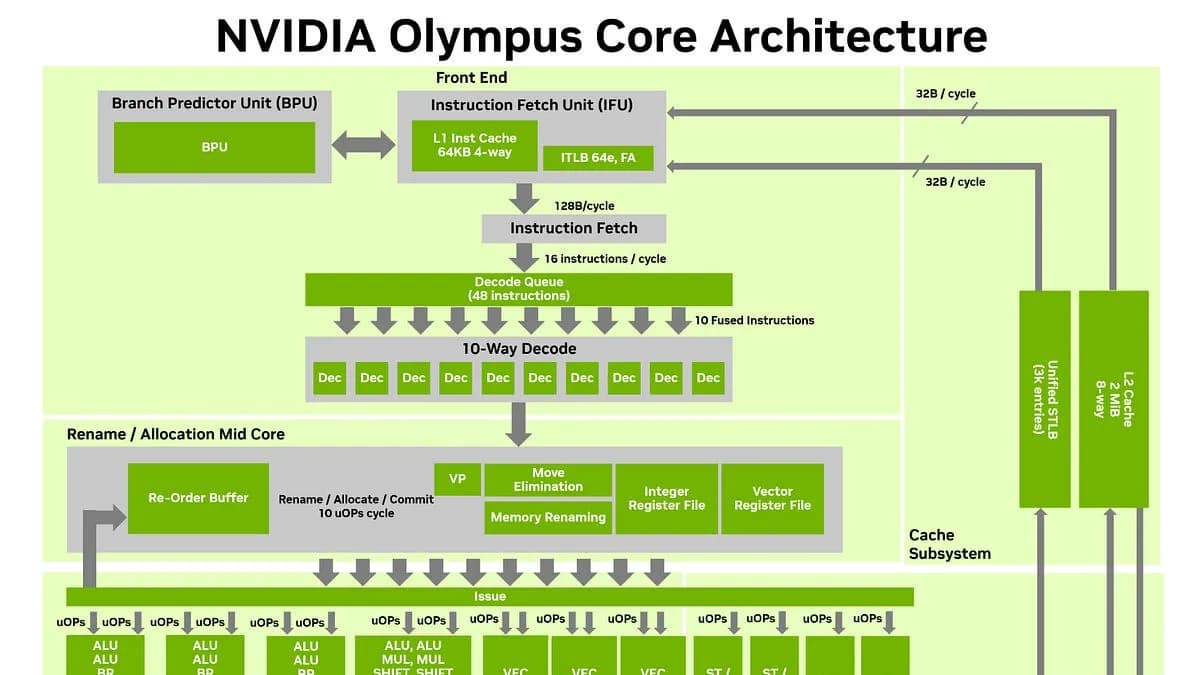
قلب تپنده Vera هسته Olympus است؛ یک طراحی Arm v9.2 با قابلیت اجرای ۱۰ دستور در هر چرخه (10-wide out-of-order). این هسته برای توان عملیاتی (Throughput) عظیم ساخته شده و دارای بخش Front-end است که قادر به رمزگشایی (Decoding) ده دستور در هر چرخه و مدیریت حداکثر دو شاخه (Branch) پذیرفتهشده در هر چرخه است.
مشخصات فنی کلیدی عبارتند از:
- دای سختافزاری یکپارچه (Monolithic) با ۸۸ هسته پردازشی
- ۲ مگابایت حافظه کش L2 اختصاصی برای هر هسته با تأخیر دسترسی تقریباً ۱۰ چرخه
- ۱۶۴ مگابایت حافظه کش سطح آخر (LLC) مشترک
- شش خط لوله SVE ۱۲۸ بیتی، چهار خط لوله بارگذاری (Load) و دو خط لوله ذخیرهسازی (Store)
- حافظه کش L1 داده ۹۶ کیلوبایتی
- ساختار انسجام (Coherency Fabric) با پهنای باند ۳.۴ ترابایت بر ثانیه
یکی از متمایزترین ویژگیها، پیادهسازی «پیشبینی مقدار» (Value Prediction) است. این قابلیت به هسته اجازه میدهد نتیجه یک عملیات با تأخیر زیاد را پیشبینی کند تا دستورات وابسته به جای متوقف شدن (Stall)، به مسیر خود ادامه دهند. اگرچه اپل از تکنیکهای مشابهی استفاده میکند و AMD در نسلهای Family 17h (Zen 1 و 2) روی برخی دستورات ممیز شناور آزمایش کرده بود، اما Olympus پیادهسازی بسیار گستردهتری دارد که به رویکرد اپل نزدیکتر است.

انویدیا همچنین بر «پیشخوان گراف» (Graph Prefetcher) و «پیشبین شاخه عصبی» تأکید میکند. با این حال، تحلیلهای فنی نشان میدهد اینها اختراعات بدیعی نیستند. پردازنده Granite Rapids اینتل پیش از این از پیشخوان Array of Pointers استفاده میکرد که دادههای پیشخوانده برای یک بارگذاری با گام ثابت (Constant Stride Load) را به عنوان اشارهگری برای ارسال درخواستهای بیشتر در نظر میگیرد. این اساساً همان اصل تولیدکننده-مصرفکننده در پیشخوان انویدیا است، هرچند ممکن است نسخه انویدیا زنجیرههای پیچیدهتری را مدیریت کند.
به همین ترتیب، AMD از سال ۲۰۱۲ در معماری Piledriver از پیشبینهای مبتنی بر پرسپترون استفاده میکرد و این روند در Zen 1 ادامه یافت. با این حال، از Zen 2 به بعد، AMD به سمت پیشبینهای TAGE تغییر مسیر داد که منجر به کاهش ۳۰ درصدی پیشبینیهای نادرست شد و در Zen 5 احتمالاً بهطور کامل به TAGE متعهد شده است.
ادعاهای حافظه و پهنای باند
تراشه Vera از هشت ماژول SOCAMM2 LPDDR5X استفاده میکند که ظرفیت ۱.۵ ترابایت و پهنای باند ۱.۲ ترابایت بر ثانیه را فراهم میآورد. طبق اعلام انویدیا، این زیرسیستم تنها ۵۰ وات مصرف میکند که جایگزینی بهینه برای DIMMهای حجیم در پلتفرمهای EPYC یا Xeon است؛ پلتفرمهایی که فضای برد و توان مصرفی را فدای سهولت در تعویض و ظرفیت بالاتر میکنند.

اما مقایسه انویدیا با عملکرد حافظه x86 بهشدت مورد مناقشه است. انویدیا ادعای برتری تقریباً ۳ برابری در پهنای باند نسبت به AMD EPYC 9755 را مطرح کرده است. اما تستهای مستقل Phoronix و chipsandcheese نشان میدهد این برتری در پهنای باند کل نزدیک به ۱.۹ برابر و در پهنای باند هر هسته ۲.۸ برابر است. این تمرکز شدید بر زیرساختهای حافظه در راستای روندی است که در آن تراشههای حافظه به دلیل نقش حیاتی در تغذیه مدلهای AI، در حال تبدیل شدن به قطب جدید سرمایهگذاری هستند.
این اختلاف به این دلیل است که انویدیا عملکرد EPYC 9755 را کمتر از واقعیت نشان داده است. در حالی که دادههای انویدیا نشان میدهد Turin در ۴۰۰ گیگابایت بر ثانیه متوقف میشود، تستهای مستقل به ۵۷۰ گیگابایت بر ثانیه رسیدند که تقریباً ۹۳٪ حد نظری ۶۱۴ گیگابایت بر ثانیهی Turin است. در مقابل، پهنای باند اندازهگیری شده برای Vera (۱.۱ ترابایت بر ثانیه) تقریباً ۹۲٪ حد نظری ۱.۲ ترابایت بر ثانیهی آن است.
این موضوع ثابت میکند که برتری پهنای باند ناشی از خودِ رابطهای حافظه است، نه لزوماً طراحی دای یکپارچه (Monolithic) که انویدیا به آن افتخار میکند. یک پردازنده EPYC 9755 مبتنی بر چیپلت که به ۹۳٪ حد خود میرسد، قطعاً توسط توپولوژی خود محدود نشده است. علاوه بر این، مدل EPYC 9686F با ۹۶ هسته از DDR5-8000 یا MRDIMM-12800 پشتیبانی میکند که ۱۰۲۴ یا ۱۶۳۸ گیگابایت بر ثانیه در هر سوکت فراهم میآورد و پتانسیل این را دارد که در نسل Venice پهنای باند نظری بیشتری نسبت به Vera داشته باشد.
جنجال بنچمارکهای «عاملمحور»
شاید فاحشترین ادعای مستندات انویدیا، تغییر نام تستهای استاندارد CPU به «بنچمارکهای عاملمحور» (Agentic Benchmarks) باشد. انویدیا چهار workload صحیح از SPEC CPU 2026 (شامل CPython، GCC، LLVM و Cppcheck) را انتخاب کرده و ادعا کرده است که اینها نماینده workloads عاملهای هوش مصنوعی هستند.

در واقعیت، اینها صرفاً کامپایلرها و مفسرهای استاندارد هستند. هیچ مدل زبانی بزرگی (LLM) در اینجا توکن تولید نمیکند و هیچ رانتایم عاملی ابزاری را انتخاب نمیکند. هیچ Sandboxی شروع نمیشود، هیچ عملیاتی روی I/O منتظر نمیماند و هیچ مشاهدهای به یک Policy باز نمیگردد. اگرچه این برنامهها میتوانند نماینده بخشهای کد-محور یک خط لوله عاملی باشند، اما نامیدن آنها به عنوان «عاملمحور»، یک ترفند بازاریابی برای همراستا کردن CPU با موج هایپ هوش مصنوعی است.
علاوه بر این، انویدیا برتری ۱.۸ برابری در هر هسته را در این تستها نشان میدهد، اما وقتی توان عملیاتی کل سیستم (SPECrate 2026 Integer Base) بررسی شود، برتری Vera نسبت به EPYC 9755 تنها ۳٪ است (۹۲۵ برای Vera در مقابل ۸۹۸ برای EPYC). این برتری ظاهری نتیجه نرمالسازی اعداد بر اساس هر هسته است، نه نمایش خروجی کل سیستم.
انویدیا همچنین این برتری IPC را به چهار گروه شمارنده (Counter Groups) نسبت میدهد و ادعا میکند که تا ۲.۳ برابر پیشبینی شاخه در هر چرخه، ۳.۵ برابر شاخههای پذیرفتهشده، ۲.۴ برابر عملیات واکشی دستور (Instruction-fetch) و ۴.۳ برابر عملیات Backend بیشتر دارد. این ادعاها بدون دسترسی به نامهای رویداد PMU، شمارشهای خام یا فواصل نمونهبرداری، غیرقابل بازرسی هستند و این حقیقت را نادیده میگیرند که دستورات Arm و x86 واحدهای کاری یکسانی نیستند.
بازنمایی نادرست معماری x86
مستندات انویدیا حاوی چندین خطای فنی درباره نحوه عملکرد رقبا است. یک نمونه بارز، توصیف چندرشتهای همزمان (SMT) است.

نمودارهای انویدیا القا میکنند که SMT در x86 یک مکانیسم ساده «تقسیم زمانی» (Time-slicing) است که منابع را بلااستفاده میگذارد. در واقعیت، پیادهسازیهای مدرن SMT بسیار سیالتر هستند. در حالی که مراحل Fetch و Decode ممکن است هر چرخه به رشتههای مختلف سرویس دهند، مراحل Execute و Memory نسبت به رشته بیتفاوت (Thread-agnostic) هستند و میتوانند micro-opهایی از هر دو رشته را در یک چرخه پردازش کنند.
در مقابل، «چندرشتهای فضایی» (Spatial Multithreading) انویدیا بر قطعیت و کیفیت سرویس (QoS) تمرکز دارد، اما جریمه سنگینی دارد: ۱۰,۰۰۰ چرخه زمان میبرد تا یک هسته Olympus پس از پایان رشته دوم، به حالت تکرشتهای بازگردد. این بدان معناست که نرمافزار باید بهشدت نسبت به جریمههای ناشی از اجرای رشتههای دوم آگاه باشد.
به همین ترتیب، انویدیا ادعا میکند که سیستمهای x86 تحت فشار داشتن تا ۳۲ دامنه NUMA هستند. این یک مقایسه گمراهکننده است. پیکربندی ۳۲ گره یک تنظیم اختیاری با دانهبندی بالا (مانند LLC as NUMA) است و حالت پیشفرض نیست. راهنمای تنظیمات AMD حالتهای NPS4، NPS2، NPS1 و NPS0 را لیست میکند. داشتن یک دامنه NUMA در هر سوکت در Vera زمانبندی (Scheduling) را ساده میکند، اما نمیتواند فواصل فیزیکی را در یک دای یکپارچه بزرگ حذف کند.
عملکرد در دنیای واقعی
با وجود نقصهای بازاریابی، خودِ سیلیکون بسیار قدرتمند است. در مه ۲۰۲۶، تستهای اولیه مایکل لارابل در Phoronix نشان داد که میانگین هندسی Vera حدود ۱۰٪ بالاتر از EPYC 9575F (با فرکانس ۵ گیگاهرتز) و ۱.۶۳ برابر سریعتر از CPU Grace خودِ انویدیا است.

سایر نتایج قابل توجه عبارتند از:
- برتری ۲.۶ برابری در PageRank نسبت به EPYC 9755، هرچند نمودار مقیاسپذیری با وجود ۸۸ هسته تراشه، در ۳۲ هسته متوقف شده است.
- عملکرد خیرهکننده در مجموعهدادههای ClickHouse، که در سه پاس روی یک مجموعه داده ۱۰۰ میلیون ردیفی، از سایر پردازندههای تست شده پیشی گرفت.
- مقیاسپذیری خطی تا ۳۲ هسته در workloads سنگین حافظه، که انویدیا آن را به Scalable Coherent Fabric و پیشخوان گراف نسبت میدهد.

با این حال، برخی نتایج غیرقابل بازتولید هستند زیرا انویدیا متغیرهای دقیق مورد استفاده در GAP Benchmark Suite را حذف کرده است. همچنین ادعای «۱.۸ برابر سرعت در آموزش RL» تنها با یک تصویر گرافیکی از مربعهای رنگی (شکل ۲۴) پشتیبانی شده است. هیچ دادهای از مدل، محیط، تخصیص CPU/GPU، فریمورک، اندازه دسته (Batch size) یا نوارهای خطا (Error bars) ارائه نشده است. این یک تصویر است، نه یک بنچمارک.
تحلیل فنی و بررسی عمیق
برای جامعه فنی، مستندات Vera به عنوان یک داستان هشداردهنده در بازاریابی هوش مصنوعی عمل میکند. تغییر به سمت اصطلاحات «عاملمحور» تلاشی است برای بازتعریف بنچمارکهای CPU تا با یک روایت جدید سازگار شوند. انویدیا با قاببندی عملکرد صحیح (Integer) استاندارد به عنوان «عاملمحور»، سعی دارد استانداردهای آنچه را که در عصر هوش مصنوعی یک «CPU سرور» تعریف میکند، تغییر دهد. در کنار این تلاش برای تسلط سختافزاری، انویدیا در لایههای نرمافزاری و امنیتی نیز پیشقدم شده است، چنانکه در ائتلاف OSAA با ۱۲۰ شرکت دیگر برای استانداردسازی گزارشهای امنیتی AI نقش کلیدی ایفا میکند تا اکوسیستم خود را ایمنتر و پذیرفتنیتر جلوه دهد.
در مورد تأخیر هسته-به-هسته و توپولوژی، انویدیا استدلال میکند که دای یکپارچه مزیت قابل توجهی در تأخیر و ثبات ایجاد میکند. اما شواهد ارائه شده ناقص است:
- نقشههای حرارتی (Heatmaps) هسته-به-هسته از مربعهای رنگی بدون شناسهی هسته استفاده میکنند.
- هیچ جدولی برای مقادیر حداقل، میانه یا حداکثر ارائه نشده است.
- هیچ داده توزیعی یا روش اندازهگیری افشا نشده است.
- ادعای «تا ۵۰٪ تأخیر کمتر» نشاندهنده بهترین حالت (Best-case) است، نه رفتار معمول.
در حالی که یک گره NUMA در هر سوکت برای سیستمعامل سادهتر است، اما این تنها یک انتزاع (Abstraction) است. Vera همچنان از یک ساختار انسجام Packet-switched و گرههای خانگی توزیع شده استفاده میکند. تفاوت بین مش (Mesh) در Vera و ساختار خوشهای (Clustered) در EPYC یک سبک-سنگین مهندسی است: EPYC تأخیر بالایی بین خوشهها اما تأخیر کمی در داخل آنها دارد، در حالی که Vera و Xeon Mesh تأخیری بهطور یکنواخت متوسط ارائه میدهند.
در مورد SMT و تقسیم منابع، چندرشتهای فضایی انویدیا هدفش «قطعیت، جداسازی و کیفیت سرویس» است. با این حال، مستندات از بحث درباره افزایش عملکرد خام اجتناب میکند. در SMT سنتی، منابع Out-of-order مانند Reorder Buffer، فایلهای ثبات و صفهای ترتیب حافظه میتوانند تکرار شوند، علامتگذاری شوند یا بهطور رقابتی به اشتراک گذاشته شوند. برخی پیادهسازیها (که حتی در سال ۲۰۰۲ مستند شدهاند) ساختارهای تقسیمشده را بین دو پردازنده منطقی در حالت چندرشتهای تقسیم کرده و برای حالت تکرشتهای دوباره ترکیب میکردند. انویدیا هیچ اطلاعاتی درباره نحوه مدیریت این منابع در Olympus ارائه نداده است، بنابراین مشخص نیست که آیا چندرشتهای فضایی واقعاً در تغذیه هسته کارآمدتر از SMT سنتی است یا خیر.
حکم نهایی
نتیجه واقعی این است که رویکرد Arm یکپارچه (Monolithic) در حال جواب دادن است. زیرسیستم LPDDR5X با پهنای باند بالا و هسته عریض Olympus، یک لبه واقعی در workloads محدود به حافظه (Memory-bound) ایجاد میکنند. با این حال، این ادعا که این یک پیروزی معماری بنیادین بر طراحیهای مبتنی بر چیپلت x86 است، توسط دادهها پشتیبانی نمیشود.
انویدیا یک CPU در سطح جهانی ساخته است، اما سعی میکند آن را با خط لولهای از بازاریابی بفروشد که بخشی از حقیقت را فدا کرده است. صنعت اکنون به سختافزارهای تولیدی بدون محدودیت نیاز دارد تا این ادعاها را خارج از آزمایشگاههای انویدیا تأیید کند.
منتظر عرضه سیستمهای تولیدی کامل Vera به بررسیکنندگان مستقل باشید، جایی که نظارت بر توان مصرفی واقعی (Wall power) و فرکانس، در نهایت کارایی واقعی هسته Olympus را آشکار خواهد کرد.
گام بعدی شما
- اگر در حال ارزیابی سختافزار برای استقرار مدلهای محلی هستید، به جای تکیه بر Whitepaperهای سازنده، منتظر بنچمارکهای Phoronix و chipsandcheese بمانید.
- در تحلیلهای هزینه-فایده خود، تفاوت بین «عملکرد هر هسته» و «توان عملیاتی کل سیستم» را لحاظ کنید تا دچار خطای محاسباتی نشوید.
- بررسی کنید که آیا workloads شما واقعاً به ویژگی Spatial Multithreading نیاز دارند یا جریمه ۱۰,۰۰۰ چرخهای آن، باعث کاهش کارایی نرمافزار شما میشود.
اما داستان سختافزاری این تحول حتی شگفتانگیزتر است — به تحلیل ما دربارهی تراشههای Blackwell مراجعه کنید.



گفتگو