تصور کنید تمام صفحات یک دفترچه یادداشت را پاره کنید، اما فهرست مطالب را نگه دارید؛ سیستم هنوز میداند داستان از کجا قطع شده است. این دقیقاً همان اتفاقی است که در OpenAI Agents SDK — ابزاری برای ساخت دستیارهای هوش مصنوعی — رخ میدهد و باعث میشود پاک کردن تاریخچهٔ چت، لزوماً به معنای شروعی تازه نباشد. پژوهشگران دریافتند که یک لیست تاریخچهٔ خالی همچنان میتواند از طریق شناسههای پاسخِ پایدار (Persistent Response Identifiers)، به گفتگوهای قدیمی ارجاع دهد.
این یافته شکافی حیاتی میان آنچه کاربر در رابط کاربری میبیند و آنچه برنامه در لایههای زیرین اجرا میکند را آشکار میکند. در واقع، در حالی که متن قابل مشاهده ناپدید میشود، «نشانهگذار» یا همان Bookmark باقی میماند و به هوش مصنوعی زاینده (Generative AI) — شبیه به کتابخانهداری که میلیاردها صفحه را خوانده و حالا با همان لحن جواب میدهد — اجازه میدهد به وضعیت قبلی متصل شود. این موضوع به معنای آن نیست که هوش مصنوعی «بهطور مخفیانه به یاد میآورد»، بلکه صرفاً مربوط به نحوه مدیریت ارجاعات در کد مدیریت جلسه (Session Management) است. این چالشها در مدیریت دادهها، یادآور ضعفهای امنیتی در ذخیرهسازی تاریخچه فعالیت کاربران است که پیشتر در سیستمهای دیگر OpenAI مشاهده شده بود.
همانطور که در تحلیلهای قبلی ما دربارهی مدیریت حافظه در مدلهای عاملمحور اشاره کردیم، پایداری وضعیت (State Persistence) یکی از پیچیدهترین چالشهای مهندسی است. این مطالعه در جریان توسعه CodeFlowMu انجام شد؛ سیستمی برای همکاری میان دستیارهای هوش مصنوعی. هدف از این بررسی این بود که مشخص شود هنگام ادامه کار یا بازسازی زمینه (Context)، کدام وضعیتهای قدیمی واقعاً مورد استفاده قرار میگیرند. در واقع، مدیریت صحیح گفتگوهای طولانی برای جلوگیری از گم شدن دادهها، به چنین دقتهای مهندسی در لایههای زیرین نیاز دارد.
سازوکار «نشانهگذار»
یک برنامه برای حفظ تداوم گفتگو نیازی به ارسال مجدد تکتک پیامها ندارد. در عوض، میتواند از یک شناسهی پاسخ (Response Identifier) برای ادامه یک زنجیره موجود استفاده کند. در این ساختار، لیست تاریخچه متن واقعی را ذخیره میکند، اما شناسهی پاسخ مانند یک اشارهگر (Pointer) عمل میکند.
طبق مستندات فنی، این مشکل در زمان «فشردهسازی زمینه» (Context Compaction) رخ میدهد؛ فرآیندی که برای ایجاد یک نمایش کوتاهتر از یک گفتگوی طولانی جهت استفادههای بعدی به کار میرود. در این فرآیند، مؤلفه جلسه (Session Component) میتواند محتوای فعلی را ارائه دهد یا از یک شناسهی پاسخ قدیمی ادامه دهد. تا زمانی که سیستم بتواند آن شناسهی قدیمی را انتخاب کند، خالی کردن لیست تاریخچه ثابت نمیکند که اتصال قدیمی قطع شده است.
تحلیل نقاط شکست
پژوهشگران برای افشای این نقص از یک پایگاهداده SQLite — نوعی پایگاهداده که اطلاعات را در یک فایل محلی ذخیره میکند — استفاده کردند تا عملیات محلی را شبیهسازی کنند. آنها بهطور خاص سناریوهایی را بررسی کردند که در آن دستور حذف در پایگاهداده ثبت (Commit) میشود، اما عملیات پیش از آنکه فراخواننده تاییدیه را دریافت کند، لغو یا با خطا مواجه میگردد. این رویکرد شبیهسازی، شباهت زیادی به استفاده از گاوصندوقهای محلی SQLite برای پایداری دانش دارد که راهکاری برای مقابله با فراموشی حافظه در AI است.
دو مورد شکست اصلی شناسایی شد:
- حذف در پایگاهداده محلی ثبت میشود، اما عملیات پیش از بازگشت پاسخ لغو میگردد.
- حذف ثبت میشود، اما تاییدیه (Acknowledgement) آن با خطا مواجه میشود.
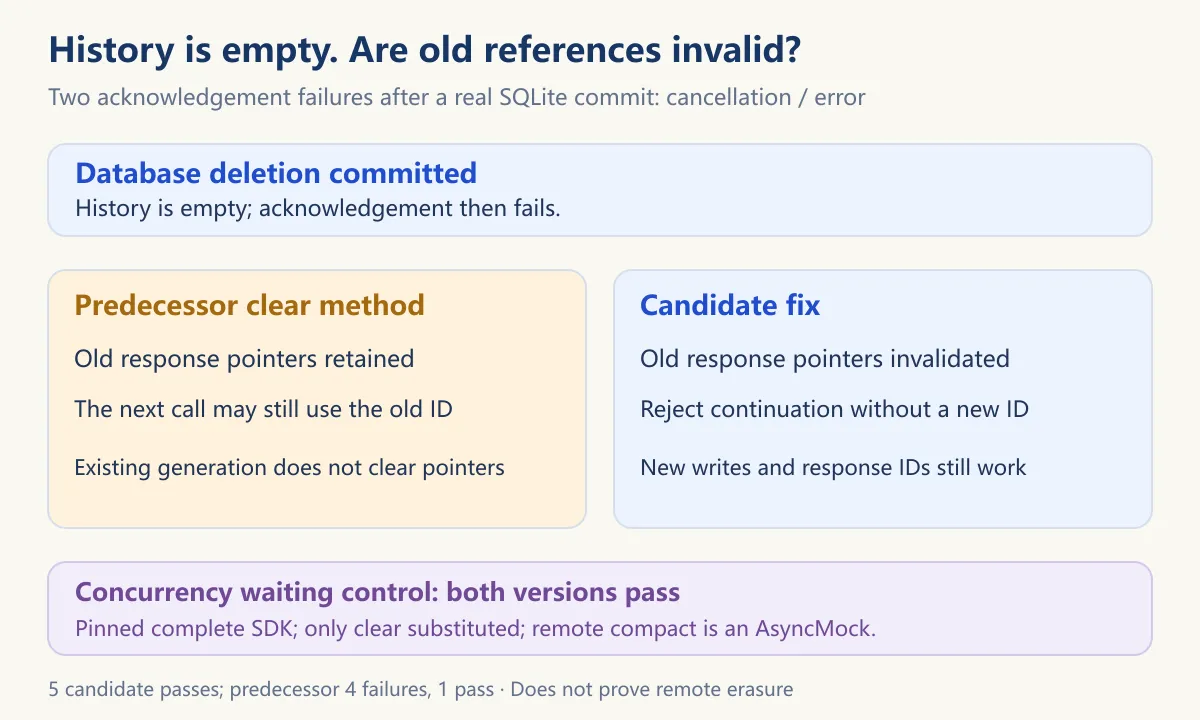
در این حالتها، فراخواننده با یک شکست مواجه میشود و ممکن است آن را بهصورت «هیچ اتفاقی نیفتاده» تفسیر کند، که منجر میشود برنامه شناسههای قدیمی را حفظ کند. این امر باعث ایجاد یک واگرایی (Divergence) میشود؛ جایی که تاریخچه پایگاهداده واقعاً خالی است، اما برنامه همچنان یک ارجاع معتبر به گفتگوی قدیمی در دست دارد.
اعتبارسنجی پنجگانه
یکی از مشارکتکنندگان به نام sbguangha اصلاحیهای (Candidate #5000) پیشنهاد داد تا دو مورد نادیده گرفته شده را برطرف کند: شناسهی پاسخ فعلی و آخرین شناسهای که هنوز در تاریخچه ذخیره نشده است. اینها ارجاعاتی هستند که ادامه مسیر را هدایت میکنند، نه کپیهایی از متن گفتگو.
برای جداسازی اثر پاکسازی، پژوهشگران نسخه ثابت (Pinned) SDK و تستهای اصلی بالادستی را مورد استفاده قرار دادند. آنها ابتدا اصلاحیه کاندید را اجرا کردند و سپس تنها متد clear آن را با پیادهسازی نسخه قبلی جایگزین کردند، در حالی که سایر موارد بدون تغییر باقی ماند. نتایج این پنج بررسی به شرح زیر بود:
- پاکسازی عادی: آیا پاکسازی عادی ارجاع پاسخ قدیمی را باطل میکند؟ (قدیم: شکست | اصلاحیه: موفق)
- لغو پس از ثبت: آیا ارجاع قدیمی پس از لغو عملیات (بعد از ثبت حذف) باطل میشود؟ (قدیم: شکست | اصلاحیه: موفق)
- خطای تاییدیه: آیا ارجاع هنگام بروز خطا در تاییدیه (بعد از ثبت حذف) باطل میشود؟ (قدیم: شکست | اصلاحیه: موفق)
- فشردهسازی خودکار: آیا فشردهسازی خودکار پس از پاکسازی از ورودی فعلی استفاده میکند؟ (قدیم: شکست | اصلاحیه: موفق)
- فشردهسازی در جریان: آیا پاکسازی منتظر اتمام فشردهسازی در جریان میماند و تاریخچه را خالی میگذارد؟ (قدیم: موفق | اصلاحیه: موفق)
روش قدیمی در ۴ مورد از ۵ بررسی شکست خورد. بررسی پنجم یک تست همزمانی (Concurrency) موجود بود که ثابت کرد مشکل صرفاً نبودِ حفاظهای همزمانی نبوده است.
نقش حفاظهای موجود
این SDK پیش از این دارای یک قفل (Lock) برای هماهنگی عملیات همزمان و یک شمارنده داخلی برای ردیابی تغییرات وضعیت بود. با این حال، آزمایشها نشان داد که هیچکدام از اینها بهطور خودکار تمام شناسههای پاسخ ذخیرهشده را پاک نمیکنند.
اصلاحیه جدید مکانیسم تولید (Generation) جدیدی اضافه نکرد، بلکه صرفاً دو ارجاع پاسخ نادیده گرفته شده را در هر دو مسیر پاکسازی (چه موفق و چه استثنایی) باطل کرد. این موضوع ثابت میکند که جلوگیری از عملیات متضاد و ابطال ارجاعات منسوخ، نیازمند بررسیهای مجزا هستند.
فراتر از تاریخچه: مشکل دستورالعملهای وظیفه
این مطالعه همچنین Paperclip #13345 را بررسی کرد که توسط cryppadotta پیشنهاد شده بود. Paperclip دستیارهای هوش مصنوعی را که وظایفی را اجرا میکنند، سازماندهی میکند. این مشکل مربوط به زمانی بود که یک جلسه از سر گرفته میشد در حالی که فراخوانی آن، توصیف بهروزرسانیشدهی وظیفه را حذف کرده بود؛ این امر اجازه میداد یک کامنت قدیمی دوباره به هدف اصلی تبدیل شود.
پژوهشگران هفت ورودی قبل و بعد از انتخابگر اصلی دستورالعمل وظیفه (Task-brief selector) را بررسی کردند. با استفاده از ورودیهای بیدارباش (Wake inputs) نرمالشده، آنها دریافتند که در دو مورد از بازگشتهای عادی، انتخاب تنها یک شناسهی وظیفه کوتاه به شامل شدن دستورالعمل کامل فعلی تغییر یافته است. سایر کنترلها مانند وظیفه جدید (Fresh-task)، تخصیص (Assignment) و بازیابی (Recovery)، رفتار خود را حفظ کردند.
تفاوت این مورد با باگ تاریخچه در این است که در SDK نیاز به قطع یک اتصال قدیمی بود، اما در Paperclip نیاز به تحویل دستورالعملهای جدید به گفتگویی بود که همچنان معتبر باقی مانده است.
درس مهندسی
این پژوهش ثابت میکند که توسعهدهندگان نمیتوانند برای تضمین یک وضعیت پاک (Clean State)، تنها به شرط «صفر بودن ردیفهای تاریخچه» تکیه کنند. در عوض باید از عملیات بعدی به عقب حرکت کنند و بپرسند:
- عملیات بعدی محتوا، شناسهها یا کارهای معلق خود را از کجا میگیرد؟
- پس از پاکسازی عادی، لغو یا خطای تاییدیه، چه چیزی در هر مکان باقی میماند؟
برای کسانی که گردشهای کاری عاملمحور (Agentic) پیچیده میسازند، این بدان معناست که ردیابی تغییر وضعیت و قفلها کافی نیستند؛ تنها راه تضمین بازنشانی واقعی، ابطال صریح تمام ارجاعها است.
محدوده و محدودیتها
این اصلاحیه در زمان مطالعه هنوز باز بود و نتایج مربوط به سورس کد کاندید است. تماسهای از راه دور شبیهسازی (Mock) شده بودند و حذفهای SQLite بهصورت محلی رخ دادند. این مطالعه بازنشانیهای بین-فرآیندی (Cross-process)، پاکسازی از راه دور یا لغو کلی مجوزها را بررسی نکرد. علاوه بر این، پنج بررسی مذکور این موضوع را پوشش ندادند که آیا یک تلاش مجدد (Retry) در صف یا یک عملیات تأخیری همچنان میتواند یک شناسهی قدیمی را حمل کند یا خیر؛ موضوعی که میتواند حوزهای برای تستهای آینده باشد.
گام بعدی شما
- اگر از SDKهای OpenAI برای مدیریت جلسات استفاده میکنید، بررسی کنید که آیا ارجاعهای Response ID را بهطور صریح باطل میکنید یا خیر.
- در طراحی سیستمهای عاملمحور، منطق «پاکسازی» را بر اساس خروجیهای احتمالی (مانند لغو عملیات) تست کنید، نه فقط مسیر موفقیت.
- برای اطمینان از حریم خصوصی یا جداسازی کاربران، از مکانیزمهای شناسایی در سطح دیتابیس بهجای تکیه بر متدهای Clear سطح اپلیکیشن استفاده کنید.
اما داستان سختافزاری مدیریت این وضعیتها در مقیاس میلیونی حتی پیچیدهتر است — به تحلیل ما دربارهی بهینهسازی KV Cache در مدلهای جدید مراجعه کنید.



گفتگو