اگر امروز کل جریان کاری شرکت شما بر پایه یک API متکی است، احتمالاً در حال تماشای یک دروغ منظم هستید. تفاوت میان آنچه OpenAI در صفحه وضعیت خود «سبز» نشان میدهد و آنچه شما در کنسول برنامهنویسی تجربه میکنید، یک شکاف خطرناک است.
بر اساس بررسیهای فنی، در حالی که صفحات رسمی OpenAI ادعای پایداری ۹۹.۹۹ درصدی را دارند، در دسترس بودن واقعی (Availability) برای کاربران در واقعیت نزدیک به ۸۶ درصد است. این شکاف به این معناست که سرویسی که به طور اسمی تنها چهار دقیقه در ماه قطع است، در واقعیت برای بسیاری از کاربران بیش از چهار روز در ماه از دسترس خارج میشود.
همانطور که در تحلیل قبلی ما دربارهی دشواریهای OpenAI در حفظ پایداری مدلهای بلندمدت اشاره کردیم، این شکاف نشاندهنده یک مشکل ساختاری عمیق است. برای توسعهدهندگان و سازمانهای تجاری، صفحه وضعیت «سبز» اغلب بیشتر یک ویجت بازاریابی است تا یک حقیقت فنی. این پدیده «وضعیت هندوانهای» (Watermelon Status) نام دارد؛ یعنی از بیرون سبز و سالم به نظر میرسد، اما در درون قرمز و دچار بحران است. این وضعیت باعث میشود کسبوکارها نسبت به پایداری واقعی پشتههای هوش مصنوعی خود کاملاً نابینا باشند.
مکانیسمهای شکاف پایداری
طبق دادههای وبسایت checkupstream.com تا تاریخ ۱۱ جولای ۲۰۲۶، نرخ پایداری «بر اساس تجربه مشتری» برای OpenAI حدود ۸۵.۷۷۱ درصد بود. در مقابل، صفحه status.openai.com در همان تاریخ، پایداری API را ۹۹.۹۹ درصد و ChatGPT را ۹۹.۸۶ درصد گزارش کرده بود. برای درک بهتر زمینه، پایداری Codex در ۹۹.۹۸ درصد و FedRAMP contour در ۹۹.۹۶ درصد گزارش شده بود.
این تضاد به این دلیل رخ میدهد که OpenAI پایداری را به صورت میانگین کل در تمام سطوح، مدلها و انواع خطاها محاسبه میکند. طبق اعلام خود شرکت در صفحه وضعیت: «دسترسی هر مشتری ممکن است بسته به سطح اشتراک و همچنین مدل خاص و ویژگیهای API مورد استفاده متفاوت باشد».
در واقع اگر یکی از ۱۵ مؤلفه ChatGPT برای یک ساعت قطع شود اما بقیه فعال باشند، میانگین کلی بالا میماند؛ حتی اگر دقیقاً همان قابلیتی که کاربر نیاز دارد کاملاً از کار افتاده باشد. در مورد API که از ۱۲ مؤلفه تشکیل شده است نیز همین منطق حاکم است: شکست در یک مؤلفه واحد به سختی درصد کلی را تغییر میدهد، اما سرویس را برای کاربرانی که به آن نقطه اتصال (Endpoint) خاص وابسته هستند، عملاً بلااستفاده میکند.
علاوه بر این، تخریبهای جزئی — مانند تأخیر شدید یا خطاهای «بار زیاد» (High Load) — اغلب در معیارهای رسمی به عنوان «قطعی کامل» شمارش نمیشوند. پلتفرم Checkupstream از یک مدل وزنی استفاده میکند که در آن قطعیهای کامل ضریب ۱.۰ و تخریب کیفیت ضریب ۰.۳ دارد تا اطمینان حاصل شود که نوسانات کوچک مؤلفهها، امتیاز را مانند شمارش خام حوادث، تخریب نمیکند. با وجود این نگاه محافظهکارانه در وزندهی، رقم نهایی باز هم بسیار پایینتر از گزارشهای رسمی است؛ به طوری که در ماه ژوئن، معیار لغزان ۳۰ روزه به ۸۸.۳۶ درصد رسید.
ناهمواریهای منطقهای نیز نقش مهمی دارند. ممکن است وضعیت جهانی سبز باشد، اما مراکز داده خاص یا سطوح اشتراکی خاص دچار شکست کامل شوند. در بحثهای سال ۲۰۲۶ در Hacker News، کاربرانی در اروپای شرقی از قطعیهای کامل در بازههای زمانی گزارش دادند که کاربران آمریکایی هیچ مشکلی را مشاهده نمیکردند. این موضوع تأیید میکند که سرویسها اغلب به صورت تکهای و منطقهای سقوط میکنند، نه به صورت یکپارچه و جهانی.

کالبدشکافی یک شکست همبسته
تاریخ ۲۳ ژوئن ۲۰۲۶ یک مطالعه موردی بحرانی در مورد شکنندگی هوش مصنوعی بود. OpenAI یک «قطعی جزئی» را ثبت کرد که باعث شد آپلود و دانلود فایل در ChatGPT از ساعت ۱۴:۲۴ تا ۱۶:۳۸ (۲ ساعت و ۱۴ دقیقه) مختل شود. این حادثه با شناسه 01KVTDW6E1PXBTY2A9XEBT4MY4 ثبت شد. طبق گزارش رسمی، روند زمانی به این شکل بود: شروع در ۱۴:۲۴، وضعیت «در حال بررسی» در ۱۵:۱۱، کاهش اثر (Mitigation) در ۱۵:۴۷ و بازیابی کامل در ۱۶:۳۸.
اما لایهی دادههای مردمی داستان دیگری داشت. وبسایت DownDetector شاهد اوج ۲۳۰ شکایت بود و ۸۳ درصد کاربران گزارش دادند که اصلاً نمیتوانند وارد ChatGPT شوند. خوشههای اصلی این قطعی در نیویورک، بوستون، واشینگتن، سانفرانسیسکو و لوسآنجلس متمرکز بود. هشداردهندهتر این بود که مدل Claude متعلق به شرکت Anthropic نیز در همان بازه زمانی، دقیقاً از ساعت ۱۶:۵۳ تا ۱۷:۲۳ با اوج ۷۲۴۶ شکایت دچار مشکل شد (۴۳ درصد چت وب، ۲۵ درصد موبایل و ۲۴ درصد Claude Code).
این شکست همزمان ثابت میکند که تکیه بر یک فروشنده AI به عنوان پشتیبان برای فروشنده دیگر، استراتژی سادهلوحانهای است. وابستگیهای زیرساختی مشترک، مانند مناطق ابری مشترک در AWS، میتواند باعث شود چندین مدل پیشرو همزمان سقوط کنند. این اتفاق میتواند به دلیل فشار بیش از حد بر یک منطقه ابری مشترک یا هجوم ترافیک کاربران به سرویس دوم پس از سقوط سرویس اول باشد.
یک هزینه انسانی نیز وجود دارد که در گزارشهای رسمی ثبت نمیشود. یک توسعهدهنده در ۸ جولای ۲۰۲۶ در تالار گفتگوهای OpenAI نوشت که حساب ChatGPT Pro او به دلیل «فعالیت مشکوک» غیرفعال شده است؛ تنها به این دلیل که برای دور زدن قطعی ۲۳ ژوئن، شبکهها و گرههای خود را تغییر داده بود. سیستم خودکار این رفتار را به عنوان حمله شناسایی کرد و منجر به مسدود شدن کامل حساب و از دست رفتن منبع درآمد او شد.
هزینه قفل شدن در یک فروشنده واحد
وابستگی به یک تأمینکننده، «نقطه شکست واحد» (Single Point of Failure) ایجاد میکند که فراتر از زمانهای قطعی ساده است. تحلیلگران TLC Mentor در گزارش سال ۲۰۲۶ خود با عنوان «یک تامینکننده AI، یک نقطه شکست واحد است»، استدلال میکنند که مدلها در حال تبدیل شدن به کالاهای عمومی (Commodity) هستند، نه قلعههای دفاعی (Moat). وقتی یک شرکت مالک کل جریان کاری شماست، قدرت افزایش قیمت یا کاهش مخفیانه عمق استدلال — همانطور که گزارش شده Anthropic برای جلسات مصرفکنندگان انجام داد — را بدون هیچ پیامدی دارد.
وابستگیهای زیرساختی نیز زنجیرهای عمل میکنند. قطعی گسترده AWS در اکتبر ۲۰۲۵ تنها مدلها را از کار نینداخت، بلکه جریانهای احراز هویت داخلی را شکست. سونو کاپور، مشاور IT، اشاره کرد که ابزارهای توسعهدهنده مبتنی بر AI و داشبوردهایی که به سرویسهای هویت AWS وابسته بودند، نتوانستند احراز هویت کنند. این وابستگی متقابل، ریسک مالی را به سرعت افزایش میدهد و خسارات کلان اقتصادی این قطعیها به صدها میلیارد دلار تخمین زده شده است.
بسیاری از سازمانها نقشهای شفاف از این ریسک ندارند. وبسایت CIO.com در سال ۲۰۲۶ گزارش داد که اکثر شرکتها فهرستی از نقاطی که هوش مصنوعی در جریان کاری آنها جاسازی شده، ندارند. اندرو شارپ از گروه Info-Tech Research افزود که سازمانها اغلب تا لحظه شکست در یک موقعیت حساس، متوجه نمیشوند کدام سیستمهای AI برای آنها حیاتی هستند.
قفل شدن استراتژیک خطر دیگری است. مایور خاندلوال در شورای فناوری فوربس (۲۰ مه ۲۰۲۶) نوشت که در حالی که بازارهای اولیه به تجربه و آزمایش پاداش میدهند، نیروهای اقتصادی در نهایت باعث تجمیع قدرت در دست چند پلتفرم بادوام میشوند. هرچه یک کسبوکار مدت بیشتری با یک تأمینکننده گره بخورد، هزینه مهاجرت برای آن گرانتر میشود.
مهندسی پایداری شخصی
به دلیل اینکه حسابهای استاندارد ChatGPT Plus، تیمی و APIهای پرداختبه-اندازه-مصرف هیچ توافقنامه سطح خدمات (SLA) عمومی ندارند، کاربران هیچ راه قانونی یا غرامتی برای زمانهای قطعی ندارند. تنها سطح Enterprise Scale Tier/Priority Processing یک SLA رسمی ۹۹.۹ درصدی ارائه میدهد. حتی در این سطح هم، درصد دقیق اعتبارات خدماتی عمومی نیست (صفحه شرایط-اعتبار-سرویس اغلب خطای ۴۰۳ میدهد) و باید بهصورت انفرادی مذاکره شود.
برای مقابله با این وضعیت، توسعهدهندگان باید سیستمهای نظارت (Health Checks) خود را پیاده کنند. یک اسکریپت ساده پایتون که هر دقیقه یک درخواست واقعی به مدل میفرستد، میتواند یک گزارش صادقانه از پایداری ارائه دهد. استفاده از timeout=15 و چک کردن پاسخ معتبر، از «تله پینگ» جلوگیری میکند؛ جایی که سرور پاسخ 200 OK میدهد اما محتوای خالی یا بیمعنی برمیگرداند.
جزئیات منطق نظارت
برای تبدیل یک اسکریپت ساده به نظارت صنعتی، موارد زیر را اجرا کنید:
- کاوشهای زمانبندیشده: استفاده از cron یا systemd-timer برای اجرای هر دقیقهای، ۴۳,۲۰۰ نقطه داده در ماه ایجاد میکند تا دقت بالا باشد.
- آستانه تأخیر: هر پاسخی که بیش از ۱۰ ثانیه طول بکشد را حتی در صورت OK بودن، به عنوان «تخریب کیفیت» ثبت کنید.
- هشدارهای متوالی: برای ۳ تا ۵ شکست متوالی، یک «قطعکننده» (Circuit Breaker) فعال کنید تا ترافیک فوراً به پشتیبان منتقل شود.
- اعتبارسنجی کیفیت: علاوه بر کد HTTP، طول و فرمت پاسخ را چک کنید تا «شکستهای خاموش» (Silent Failures) را شناسایی کنید.
استراتژیهای افزونگی چند-تأمینکننده
برای شکستن وابستگی به یک فروشنده، مهندسان از مسیریابهای چند-تأمینکننده (Multi-provider routers) استفاده میکنند. چهار الگوی اصلی برای این منطق وجود دارد:
- جایگزینی متوالی (Sequential Fallback): درخواست ابتدا به تأمینکننده A میرود. در صورت خطا یا تأخیر، به B و سپس C منتقل میشود. این روش ساده است اما اگر A کند باشد (اما کاملاً قطع نباشد)، تأخیر کلی را بالا میبرد.
- قطعکننده (Circuit Breaker): خطاها را در یک پنجره زمانی رصد میکند. اگر آستانه (مثلاً ۳ خطا) رد شد، «مدار قطع میشود» و تمام ترافیک برای مدت کوتاهی (مثلاً ۶۰ ثانیه) از آن کانال عبور نمیکند و سپس با یک برش کوچک از ترافیک دوباره تست میشود.
- مسابقه همزمان (Concurrent Racing): درخواست را همزمان به دو تأمینکننده میفرستد و سیستم اولین پاسخ موفق را میپذیرد. تأخیر را به حداقل میرساند اما هزینه توکن را دو برابر میکند.
- جایگزینی مدل (Model Fallback): یک جایگزین سطح بالا است. اگر کل خط GPT-4 قطع شد (Failover تأمینکننده)، مسیریاب به یک کلاس کاملاً متفاوت مانند Claude یا DeepSeek تغییر مسیر میدهد.
نقاط ضعف تنظیمات چند-تأمینکننده
این تنظیمات «دکمه جادویی» نیستند و چالشهای مهندسی خاص خود را دارند:
- واگرایی پرامپت: مدلهای مختلف دستورات را متفاوت میفهمند. پرامپتی که برای GPT بهینه شده ممکن است در Claude شکست بخورد و نیاز به مهندسی پرامپت برای هر مدل یا اعتبارسنجی سختگیرانه خروجی داشته باشد تا از کرش کردن پارسرها جلوگیری شود.
- هزینه در برابر تأخیر: روش مسابقهای سریع اما گران است؛ روش متوالی ارزان اما در زمان تخریب کیفیت، تأخیر را افزایش میدهد.
- نقاط شکست مسیریاب: خودِ مسیریاب متمرکز میتواند سقوط کند. یکی از مسیریابهای شناختهشده در اوت ۲۰۲۵ دچار قطعی ۵۰ دقیقهای Gateway شد.
- «خطای موفق»: بررسی ۱۰۰ گزارش پسمرگ (Postmortem) در dev.to در سال ۲۰۲۶ نشان داد بسیاری از برنامههای LLM خطاهایی تولید میکنند که در تمام لایهها به صورت HTTP 200 (موفق) دیده میشوند اما خروجی نهایتاً غلط است.
پیادهسازی برای توسعهدهندگان در روسیه
برای توسعهدهندگان در روسیه، این موضوع دوچندان حیاتی است. دسترسی مستقیم به OpenAI به دلیل مسدودسازیهای جغرافیایی (که از مارس ۲۰۲۳ فعال است) و شکست در پرداختها ناپایدار است. کارتهای روسی (Visa، Mastercard، MIR) پذیرفته نمیشوند. علاوه بر این، Anthropic در سال ۲۰۲۶ تأیید هویت Persona را معرفی کرد که اکثر کاربران روسی در آن رد میشوند.
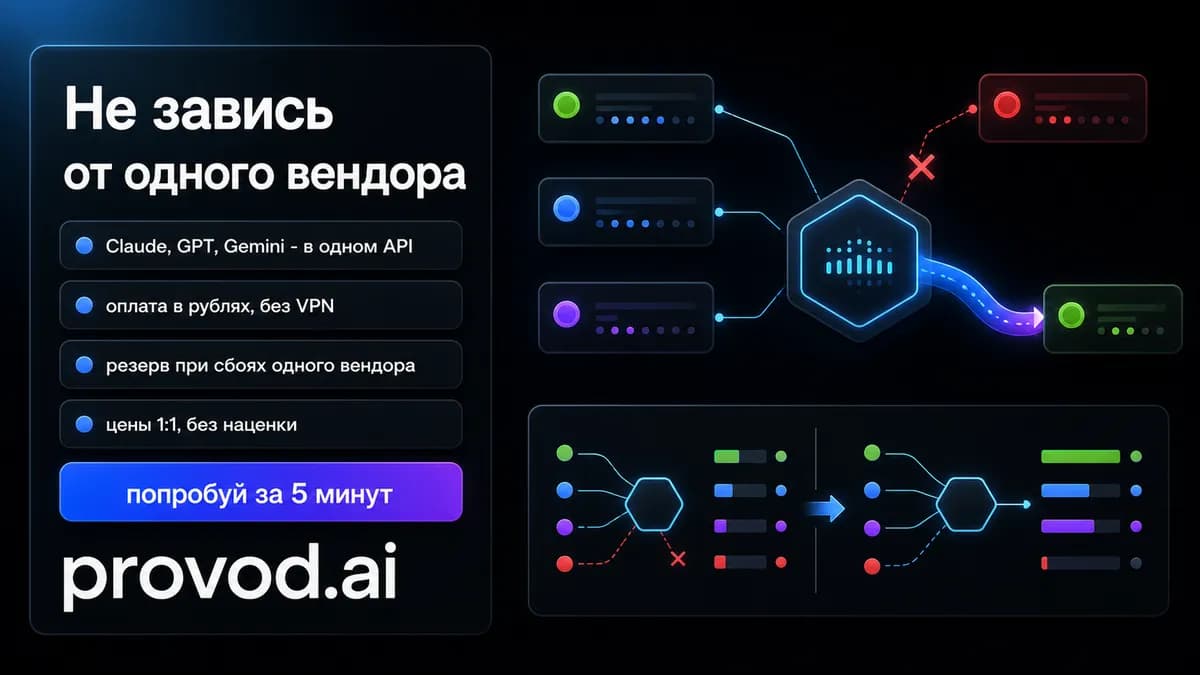
استفاده از تجمیعکنندههایی مثل provod.ai به تیمها اجازه میدهد با روبل پرداخت کنند و از افزونگی تأمینکنندگان از طریق یک API سازگار با OpenAI استفاده کنند. این رویکرد اقتصادی باعث شده تا برخی تجمیعکنندگان API بتوانند هزینه دسترسی به ChatGPT را تا ۷۰٪ کاهش دهند، که برای کسبوکارهای کوچک در مناطق محدود شده بسیار حیاتی است. این کار نیاز به VPN را حذف کرده و حمایت از قراردادهای قانونی و اسناد بستن حساب برای شخصیتهای حقوقی را ممکن میسازد.
با تغییر base_url به https://api.provod.ai/v1 و بهروزرسانی کلید API، توسعهدهندگان میتوانند به مدلهای متنوع با قیمت رسمی ۱:۱ دسترسی داشته باشند:
- gpt-5.5: ۰.۳۹ / ۲.۳۴ روبل برای هر ۱ هزار توکن (تولید استاندارد)
- claude-opus-4.8: ۰.۳۹ / ۱.۹۵ روبل برای هر ۱ هزار توکن (کدهای پیچیده ایجنتی)
- gemini-3.1-pro: ۰.۱۶ / ۰.۹۴ روبل برای هر ۱ هزار توکن (کانتکست بلند/چندوجهی)
- deepseek-v4-flash: ۰.۰۱۱ / ۰.۰۲۲ روبل برای هر ۱ هزار توکن (حجم بالا/هزینه کم)
- qwen3.7-max: ۰.۰۹۴ / ۰.۴۶۸ روبل برای هر ۱ هزار توکن (زبان روسی/ذخیره ارزان)
مقایسه متدهای مدرن ردیابی
متدهای مختلف ردیابی، اعداد متفاوتی میدهند چون چیزهای متفاوتی را اندازه میگیرند. تا ۱۱ جولای ۲۰۲۶ وضعیت به این شرح است:
| ردیاب | آنچه اندازه میگیرد | شاخص OpenAI | متدولوژی |
|---|---|---|---|
| status.openai.com | میانگین مؤلفهها | ۹۹.۹۹٪ (API) | «در تمام سطوح، مدلها و انواع خطاها» |
| DevHelm | تحلیل وضعیت رسمی | ۹۹.۹۹٪ | کپی وضعیت رسمی از طریق نظرسنجی هر ۳۰ ثانیه |
| downforai | پاسخ نقطه اتصال (۲۴h) | ۱۰۰٪ | پینگ هر ۷۵ دقیقه در ۴ سطح مختلف |
| checkupstream | تجربه واقعی مشتری | ۸۵.۷۷۱٪ | وزنی: قطعی کامل (۱.۰)، تخریب (۰.۳) |
| StatusGator | تعداد کل حوادث | ۳۱۹ | تجمیع تغییرات وضعیت و شکایات کاربران |
در نهایت، رشد ردیابهای شخص ثالث مانند incidenthub و modeluptime، پاسخی مستقیم به نبود شفافیت در صفحات وضعیت رسمی است. پایداری باید در لایه اپلیکیشن ساخته شود، نه اینکه از بازاریابی فروشنده فرض شود.
گام بعدی شما
- یک اسکریپت پایش ساده با
timeout=15برای APIهای خود بنویسید تا واقعیت پایداری را بدانید. - استراتژی Multi-provider را با استفاده از الگوی Circuit Breaker برای خدمات حیاتی خود پیاده کنید.
- هرگز به یک مدل واحد برای backup تکیه نکنید؛ ترکیب مدلهای مختلف (مانند Claude در کنار GPT) تنها راه خروج از نقطه شکست واحد است.
اما داستان سختافزاری این تحول حتی شگفتانگیزتر است — به تحلیل ما دربارهی تراشههای Blackwell مراجعه کنید.



گفتگو