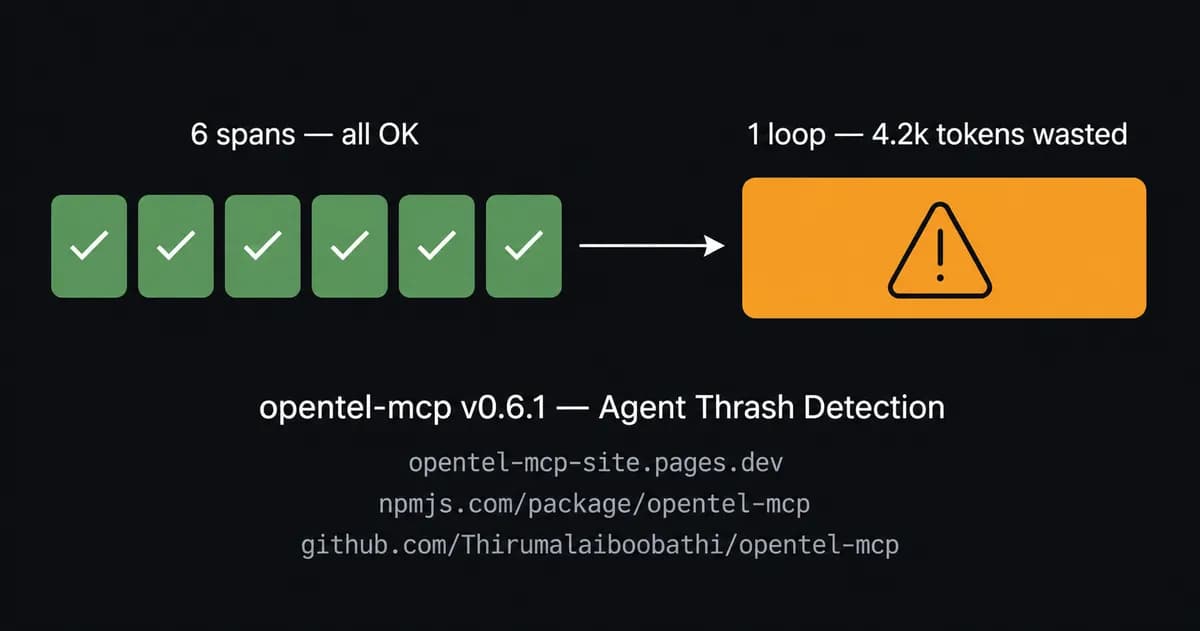
یک فراخوانی ناموفق از ابزار در یک عامل هوش مصنوعی میتواند حلقهای بازگشتی ایجاد کند که بدون فعال کردن حتی یک هشدار خطا، صورتحساب ابری شما را سه برابر کند. این تخلیه پنهان هزینه به این دلیل رخ میدهد که پروتکل زمینهٔ مدل (Model Context Protocol - MCP) — که شبیه به یک مترجم است و به مدل اجازه میدهد با ابزارهای خارجی صحبت کند — خطاهای ابزاری را متفاوت از خطاهای پروتکل مدیریت میکند و در واقع شکستها را از دید ابزارهای نظارتی و خودِ مدل پنهان میکند.
طبق گزارشهای فنی منتشرشده، این مسئله از طریق بررسیهای عمیق روی opentel-mcp، کتابخانهای برای مشاهدهپذیری سرورهای MCP، شناسایی شد. اکثر توسعهدهندگان برای تشخیص خطا به کدهای وضعیت HTTP تکیه میکنند. با این حال، وقتی یک ابزار MCP اجرا شده و شکست میخورد، سرور اغلب پاسخ HTTP 200 OK را برمیگرداند، در حالی که پرچم isError در دلِ دادههای JSON پنهان شده است.

شکاف خطاهای پروتکل
به نقل از مستندات فنی، MCP از دو کانال خطای مجزا استفاده میکند. خطاهای پروتکل — مانند متدهای ناشناخته یا درخواستهای بدشکل (malformed) — به صورت اشیاء استاندارد JSON-RPC بازگشته و به طور طبیعی در ابزارهای اندازهگیری (instrumentation) منتشر میشوند. اما خطاهای ابزاری اینگونه رفتار نمیکنند.
وقتی شکست ابزار رخ میدهد، سرور یک پاسخ موفقیتآمیز JSON-RPC میفرستد. یک نمونه رایج از این دادهها به شکل زیر است:
HTTP/1.1 200 OK
{
  "jsonrpc": "2.0",
  "id": 1,
  "result": {
    "isError": true,
    "content": [
      {
        "type": "text",
        "text": "connection refused: 10.0.0.5:5432"
      }
    ]
  }
}
از آنجایی که ابزارهای نظارتی استاندارد تنها وضعیت انتقال (transport status) را میخوانند، کد 200 OK را میبینند و بازه (span) مربوطه را به عنوان «موفق» علامت میزنند. مدل هوش مصنوعی، مانند Amazon Nova Pro، متن خطا را به عنوان یک نتیجه عادی دریافت میکند. مدل شکست را نه به عنوان یک خطای سیستمی، بلکه به عنوان شکایتی از ورودیهای خود تفسیر میکند. در نتیجه، عامل منطقیترین کار را میکند: استدلالها را بازنویسی کرده و دوباره تلاش میکند.
همانطور که در تحلیلهای پیشین ما دربارهی چالشهای استقرار عاملهای هوش مصنوعی اشاره کردیم، این «منطقِ اشتباه» در محیطهای عملیاتی میتواند فاجعهبار باشد. این عدم پایداری در رفتار عاملها با نتایج مشابهی در بررسیهای جامع کاربردپذیری سرورهای MCP همخوانی دارد که در آن بسیاری از سرورها در مدیریت صحیح درخواستها شکست خوردند.
مارپیچ مرگ توکنها
هر تلاش مجدد تنها هزینه یک فراخوان را ندارد، بلکه هر بار گرانتر میشود. چون عامل کل زمینه انباشتهشده — شامل تمام تلاشهای شکستخورده قبلی — را دوباره میفرستد، تعداد توکنهای (Token) ورودی — یعنی همان تکههای کوچک متن که مدل مصرف میکند — با هر حلقه به صورت خطی رشد میکند.
تصور کنید توالی اتفاقاتی رخ دهد که در آن یک ابزار ۶ بار متوالی به طور یکسان با شکست مواجه شود. با رشد زمینه، هزینههای Bedrock در هر فراخوان افزایش مییابد:
- تلاش ۱: ۸,۰۰۰ توکن ورودی / ۳۰۰ توکن خروجی
- تلاش ۲: ۸,۴۰۰ توکن ورودی / ۳۰۰ توکن خروجی
- تلاش ۳: ۸,۸۰۰ توکن ورودی / ۳۰۰ توکن خروجی
- تلاش ۴: ۹,۲۰۰ توکن ورودی / ۳۰۰ توکن خروجی
- تلاش ۵: ۹,۶۰۰ توکن ورودی / ۳۰۰ توکن خروجی
- تلاش ۶: ۱۰,۰۰۰ توکن ورودی / ۳۰۰ توکن خروجی
در یک مورد ثبتشده، این حلقه منجر به ۶ فراخوان هزینهبر InvokeModel شد که در نهایت هیچ خروجی مفیدی تولید نکرد. این اتفاق ۵۴,۰۰۰ توکن ورودی و ۱,۸۰۰ توکن خروجی را هدر داد و برای یک عملیات منطقی تنها، حدود ۰.۱۹ دلار هزینه داشت. این «تلاطم» (thrashing) برای توسعهدهندگان نامرئی است تا زمانی که صورتحساب ماهانه برسد، زیرا حتی یک بازه خطای واحد برای اشاره به مشکل ایجاد نمیشود. مدت زمان کل چنین حلقهای میتواند به حدود چهار ثانیه برسد، در حالی که هر بازه تکتک به صورت سالم به نظر میرسد.
مکانیسم تشخیص تلاطم در نسخه v0.6.1
برای بستن این شکاف، opentel-mcp v0.6.1 قابلیت شناسایی خودکار تلاطم (Thrash Detection) را معرفی کرد. این ویژگی بر پایه تخصیص هزینه در نسخه v0.5.0 و اثر انگشتگذاری در نسخه v0.4.0 بنا شده است. سیستم با نظارت بر تکرار شکست یک ابزار با یک «اثر انگشت شکست» یکسان در یک جلسه، حلقهها را شناسایی میکند.
اثر انگشتگذاری چگونه کار میکند؟
رشتههای خطای خام برای گروهبندی بیش از حد متغیرند. یک اتصال قطعشده ممکن است هر بار به دلیل تغییر IPها، شناسههای درخواست یا مسیرها، پیامهای متفاوتی تولید کند. برای حل این مشکل، یک خط لوله نرمالسازی، شناسههای UUID، مسیرها، اعداد و رشتههای هگزا را حذف کرده و نتیجه را به یک رشته هگزاخته ۱۶ کاراکتری تبدیل (هش) میکند.
connection refused: 10.0.0.5:5432$
ightarrow$a3f8c21d94b06e77connection refused: 10.0.0.7:5432$
ightarrow$a3f8c21d94b06e77timeout after 30000ms on req_88a1$
ightarrow$6d10b4e7c2f3a915timeout after 30000ms on req_91c4$
ightarrow$6d10b4e7c2f3a915
علت ریشهای یکسان، اثر انگشت یکسان را میسازد. این امر تضمین میکند که ۶ شکست با ۶ پیام اتفاقی مختلف، در یک حلقه شناسایی شده تجمیع شوند که تفسیر صحیح مشکل است.
رویداد mcp.loop.detected
وقتی آستانه تکرار رد شود، کتابخانه یک رویداد mcp.loop.detected صادر میکند. به جای پراکنده کردن شکستها در N بازه غیرقابل تشخیص، این رویداد تمام وزن حلقه را حمل میکند:
- mcp.loop.length: تعداد تکرارها (مثلاً ۶)
- mcp.loop.wasted_tokens_in: توکنهای ورودی هدررفته (مثلاً ۵۴,۰۰۰)
- mcp.loop.wasted_tokens_out: توکنهای خروجی هدررفته (مثلاً ۱,۸۰۰)
- mcp.loop.wasted_cost_usd: هزینه دلاری هدررفته (مثلاً ۰.۱۹)
- mcp.loop.duration_ms: مدت زمان تلاطم (مثلاً ۴۳۱۰ میلیثانیه)
- mcp.loop.first_span_id: اشاره به ریشه اصلی خطا (مثلاً 7b2e...)
- mcp.loop.first_trace_id: شناسه ردپای اولیه (مثلاً c81a...)
- mcp.loop.session_id: شناسه جلسه (مثلاً sess-4471)
- mcp.failure.fingerprint: اثر انگشت شکست (مثلاً a3f8c21d94b06e77)
مقدار first_span_id برای عیبیابی در ساعت ۲ صبح حیاتی است، زیرا مستقیماً به بازهای اشاره میکند که حلقه از آنجا شروع شد. پنج بازه دیگر تنها پژواک هستند و علت واقعی در اولین فراخوانی نهفته است.
نظارت و متریکها
با پیروی از تقسیم کار ایجاد شده در نسخه v0.5.0، این کتابخانه شمارندهها (Counters) را برای هشداردهی و رویدادهای بازه (Span Events) را برای تحلیلهای دقیق فراهم میکند. پنج متریک کلیدی ردیابی میشوند:
mcp.tool.loop.detected(شمارنده)mcp.tool.loop.length(هیستوگرام)mcp.tool.loop.wasted_tokens(هیستوگرام)mcp.tool.loop.wasted_cost_usd(هیستوگرام بر حسب دلار)mcp.tool.loop.duration(هیستوگرام بر حسب میلیثانیه)
پیادهسازی در سرورهای مبتنی بر Bedrock
توسعهدهندگانی که از این کتابخانه استفاده میکنند، میتوانند تشخیص تلاطم را به صورت پیشفرض از طریق instrumentMcpServer فعال کنند:
import { instrumentMcpServer } from "opentel-mcp";
const server = instrumentMcpServer(mcpServer, { serviceName: "mcp-server" });
اگر ابزاری سه بار با اثر انگشت یکسان در بازه ۶۰ ثانیه شکست بخورد، علامتگذاری میشود. ابزاری مانند lookup_customer را در نظر بگیرید که یک پایگاه داده را کوئری کرده و از amazon.nova-pro-v1:0 برای خلاصهسازی نتایج استفاده میکند. اگر جدول پایگاه داده تغییر نام داده باشد، بلوک catch مقدار isError: true را در دادهها برمیگرداند.
بدون نسخه v0.6.1، یک عامل ممکن است ۴ تا ۶ بار برای این کار تلاش کند و هر بار هزینه را به Bedrock بپردازد. با این بهروزرسانی، شما تنها یک رویداد موجز mcp.loop.detected دریافت میکنید که کل این فاجعه را ثبت کرده است. این رویکرد برای مدیریت دقیق قراردادها و جلوگیری از رفتارهای غیرقابل پیشبینی، مکمل ابزارهایی نظیر mcpward است که تمرکز خود را بر تثبیت قراردادهای سرور گذاشته است.
تنظیمات و پیکربندی
تمام تنظیمات از طریق کد یا متغیرهای محیطی قابل تغییر هستند. مقادیر نامعتبر در متغیرهای محیطی به صورت بیصدا به مقدار پیشفرض بازگشته و هرگز خطا (throw) نمیدهند.
| گزینه | متغیر محیطی | مقدار پیشفرض | شرح |
|---|---|---|---|
| فعالسازی | OTEL_MCP_THRASH_ENABLED |
true | غیرفعال کردن کامل تشخیص |
| آستانه | OTEL_MCP_THRASH_THRESHOLD |
3 | تعداد شکستهای هماثر انگشت پیش از هشدار |
| پنجره زمانی | OTEL_MCP_THRASH_WINDOW_MS |
60000 | بازه زمانی متحرک (Rolling) برای تکرار خطاها |
| حداکثر کلیدها | OTEL_MCP_THRASH_MAX_TRACKED_KEYS |
1000 | سقف LRU برای ذخیرهساز ردیابی |
| زمان انقضا | OTEL_MCP_THRASH_ENTRY_TTL_MS |
900000 | مدت زمان بقای یک کلید غیرفعال |
| بازگشت انتشار | OTEL_MCP_THRASH_RE_EMIT_AFTER |
3 | انتشار مجدد هر N شکست پس از رد آستانه |
| فرض جلسه واحد | OTEL_MCP_THRASH_ASSUME_SINGLE_SESSION |
false | جایگزین برای انتقالدهندههای غیرقابل تشخیص |
چهار تصمیم کلیدی در طراحی
۱. حفاظت در برابر کاردینالیتی بالا: اثر انگشتها و شناسههای جلسه هرگز به عنوان برچسب (label) متریک استفاده نمیشوند. اثر انگشتها نامحدودند — هر باگ جدید یک اثر انگشت دائمی است. شناسههای جلسه حتی بدترند. قرار دادن اینها در ابعاد متریک باعث ایجاد یک سری زمانی جدید برای هر باگ و هر جلسه میشود. در CloudWatch این امر سریعاً گران میشود و در هر بکاند دیگری در نهایت باعث فروپاشی سیستم میگردد. دادههای با کاردینالیتی بالا منحصراً روی رویداد بازه (span event) ذخیره میشوند که جایی امن است.
۲. حافظه وضعیت محدود: کتابخانه از یک حافظه نهانی LRU با زمان انقضا (TTL) برای ذخیرهساز ردیابی استفاده میکند. سرورهای MCP روی انتقال stdio تا پایان عمر پردازش فعال هستند (گاهی هفتهها). یک نقشه (map) نامحدود منجر به نشت حافظه کند میشود. این ذخیرهساز از کلیدهای محدود و انقضای تنبل (lazy expiry) در هنگام خواندن با یک پاکسازی تخمینی (amortised sweep) در هنگام نوشتن استفاده میکند. نکته حیاتی این است که هیچ setInterval وجود ندارد، زیرا یک تایمر فعال حلقه رویداد Node را زنده نگه میدارد و مانع از خروج تمیز سرور میشود.
۳. یکپارچگی جلسه: تشخیص حلقه نیازمند یک مرز جلسه است. برای جلوگیری از «حلقههای شبح» — جایی که سه کلاینت مختلف هر کدام یک بار شکست میخورند و به نظر میرسد یک کلاینت سه بار شکست خورده است — کتابخانه از حدس زدن اجتناب میکند. یک شناسه جلسه واقعی همیشه اولویت دارد و سرور را به عنوان جلسه-آگاه علامت میزند. اگر شناسه جلسه نباشد و assumeSingleSession غیرفعال باشد، تشخیص به صورت بیصدا نادیده گرفته میشود. داده اشتباه بدتر از نبود داده است.
۴. مشاهده بدون مداخله: این کتابخانه طبق اصل مشاهدهپذیری عمل میکند. ویژگیها را علامت میزند و متریکها را صادر میکند اما درخواستها را لغو نمیکند یا اتصالات را نمیشکند. یک کتابخانه ابزارسنجی (instrumentation) که بتواند اجرای عامل را متوقف کند، ممکن است تولید را به روشهای غیرقابل پیشبینی از کار بیندازد. شکستن حلقه متعلق به فریمورک عامل یا درگاه هوش مصنوعی (AI Gateway) است، جایی که بخشی آگاهانه از مسیر درخواست است.
تشخیصهای درونپردازشی
برای کسانی که جمعکننده کامل OpenTelemetry ندارند، یک دسترسی درونپردازشی امکان بررسی تلاطمها را از طریق server.getThrashSummary() فراهم میکند:
console.log(server.getThrashSummary());
// {
//   activeLoops: 1,
//   totalLoopsDetected: 4,
//   totalWastedCostUsd: 0.09,
//   totalWastedTokensIn: 3600,
//   totalWastedTokensOut: 900,
//   topOffenders: [
//     { toolName: 'lookup_customer', fingerprint: 'a3f4c8e2b1d09f77', loops: 3, wastedCostUsd: 0.03 }
//   ]
// }
در این حالت هیچ دادهای روی شبکه فرستاده نمیشود و برای هندلرهای بررسی سلامت (Health Check) ایمن است. توجه داشته باشید که activeLoops و topOffenders تنها مواردی را نشان میدهند که در حال حاضر در ذخیرهساز محدود هستند. مجموعهای تجمعی از حذف LRU نجات مییابند و باید برای حسابرسی استفاده شوند.
پاسخ به پرسشهای فنی
- تأخیر: تشخیص تنها یک جستوجو در جدول هش و افزایش یک شمارنده در مسیر شکست است. فراخوانهای موفق تنها یک عملیات پاکسازی ساده انجام میدهند. هیچ فراخوان شبکهای یا کار ناهمگام (async) رخ نمیدهد.
- شکستهای مشروع: اگر ابزاری به سه دلیل متفاوت شکست بخورد، سه اثر انگشت متفاوت تولید میکند. هیچ حلقهای صادر نمیشود، زیرا این یک مشکل متفاوت از شکستهای تکراری است.
- اعتبارسنجی طرحواره: خطاهای مربوط به اعتبارسنجی طرحواره (Schema Validation) از کانال خطای JSON-RPC میروند، نه مسیر
isError. اینها در اینجا پوشش داده نمیشوند، اگرچه «فراخوانی اشتباه ابزار توسط عامل» یک حالت شکست با اولویت بالا برای تشخیصهای آتی است. این چالشهای اعتبارسنجی در رویکردهای لایههای پاکسازی مانند SpaceAI360 با استفاده از ابزارهایی چون Zod برای حذف توقفات API مورد بررسی قرار گرفتهاند. - انتشار رویداد: رویدادها در لحظه رسیدن به آستانه و سپس هر
reEmitAfterشکست صادر میشوند. برای یک حلقه ۱۲-تکراری، رویداد در دفعات ۳، ۶، ۹ و ۱۲ صادر میشود. ارقام هزینه هدررفته به صورت تفاضلی (delta-accounted) محاسبه میشوند تا از شمارش مضاعف جلوگیری شود.
شکاف باقیمانده: زنده بودن مشاهده
یک مشکل حیاتی حلنشده باقی است: اگر مسیر تلیمتری قطع باشد — یعنی هیچ ارائهدهندهای ثبت نشده باشد، جمعکننده غیرقابل دسترس باشد، یا اکسپورتر به طور بیصدا دادهها را رها کند — هم یک شکست ابزار و هم یک اجرای تمیز، خروجی صفر تولید میکنند. این وضعیتی ایجاد میکند که در آن حالت «هیچ چیز شکست نخورد» و «هیچ چیز مشاهده نشد» غیرقابل تشخیص از یکدیگر باشند.
این موضوع در بررسی یک خواننده خارجی در پست انتشار نسخه v0.3.0 برجسته شد. یک سیگنال زنده بودن (liveness signal) نمیتواند از روی کانالی سفر کند که زنده بودنِ خودِ آن کانال مورد تردید است. راهکار پیشنهادی یک قرارداد سه-حالته است: OBSERVED_CLEAN (مشاهدهشده-سالم)، OBSERVED_FAILING (مشاهدهشده-در حال شکست) و OBSERVATION_UNAVAILABLE (مشاهده-ناموجود). این مورد در حال حاضر یک تست مشخصه نادیده گرفته شده در مخزن کد است. تشخیص یک مسیر مشاهده باز بدون وابستگی به internals ناپایدار SDKها، همچنان یک چالش بزرگ است.
نقشه راه آینده
توسعههای آتی برای این کتابخانه عبارتند از:
- تفکیک شکستهای سطح پروتکل از شکستهای اجرا در فرآیند اثر انگشتگذاری تا خطاهای طرحواره و قطعیهای بالادستی متفاوت خوانده شوند.
- پیادهسازی تشخیص تغییرات ناگهانی طرحواره ابزار (tool schema drift) با هش کردن طرحهای
tools/listو علامتگذاری تغییرات بیصدا. - نهایی کردن قرارداد زنده بودن مشاهده که در بالا ذکر شد.
- نمونهبرداری آگاه از هزینه (Cost-aware sampling) برای اطمینان از اینکه ردپاهای گرانقیمت، برخلاف ردپاهای ارزان، از تصمیمات نمونهبرداری جان سالم به در ببرند.
برای کسانی که سرورهای MCP را روی AWS اجرا میکنند، اولویت فوری این است که بررسی کنند آیا شکستهای ابزار واقعاً به ردپاهای (traces) شما میرسند یا خیر. بدون این بررسی، در حالی که هزینههای Bedrock شما بالا میرود، در واقع دارید کورکورانه پرواز میکنید.
گام بعدی شما
- اگر از مدلهای Bedrock استفاده میکنید، فوراً کتابخانه opentel-mcp به نسخه v0.6.1 بهروزرسانی کنید.
- در داشبورد نظارتی خود، متریک
mcp.tool.loop.wasted_cost_usdرا برای شناسایی گرانترین باگها تعریف کنید. - بررسی کنید آیا ابزارهای شما در صورت شکست، پاسخ HTTP 200 برمیگردانند یا کد خطای استاندارد.
اما داستان سختافزاری این تحول حتی شگفتانگیزتر است — به تحلیل ما دربارهی تراشههای Blackwell مراجعه کنید.



گفتگو