تصور کنید میلیونها دلار هزینه کردهاید تا یک مدل هوش مصنوعی اختصاصی برای تحلیل بازار بسازید، اما در پایان پروژه متوجه میشوید که «مغز» مدل در اختیار شرکت پیمانکار است و شما فقط حق استفاده از آن را دارید. این کابوس مدیریتی، نتیجهی نادیده گرفتن مدلهای مالکیت در ابتدای قراردادهای برونسپاری است.
وقتی سازمانهای بزرگ برای بهبود عملیات، حمایت از کارکنان، تقویت تجربه مشتری و خلق محصولات دیجیتال جدید سرمایهگذاریهای کلانی در زمینه هوش مصنوعی میکنند، پاسخ به این پرسش که چه کسی کنترل کد منبع، خط لولههای داده (Data Pipelines)، مدلهای آموزشدیده، محیطهای ابری، مستندات و بهروزرسانیهای آتی را در دست دارد، حیاتی میشود. از تحلیلهای پیشبینانه و اتوماسیون هوشمند گرفته تا اپلیکیشنهای موبایل مبتنی بر هوش مصنوعی، تقاضا برای راهکارهای عملی در حال رشد است، اما ساخت این اپلیکیشنها فراتر از یک تسک فنی است. این فرآیند نیازمند تصمیمات اساسی در مورد دادهها، مالکیت معنوی (IP)، حاکمیت، امنیت، نگهداری، بودجهها و مالکیت بلندمدت است. برای شرکتهایی که خدمات توسعه اپلیکیشنهای هوش مصنوعی را بررسی میکنند، انتخاب مدل درست مالکیت در برونسپاری، یکی از مهمترین تصمیمات استراتژیک در چرخه حیات پروژه است. این مدل شرایط پایان همکاری را شفاف میکند و به سازمانها کمک میکند تا از اختلافات قانونی اجتناب کرده، وابستگی به تأمینکننده (Vendor Lock-in) را کاهش دهند و کنترل داراییهای ارزشمند تجاری خود را حفظ کنند.
بر اساس بررسی منابع متعدد، برونسپاری هوش مصنوعی با توسعه نرمافزاری سنتی تفاوت بنیادین دارد. در نرمافزار سنتی، توافقات شفاف پیرامون مالکیت کد و تحویل پروژه کافی است. اما توسعه هوش مصنوعی لایههای پیچیده متعددی را اضافه میکند؛ زیرا یک راهکار AI ممکن است شامل فرآیندهای جمعآوری داده، مدلهای یادگیری ماشین، گردشکارهای آموزش مدل، APIهای شخص ثالث، کتابخانههای پرامپت، داشبوردهای تحلیلی، زیرساختهای ابری و سیستمهای نظارت مستمر باشد. برای مثال، یک اپلیکیشن پشتیبانی مشتری مبتنی بر هوش مصنوعی ممکن است از تیکتهای پشتیبانی داخلی، مستندات محصول، تاریخچه تعاملات مشتری و سیاستهای شرکت برای تولید پاسخها استفاده کند. در این مورد، سازمان باید مالکیت و کنترل مطلق دادههای تجاری خود را داشته باشد. همچنین باید بداند چه کسی مالک پیکربندی مدل آموزشدیده، پرامپتها، سیستم بازیابی (Retrieval System) و کد منبعی است که این اجزا را یکپارچه میکند. بدون یک مدل مالکیت تعریفشده، شرکت ریسک این را میپذیرد که برای همان هوشی که مزیت رقابتیاش را میسازد، به یک پیمانکار وابسته شود.
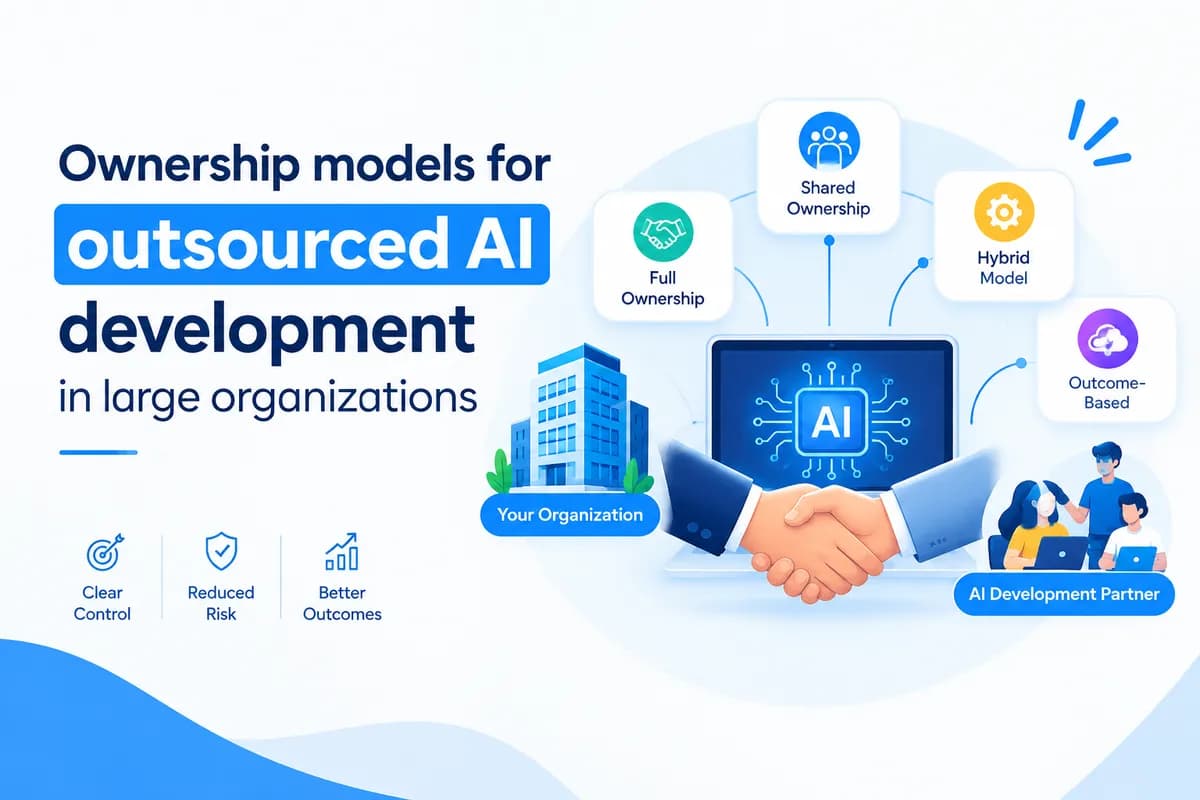
در دنیای برونسپاری هوش مصنوعی، سه مدل اصلی مالکیت وجود دارد:
اول، مدل مالکیت کامل (Full Ownership) است که اغلب به عنوان «کار برای استخدام» (Work-for-Hire) شناخته میشود. در این ترتیب، سازمان مشتری مالک تمام مالکیتهای معنوی خلقشده در طول همکاری است. این شامل کد منبع، معماری، وزنهای آموزشدیده مدل (اگر مدل به صورت سفارشی آموزش دیده باشد)، خط لولههای داده و تمامی مستندات است. این مطلوبترین مدل برای سازمانهای بزرگی است که هوش مصنوعی را یک دارایی استراتژیک هستهای میبینند. مزیت اصلی آن کنترل مطلق است؛ سازمان میتواند پروژه را به پیمانکار دیگری منتقل کند یا آن را کاملاً به داخل سازمان (In-house) بیاورد بدون اینکه با موانع قانونی روبرو شود. با این حال، این مدل معمولاً گرانترین است، زیرا شریک توسعهدهنده نمیتواند منطق یا ابزارهای خاص توسعهیافته برای مشتری را در پروژههای دیگر مجدداً استفاده کند. برای کاهش این هزینه، قراردادها اغلب بین «IP پروژه» (متعلق به مشتری) و «IP پیشزمینه» (ابزارها یا چارچوبهای از پیش موجود متعلق به پیمانکار که به مشتری لایسنس داده میشوند) تفکیک میکنند. در این راستا، استفاده از چارچوبهای باز میتواند هزینهها را کاهش دهد، همانطور که مجوز MIT مسیر پذیرش هوش مصنوعی در سازمانهای بزرگ را هموار کرد و استقرار سریعتر را ممکن ساخت.
دوم، مدل مالکیت مشترک یا توسعه مشترک (Shared Ownership / Co-Development) است که به هر دو طرف (مشتری و پیمانکار) اجازه میدهد حقوق فناوری توسعهیافته را داشته باشند. این مدل زمانی رایج است که راهکار هوش مصنوعی بر اساس نوآوری جدیدی باشد که هر دو طرف معتقدند پتانسیل بازار گستردهتری دارد. در این سناریو، مشتری ممکن است مالک پیادهسازی خاص و دادهها باشد، در حالی که پیمانکار حق استفاده از بهبودهای الگوریتمی زیربنایی را در زمینههای دیگر حفظ میکند. اگرچه این روش میتواند هزینه اولیه توسعه را کاهش دهد، اما پیچیدگیهای قابل توجهی را در مورد لایسنسهای آتی و توانایی فروش شرکت یا محصول ایجاد میکند. برای اکثر سازمانهای بزرگ، مالکیت مشترک ریسکی است زیرا میتواند ابهام ایجاد کند که چه کسی مسئول نگهداری سیستم است یا چه کسی میتواند بهروزرسانیهای حیاتی را تأیید کند.
سوم، مدل لایسنس (Licensed Model) است که در آن پیمانکار مالکیت کامل نرمافزار هوش مصنوعی را حفظ میکند و مشتری برای استفاده از آن هزینه لایسنس میپردازد. این در واقع یک رویکرد نرمافزار به عنوان سرویس (SaaS) یا سرویس مدیریتشده است. مزیت این مدل، سرعت بالا و هزینه اولیه کمتر است، زیرا پیمانکار یک موتور پیشساخته ارائه میدهد که برای مشتری سفارشی شده است. اما نقطه ضعف آن، وابستگی شدید به تأمینکننده است. اگر پیمانکار قیمتها را افزایش دهد یا کیفیت خدمات افت کند، سازمان نمیتواند به سادگی کد را بردارد و در جای دیگری میزبانی کند. در زمینه هوش مصنوعی، این موضوع بهویژه زمانی خطرناک است که پیمانکار مالک نسخه «تنظیم دقیق» (Fine-tuned) مدل باشد. اگر سازمان ماهها وقت صرف ارائه دادهها برای اصلاح یک مدل کرده باشد، اما پیمانکار مالک وزنهای حاصل شود، سازمان در واقع برای بهبود محصولی هزینه کرده است که مالک آن نیست.
انتخاب مدل درست نیازمند تحلیل عمیق نقش هوش مصنوعی در کسبوکار است. اگر هوش مصنوعی یک تابع «کالایی» (Commodity) را ارائه میدهد — مانند OCR ساده اسناد یا تحلیل استاندارد احساسات — یک مدل لایسنس ممکن است کافی باشد. اما اگر هوش مصنوعی یک تابع «رقابتی» را فراهم میکند — مانند یک الگوریتم معاملاتی اختصاصی یا یک ابزار تشخیص پزشکی منحصربهفرد — مالکیت کامل غیرقابل مذاکره است. سازمان باید اطمینان یابد که قرارداد صراحتاً «وزنهای مدل» (Model Weights) را پوشش میدهد. در یادگیری ماشین، کد اغلب کمارزشتر از وزنهاست؛ یعنی همان پارامترهای عددی که در طول آموزش یاد گرفته شدهاند. اگر پیمانکار کد را تحویل دهد اما وزنها را نگه دارد، مشتری موتور را دارد اما بدون سوخت. در این میان، سازمانها برای بهینهسازی هزینهها و کنترل بیشتر، به جای مدلهای غولپیکر به سمت راهکارهای متمرکزتر حرکت کردهاند؛ به گونهای که مدلهای کوچک در رقابت هوش مصنوعی سازمانی پیروز شدند زیرا مدیریت و مالکیت آنها سادهتر است.
مسئله مالکیت دادهها لایهای مجزا اما گرهخورده است. صرفنظر از اینکه چه کسی مالک کد است، سازمان باید مالکیت مطلق دادههای ورودی و خروجی را حفظ کند. در بسیاری از پروژههای AI، پیمانکاران پیشنهاد میکنند از محیطهای ابری خودشان برای آموزش استفاده شود. این امر میتواند منجر به «گرانش داده» (Data Gravity) شود؛ وضعیتی که در آن جابجایی مجموعههای عظیم داده به زیرساخت خود سازمان، بیش از حد گران یا از نظر فنی دشوار میشود. برای جلوگیری از این اتفاق، سازمانها باید بر آموزش مدلها در ابر خصوصی مجازی (VPC) خود پافشاری کنند یا تضمین کنند که پیمانکار تعهدی قراردادی برای بازگرداندن تمام دادهها در قالبی قابل استفاده پس از پایان همکاری دارد.
حاکمیت و امنیت نیز نقش حیاتی در مالکیت دارند. وقتی سازمان مالک هوش مصنوعی است، مالک ریسک آن نیز هست. این بدان معناست که سازمان مسئول است تا اطمینان حاصل کند که AI نتایج سوگیرانه تولید نمیکند یا قوانین حریم خصوصی مانند GDPR یا CCPA را نقض نمیکند. در مدل لایسنس، بخشی از این مسئولیت ممکن است به پیمانکار منتقل شود، به شرطی که قرارداد شامل بندهای غرامت (Indemnification) قوی باشد. با این حال، برای سازمانهای بزرگ، ریسک اعتباری ناشی از «توهم» (Hallucination) — زمانی که مدل با اطمینان چیزی را میگوید که وجود ندارد — بیش از آن است که بتوان آن را کاملاً برونسپاری کرد. بنابراین، مالکیت لایه «حفاظها» (Guardrail) — یعنی کدی که خروجیهای AI را فیلتر و اعتبارسنجی میکند — برای مدیریت ریسک ضروری است.
نگهداری و فرآیند «تحویل» (Handover) اغلب نقاطی هستند که مدلهای مالکیت در عمل شکست میخورند. ممکن است در قرارداد ذکر شده باشد که مشتری مالک کد است، اما اگر پیمانکار مستندات جامع ارائه ندهد، این «مالکیت» صرفاً تئوریک است. کد بیفایده است اگر هیچکس نداند چگونه مدل را مجدداً آموزش دهد یا خط لولههای داده را بهروزرسانی کند. یک توافق مالکیت قدرتمند باید شامل یک «برنامه انتقال» (Transition Plan) یا «استراتژی خروج» (Exit Strategy) باشد. این برنامه باید تحویل یک دفترچه راهنمای فنی کامل، انتقال تمام کلیدهای API، واگذاری حقوق مدیریتی محیط ابری و یک دوره انتقال دانش (Knowledge Transfer) را که در آن پیمانکار تیم داخلی را آموزش میدهد، مشخص کند.
علاوه بر این، ظهور مدلهای زبانی بزرگ (LLMs) مفهوم «مالکیت پرامپت» را معرفی کرده است. در بسیاری از اپلیکیشنهای مدرن AI، مالکیت معنوی اصلی نه خودِ مدل (که ممکن است یک مدل شخص ثالث مانند GPT-4 باشد)، بلکه سیستم پیچیده پرامپتها و معماری تولید بازیابیافزا (RAG) است. سازمانها باید اطمینان یابند که قراردادهایشان صراحتاً «کتابخانههای پرامپت» را به عنوان IP مشتری تعریف میکند. اگر پیمانکاری شش ماه وقت صرف بهینهسازی مجموعهای از پرامپتها کند تا یک AI بتواند به عنوان یک کارشناس حقوقی ارشد برای یک شرکت خاص عمل کند، آن پرامپتها دارایی با ارزش بالایی هستند که نباید نزد پیمانکار باقی بمانند.
برای خلاصه کردن فرآیند انتخاب، سازمانها باید از یک ماتریس تصمیمگیری پیروی کنند:
۱. تعیین ارزش استراتژیک: آیا این یک شایستگی هستهای است یا یک ابزار کاربردی؟ برای شایستگیهای هستهای، مالکیت کامل را دنبال کنید.
۲. ارزیابی پیچیدگی فنی: آیا این یک ساخت سفارشی است یا پیکربندی ابزارهای موجود؟ برای ساختهای سفارشی، مالکیت وزنها و خط لولهها را تضمین کنید.
۳. سنجش پروفایل ریسک: چه کسی مسئول خطاهای AI است؟ مالکیت لایه حاکمیت را تضمین کنید.
۴. برنامهریزی برای پایان: چگونه این پیمانکار را ترک کنیم؟ یک فرآیند تحویل مستند را تضمین کنید.
در نهایت، گذار به مدلهای کسبوکار مبتنی بر هوش مصنوعی، تغییر در نحوه مدیریت برونسپاری را میطلبد. رویکرد سنتی «جعبه سیاه» (Black Box)، که در آن پیمانکار ابزاری را تحویل میدهد و آن را برای مدت نامحدود مدیریت میکند، در عصر AI یک ریسک است. سازمانهای بزرگ باید به سمت رویکرد «جعبه شفاف» (Transparent Box) حرکت کنند؛ جایی که مالکیت معنوی را در دست دارند، دادهها را کنترل میکنند و سازوکار داخلی سیستمهای AI خود را درک میکنند. با اجرای مدل مالکیت کامل یا یک مدل لایسنس با حاکمیت سختگیرانه، شرکتها میتوانند از سرعت تخصص خارجی بهره ببرند بدون اینکه استقلال استراتژیک بلندمدت خود را فدا کنند. هدف این است که از پیمانکار برای ساخت قابلیت استفاده کنید، اما تضمین کنید که این قابلیت به عنوان یک دارایی در ترازنامه سازمان باقی میماند. با تکامل مداوم هوش مصنوعی، توانایی تغییر مسیر، بازآموزی و استقرار مجدد مدلها به صورت مستقل، تمایز اصلی بین سازمانهایی خواهد بود که صرفاً از AI استفاده میکنند و سازمانهایی که واقعاً AI-powered هستند.
گام بعدی شما
- بازبینی قراردادهای فعلی برونسپاری برای شناسایی بندهای مربوط به «وزنهای مدل» و «کتابخانههای پرامپت».
- الزام پیمانکاران به استقرار مدلها در VPC سازمان برای جلوگیری از گرانش داده.
- تدوین یک «استراتژی خروج» (Exit Strategy) شامل مستندات بازآموزی مدل پیش از شروع هر پروژه جدید.
اما مدیریت هزینههای استنتاج در این مدلهای مالکیت، چالش دیگری است که در تحلیلهای آینده به آن خواهیم پرداخت.



گفتگو