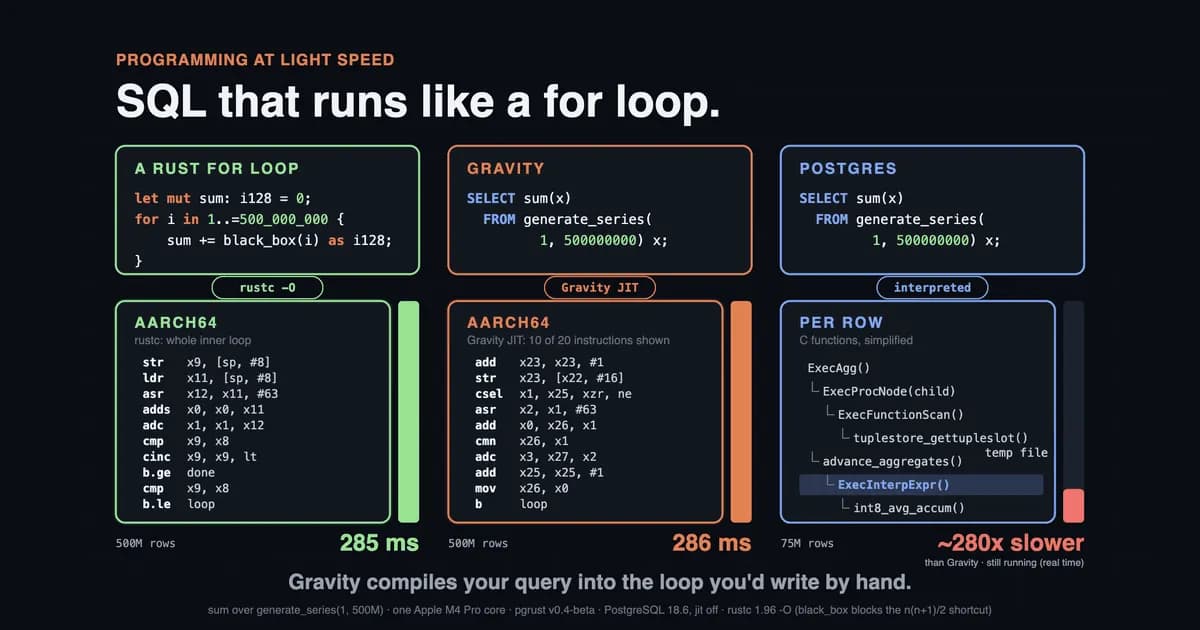
موتور پرسوجوی Gravity در انتشار pgrust v0.4-beta در محک ClickBench تا سه برابر سریعتر از ClickHouse اجرا شد. این موتور همزمان از لهجهٔ کامل SQL پستگرس پشتیبانی میکند و پرسوجوها را به کد ماشین بهینه ترجمه میکند.
معماری کامپایلر Gravity
Gravity یک خط لوله چندمرحلهای است که پرسوجوی SQL را به تدریج به اسمبلی میرساند:
- پرسوجو SQL → برنامه پستگرس (Postgres Plan)
- برنامه پستگرس → نمودار خط لوله (Pipeline Graph)
- نمودار خط لوله → IR لیسپی (Lisp IR)
- IR لیسپی → اسمبلی (Assembly)
هر مرحله نمایش میانی است که به مرحله بعد پس از lowering (تبدیل به کد ماشین) میشود. این طراحی انعطافپذیری بالا در تولید بهینهسازیهای سطح پایین فراهم میکند. همانطور که در مورد استفاده از Claude برای بهینهسازی کوئریهای PostgreSQL گزارش شده، تیم pgrust نیز از Claude برای نوشتن کدهای Rust بهینه در برابر فرمت ستونمحور بهره گرفت.
از کپی-و-چسب تا IR کامل
در انتشارهای قبلی تیم pgrust از دستهبندی (batching)، ادغام عملگرها (operator fusion) و SIMD برای سرعتبخشی صدها برابرتی استفاده کرده بود. یک کامپایلر JIT کپی-و-چسب (copy-and-patch JIT) نیز استنسلها (stencil) را در ۵ میکروثانیه کامپایل میکرد. اما چسباندن قالبهای ازپیشکامپایلشده بدون یک نمایش میانی واقعی و تخصیص ثبات (register allocation) در کل حلقه، عملکرد زیادی را نسبت به کامپایلرهای بهینهساز مانند rustc یا Clang روی میز میگذاشت. Gravity این محدودیت را با یک IR کامل برطرف میکند.
برنامهنویسی با سرعت نور
تیم به جای بهینهسازی تدریجی (bottom-up)، از سقف فیزیکی سختافزار و فرمت فایل آغاز کرد و به عقب بازگشت — رویکردی که «برنامهنویسی با سرعت نور» نامید. برای یافتن این سقف، از Claude خواسته شد برنامههای Rust مستقل و بهشدت بهینه مستقیماً در برابر فرمت ذخیرهسازی ستونمحور (columnar storage format) بنویسد که تنها یک ستون را اسکن و یک تجمع (sum یا count) محاسبه میکردند. این برنامهها از تمام ترفندها — SIMD، پیش واکشی (prefetching)، گشودن حلقه (loop unrolling)، کد بدون انشعاب (branchless code) — استفاده میکردند. سریعترین آنها ستون را با حدود ۲۵ گیگابایت بر ثانیه روی پردازندههای مدرن اسکن کرد. این عدد هدف «سرعت نور» شد.
عملکرد اسکن و فیلتر در حد فیزیکی
بینش کلیدی Gravity این است که بیشتر عملکرد یک پرسوجو از اسکن و فیلتر ناشی میشود؛ بقیه — جویین (join)، گروهبندی (group by)، مرتبسازی (sort) — معمولاً ارزانترند. بنابراین Gravity روی بهینهسازی اسکن و فیلتر تمرکز میکند. برای مثال اگر روی یک ستون رشتهای فیلتر کنید، Gravity کدی تولید میکند که از دستورهای SSE یا AVX برای مقایسهٔ موازی رشتهها استفاده میکند. اگر اعداد صحیح جمع کنید، از SIMD برای جمعکردن موازی بهره میبرد. نتیجه: کد تولیدشده برای اسکن و فیلتر در ۱۰ درصد از حداکثر سرعت نظری قرار میگیرد. بقیه پرسوجو توسط یک موتور عمومیتر اجرا میشود که همچنان بهاندازهای سریع است که زمان کل را غالب نمیکند.
پشتیبانی از پرسوجوهای پیچیده و گسترشپذیری
چون Gravity SQL را به کد ماشین کامپایل میکند، هر ویژگی SQL که در IR قابل بیان باشد پشتیبانی میشود. این یعنی پرسوجوهای پیچیده با جویینهای متعدد، زیرپرسوجوها و توابع پنجرهای (window functions) هم همسرعت اسکنهای ساده اجرا میشوند. تیم مواردی دیده که Gravity روی پرسوجوهای پیچیده ۱۰ برابر از پایگاهدادههای دیگر سریعتر است. معماری Gravity هم قابل گسترش است: نوع داده جدید، تابع جدید، عملگر جدید به IR اضافه میشوند بدون تغییر در تولیدکننده کد. این امکان تطبیق آسان Gravity برای کاربردهای نوظهور مانند یادگیری ماشین (machine learning) یا تحلیل سریهای زمانی (time-series analytics) را میدهد.
گام بعدی شما
- pgrust v0.4-beta را امتحان کنید و پرسوجوهای تحلیلی واقعی خود را روی ClickBench یا دادههای خود بسنجید.
- معماری IR را بررسی کنید اگر به توسعه موتورهای پرسوجو یا کامپایلرهای SQL علاقه دارید؛ طراحی IR ساده اما بیانگرا الگوی قابل تکراری است.
- مقایسه هزینه استنتاج را در نظر بگیرید: اگر بارهای کاری تحلیلی سنگین دارید، کاهش ۳ برابر زمان اجرا مستقیماً به کاهش هزینه سختافزاری و انرژی تبدیل میشود.
گفتگو