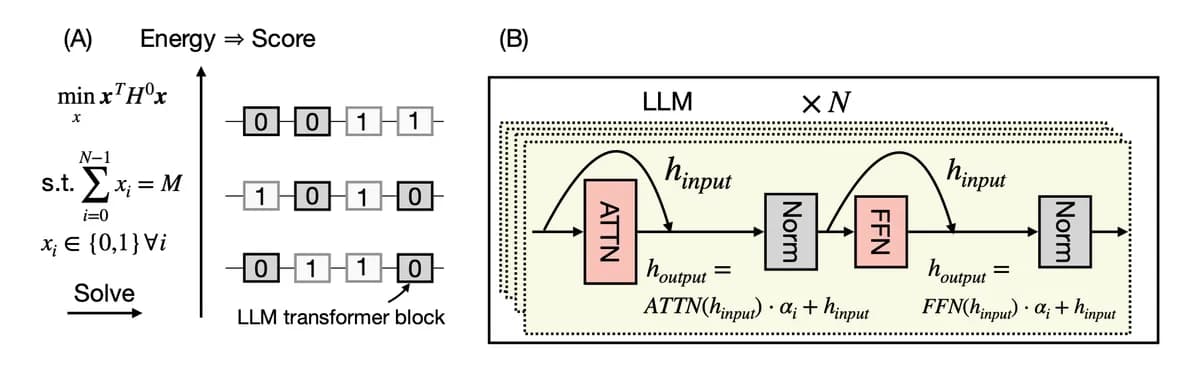
تصور کنید بخواهید یک ساختمان عظیم را کوچک کنید، اما بهجای تخریب تصادفی دیوارها، دقیقاً بدانید کدام ستونها با هم در ارتباطاند تا سقف فرو نریزد. در دنیای مدلهای زبانی، این یعنی حذف لایههای اضافی بدون اینکه مدل «احمق» شود.
تلاش برای دستیابی به کارایی در مدلهای زبانی بزرگ (LLMs) اغلب منجر به یک توازن بنیادی بین ظرفیت مدل و سرعت استنتاج میشود. در میان استراتژیهای مختلف برای کاهش ردپای محاسباتی این مدلها، حذف بلوکها — که به عنوان «هرس کردن عمقی» (Depth Pruning) نیز شناخته میشود — به عنوان یکی از مستقیمترین و اثرگذارترین روشها برجسته است. با حذف کامل بلوکهای ترنسفورمر، مدل از نظر فیزیکی کوتاهتر میشود که منجر به افزایش سرعت پیشبینیپذیر در استنتاج و صرفهجویی قابلتوجه در حافظه میگردد. علاوه بر این، حذف بلوکها با سایر تکنیکهای فشردهسازی مانند کوانتیزاسیون (Quantization) و فشردهسازی کمرتبه (Low-rank Compression) سازگاری بالایی دارد و اجازه میدهد یک رویکرد لایهای برای بهینهسازی مدل اتخاذ شود.
به نقل از مستندات پژوهشی اخیر، یکی از مستقیمترین راهها برای افزایش سرعت استنتاج (Inference) و کاهش مصرف حافظه، حذف کامل بلوکهای ترنسفورمر (Transformer) است. این تلاشها در راستای بهینهسازی زمان پاسخدهی است، مشابه آنچه در راهکارهای کاهش تأخیر از طریق رمزگشایی گمانهزنانه و حافظه KV بررسی کردیم تا سرعت تعامل با مدل افزایش یابد. اما چالش اصلی در فرآیند انتخاب نهفته است: تصمیمگیری در مورد اینکه دقیقاً کدام بلوکها حذف شوند بدون اینکه باعث فروپاشی عملکرد مدل شود. این یک مسئله رتبهبندی ساده نیست که در آن کماهمیتترین بلوکها دور ریخته شوند؛ بلکه یک مسئله ترکیبی پیچیده است، زیرا تأثیر حذف یک بلوک بهطور جداییناپذیری با این موضوع مرتبط است که کدام بلوکهای دیگر همزمان با آن حذف میشوند. این تعاملات به این معناست که مجموعه بهینه بلوکهایی که باید حفظ شوند، لزوماً مجموعهای از «بهترین» بلوکهای فردی نیستند.
برای حل این معما، پژوهشگران به فیزیک سیستمهای اسپین و بهویژه «مدل ایسینگ» (Ising Model) روی آوردهاند. در فیزیک، یک «شیشه ایسینگ» (Ising glass) یک سیستم اسپین نامنظم است که با تعاملات همهجانبه (all-to-all) و تعداد ثابتی از اسپینهای «بالا» یا «پایین» مشخص میشود. با بازتعریف انتخاب بلوک به عنوان یک مسئله بهینهسازی باینری محدود (CBO)، وظیفه هرس کردن یک LLM مستقیماً بر روی این چارچوب فیزیکی منطبق میشود. در این نگاشت، هر بلوک ترنسفورمر به عنوان یک اسپین در نظر گرفته میشود؛ حالت «بالا» یعنی بلوک حفظ شود و حالت «پایین» یعنی حذف گردد.
طبق این رویکرد، «انرژی» این سیستم اسپین به عنوان معیاری برای پیشبینی عملکرد مدل نهایی استفاده میشود. از آنجا که محاسبه این انرژی در مقایسه با اجرای بنچمارکهای کامل، از نظر محاسباتی بسیار ارزان است، پژوهشگران میتوانند تعداد بسیار زیادی از پیکربندیهای کاندید را بهسرعت ارزیابی کنند. این تغییر دیدگاه، فرآیند هرس کردن را از یک جستجوی مبتنی بر اکتشاف (Heuristic) به یک مسئله بهینهسازی دقیق تبدیل میکند که میتوان آن را با استفاده از حلکنندههای کلاسیک و الهامگرفته از کوانتوم حل کرد.
همانطور که در تحلیلهای پیشین ما دربارهی بهینهسازی مدلهای بازمتن اشاره کردیم، اکثر روشهای فعلی از رویکردهای «میدان میانگین» (Mean-field) استفاده میکنند. این روشها هر بلوک را بهصورت مستقل بر اساس معیارهایی مانند اندازه (Magnitude)، حساسیت یا «تأثیر بلوک» امتیازدهی کرده و سپس بلوکهایی با کمترین امتیاز را حذف میکنند. نقص این منطق در فرض «استقلال» است. در یک شبکه عصبی (Neural Network) عمیق، لایهها بهشدت به هم وابسته هستند؛ نمایش یادگرفته شده توسط لایه N، ورودی لایه N+1 است. بنابراین، حذف لایه N، زمینه (Context) را برای تمام لایههای بعدی تغییر میدهد، به این معنی که «اهمیت» لایه N+1 پویا است.
رویکرد مبتنی بر ایسینگ با تبدیل این مسئله به یک «مسئله چندجسمی»، این تعاملات را در نظر میگیرد. این متد تشخیص میدهد که برخی بلوکها ممکن است تنها زمانی زائد باشند که بلوکهای خاص دیگری حضور داشته باشند، یا برعکس، دو بلوک متوسط ممکن است در کنار هم عملکردی حیاتی را ارائه دهند که هیچکدام بهتنهایی قادر به ارائه آن نبودند.
بر اساس نتایج بهدستآمده، این متد در رژیمهای فشردهسازی شدید خیرهکننده عمل میکند. هنگام اعمال این روش روی مدل Llama-3.3-70B-Instruct با نرخ فشردهسازی ۵۰٪، بهینهسازی ایسینگ در آزمون MMLU حدود ۲۳ درصد امتیاز بیشتری نسبت به بهترین روشهای رقیب در حذف بلوک کسب کرد. این دستاورد یادآور موفقیتهای مشابه در بهینهسازی موتورهای اجرای کوچکتر مانند ZGCM-1 است که نشان میدهد مدلهای با پارامتر کمتر میتوانند با معماری بهینه، نتایجی در سطح مدلهای غولپیکر کسب کنند. این عدد ثابت میکند که ماهیت ترکیبی تعاملات بلوکی، عاملی غالب در تخریب مدل در هنگام هرس کردن است. با بهینهسازی پیکربندی به عنوان یک کل، بهجای هرس کردن اجزای فردی، مدل منطق داخلی منسجمتری را حفظ کرده و علیرغم کاهش شدید اندازه، تواناییهای استدلالی بیشتری را حفظ میکند.
علاوه بر عملکرد، این متدولوژی راه را برای استفاده از سختافزارهای تخصصی برای فشردهسازی مدل باز میکند. از آنجا که مسئله به صورت یک بهینهسازی باینری محدود (CBO) فرموله شده، برای ماشینهای ایسینگ مبتنی بر CMOS یا حتی کوانتوم آنیلرها (Quantum Annealers) ایدهآل است. این حلکنندهها بهطور خاص برای یافتن کمینه جهانی (Global Minimum) در چشماندازهای انرژی در سیستمهایی با تعاملات پیچیده طراحی شدهاند، که دقیقاً همان چیزی است که برای یافتن معماری بهینه هرس شده یک LLM مورد نیاز است. این پیوند میان یادگیری عمیق و فیزیک ماده چگال نشان میدهد که بهینهسازی ساختاری شبکههای عصبی مصنوعی میتواند از ابزارهای ریاضی توسعهیافته برای درک رفتار مواد مغناطیسی بهره ببرد.
علاوه بر این، کارایی پروکسی انرژی اجازه میدهد تا رویکردی تکرارشوندهتر و تجربیتر برای هرس کردن اتخاذ شود. بهجای صرف روزها وقت برای بنچمارک کردن تعداد محدودی از کاندیدهای هرس شده، توسعهدهندگان میتوانند میلیونها معماری بالقوه را در کسری از زمان غربال کنند. این امر امکان کشف الگوهای هرس غیرشهودی را فراهم میکند؛ پیکربندیهایی که در آنها بلوکهای حذف شده لزوماً آنهایی نیستند که کمترین وزنها را دارند، بلکه بلوکهایی هستند که حذف آنها پایدارترین شبکه باقیمانده را ایجاد میکند. این موضوع این باور سنتی را که «اهمیت» یک ویژگی استاتیک از یک لایه است، به چالش میکشد و در عوض مطرح میکند که اهمیت، یک ویژگی رابطهای از توپولوژی شبکه است.
در نهایت، تبدیل حذف بلوکهای LLM به یک مسئله بهینهسازی ایسینگ، نشاندهنده یک تغییر پارادایم از اکتشافات محلی به بهینهسازی جهانی است. با پذیرش اینکه حذف بلوکهای ترنسفورمر یک مسئله چندجسمی است، این روش به عملکردی برتر در مدلهای بهشدت فشرده دست مییابد. توانایی نگاشت هرس شبکه عصبی بر روی یک سیستم اسپین فیزیکی، نه تنها کیفیت مدلهای حاصل را بهبود میبخشد، بلکه مسیری روشن برای استفاده از محاسبات الهامگرفته از کوانتوم جهت خودکارسازی طراحی هوش مصنوعی کارآمد فراهم میکند. با ادامه رشد اندازه مدلها، نیاز به چنین تکنیکهای پیچیده هرس کردنی افزایش خواهد یافت و تقاطع فیزیک و یادگیری ماشین را به مرزی حیاتی برای آینده هوش مصنوعی مقیاسپذیر تبدیل میکند.
گام بعدی شما
- بررسی متدهای کوانتیزاسیون (Quantization) برای ترکیب با هرس کردن عمقی جهت دستیابی به حداکثر فشردهسازی.
- مطالعه مستندات مربوط به ماشینهای ایسینگ برای درک نحوه تسریع سختافزاری فرآیند Pruning.
- آزمایش مدلهای کوچکتر (SLM) با رویکرد حذف بلوکهای وابسته بهجای حذف لایههای تکبهتک.
اما داستان سختافزاری این تحول حتی شگفتانگیزتر است — به تحلیل ما دربارهی تراشههای Blackwell و آینده استنتاج بهینه مراجعه کنید.



گفتگو