اگر امروز برای بهبود کیفیت بازیابی دادهها در سیستم خود مدلهای گرانتر را جایگزین میکنید، احتمالاً دارید روی یک زیربنای شکسته ساختمان میسازید. یک بازرسی دادهای که در ۱۴ سپتامبر ۲۰۲۶ انجام شد، فاش کرد که تکهبندی با اندازه ثابت (Fixed-size chunking) — ابتداییترین روش خرد کردن متن برای تولید بازیابیافزا (RAG) — در ۹۸٪ موارد جملات را درست در میانه یک ایده میبُرد.
این یعنی وقتی سیستم بازیابی شما پاسخ اشتباه میدهد، مشکل لزوماً از مدل بردار معنایی (Embedding) — که مثل یک کارت معرفی عددی برای هر واژه است و میگوید این کلمه همسایه چه کلمات دیگری است — نیست؛ بلکه مشکل در این است که پاسخ در فهرست شما اصلاً به شکل یک واحد منسجم وجود ندارد. این چالشها نشان میدهند که چگونه لایه ورود داده میتواند به گلوگاه پنهانی تبدیل شود که کل سیستم RAG را با شکست مواجه میکند.
بسیاری از توسعهدهندگان تکهبندی را یک تنظیم ساده و «یکبار برای همیشه» میبینند. طبق گزارش منتشر شده در dev.to، وقتی کیفیت بازیابی افت میکند، واکنش رایج این است که مدل بردار معنایی را با مدلی که نمره بنچمارک بالاتری دارد عوض کنند. اما اگر یک تکه متن در وسط یک جمله حیاتی قطع شود، هیچ مدل پیشرفتهای نمیتواند بافتار (Context) گمشده را بازسازی کند.
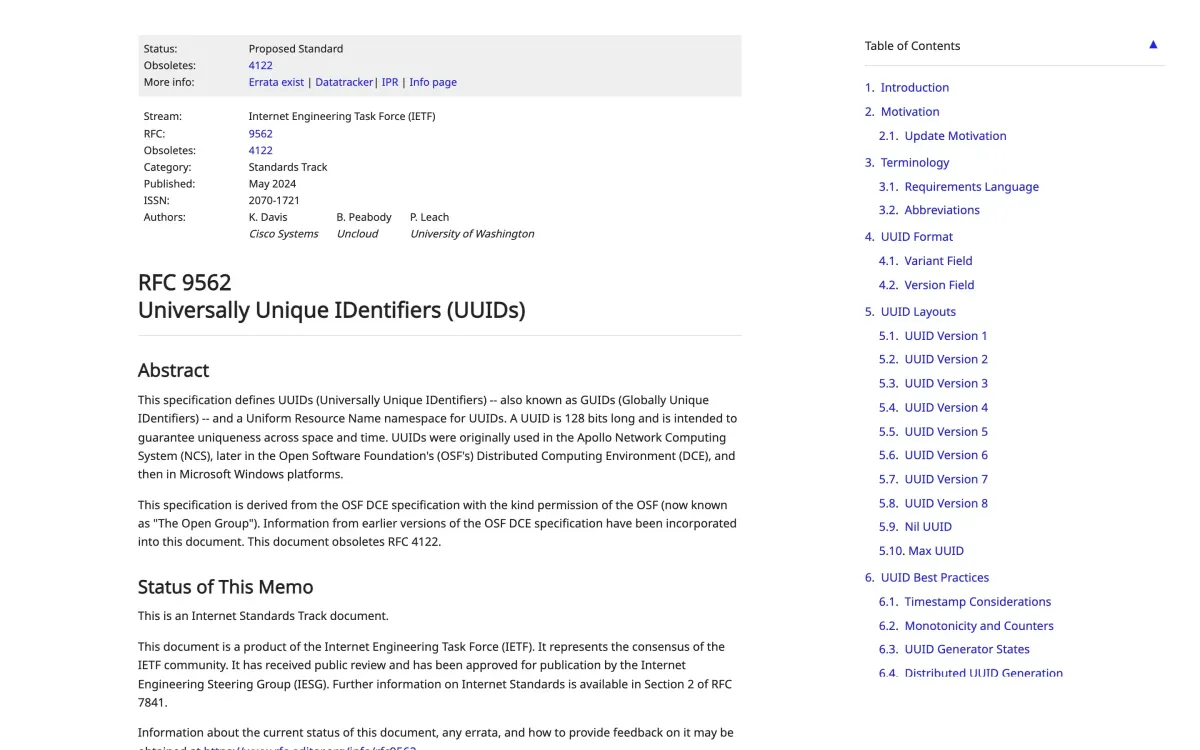
برای اندازهگیری دقیق این بحران، آزمونی روی مستندات RFC 9562 (مشخصات UUID) اجرا شد. این سند شامل ۱۱۴٬۶۲۹ نویسه و ۶۱۶ جمله است. هدف این بود که بهجای اندازه متوسط تکهها، «محل قرارگیری مرزها» بررسی شود تا مشخص شود برشها روی پایان جملات میافتند یا وسط آنها.
شکاف عملکردی
بر اساس مستندات این گزارش، چهار استراتژی رایج نتایج کاملاً متفاوتی داشتند:
- تکهبندی با اندازه ثابت: در ۹۸٪ موارد (۱۱۲ برش بد از مجموع ۱۱۴ مورد) مرز برش در وسط جمله قرار گرفت.
- اندازه ثابت با همپوشانی (Overlap): عملکرد بدتری داشت و ۹۹٪ برشها در وسط جمله بود. اگرچه همپوشانی باعث میشود متن بریده شده در تکه بعدی ظاهر شود، اما هزینه استنتاج را ۲۵٪ افزایش داد (۱۴۳٬۲۲۹ نویسه در برابر ۱۱۴٬۶۲۹).
- تکهبندی بازگشتی (Recursive splitting): استاندارد فعلی صنعت که با اولویت دادن به شکستهای پاراگراف و سپس خطوط جدید، نرخ برشهای بد را به ۱۰٪ رساند.
- تکهبندی پاراگرافمحور: با در نظر گرفتن پاراگرافها به عنوان واحدهای تجزیهناپذیر، به نرخ خطای ۰٪ رسید.
همانطور که در تحلیلهای قبلی ما درباره امنیت و بهینهسازی مدلهای زبانی اشاره کردیم، جزئیات کوچک در لایه دادهها اغلب اثر بیشتری نسبت به تغییر مدل دارند. بسیاری از تیمها از «همپوشانی» به عنوان تور نجات برای جلوگیری از دست رفتن دادهها استفاده میکنند، اما دادهها نشان میدهد این یک اشتباه هزینهبر است. در تست RFC 9562، همپوشانی ۲۵٪ بردار بیشتر به ایندکس اضافه کرد و هزینه ذخیرهسازی را بالا برد، بدون اینکه مشکل مرزهای متن را حل کند؛ در واقع فقط آسیب را در تکه مجاور تکرار کرد. این موضوع تأیید میکند که بسیاری از نقصهای زنجیره RAG پیش از آنکه دادهها به LLM برسند، در مراحل بازیابی رخ میدهند.
البته تکهبندی پاراگرافمحور هم بدون هزینه نیست. این روش باعث ایجاد تکههایی با اندازه نامساوی میشود. یک تکه ۲۰۰ نویسهای و یک تکه ۹۰۰ نویسهای، هنگام تبدیل به بردار، دقت یکسانی ندارند. این موضوع باعث میشود تکههای کوتاهتر در لیست شباهتها بیش از حد برجسته شوند و نتایج را منحرف کنند.
تکهبندی بازگشتی در اینجا نقش میانبر را دارد. این روش یکنواختی بهتری نسبت به مدل پاراگرافمحور دارد و ۹۰٪ آسیبهای برشهای ثابت را حذف میکند؛ به همین دلیل است که در اکثر فریمورکهای مدرن به پیشفرض تبدیل شده است. در همین راستا، راهکارهای جدیدی برای جلوگیری از قطع جملات معرفی شدهاند تا از دست رفتن معنای متون در هنگام تکهبندی جلوگیری شود.
بهینهسازی خط لوله ورود داده
برای بهبود کیفیت بازیابی، این تحلیل پنج اقدام فوری را پیشنهاد میکند:
۱. ترک تکهبندی با اندازه ثابت: در متون نوشتاری هیچ موردی وجود ندارد که اندازه ثابت بر تکهبندی بازگشتی برتری داشته باشد.
۲. استفاده از مدل پاراگرافمحور برای متون ساختاریافته: مستندات API و قراردادها بیشترین بهره را از این روش میبرند.
۳. محدود کردن همپوشانی: فقط برای خروجیهای OCR یا ترنسکریپتهای بدون ساختار از آن استفاده کنید.
۴. سنجش مرزها بهجای اندازه: بهجای توزیع طول تکهها، تعداد ایدههای نصفشده را اندازه بگیرید.
۵. پاکسازی اولیه ورودی: قبل از تکهبندی، سینتکس Markdown و نویسههای نامرئی PDF را حذف کنید تا مرزهای «شبحی» ایجاد نشود.
برای کسانی که با متونی غیرانگلیسی کار میکنند، گزارش هشدار میدهد که بودجه نویسهها فریبدهنده است. در حالی که ۲۵۰ توکن انگلیسی در ۱٬۰۰۰ نویسه جای میگیرند، این نسبت در زبانهای دیگر بهشدت تغییر میکند و عملاً پنجره زمینه (Context Window) — یعنی میز کاری مدل که تعیین میکند چه مقدار متن را همزمان در ذهن نگه دارد — را در هر تکه کاهش میدهد.
این تغییر دیدگاه نشان میدهد که پیچ تنظیم عملکرد RAG بسیار زودتر از آنچه فکر میکردیم، در ابتدای خط لوله قرار دارد. با حل مشکل مرزها، توسعهدهندگان میتوانند بهجای تعقیب پیشرفتهای جزئی در بنچمارکهای مدلها، تضمین کنند که دادههایشان واقعاً قابل بازیابی است.
گام بعدی شما
- روی نمونهای از اسناد خود یک «شمارش مرز» (Boundary Count) اجرا کنید تا ببینید چند درصد جملات شما نصف شدهاند.
- اگر از تکهبندی ثابت استفاده میکنید، آن را به RecursiveTextSplitter در LangChain یا معادل آن در LlamaIndex تغییر دهید.
- در متون تخصصی، استراتژی پاراگرافمحور را جایگزین همپوشانیهای سنگین کنید تا هزینه GPU کاهش یابد.
اما داستان سختافزاری این تحول حتی شگفتانگیزتر است — به تحلیل ما درباره تراشههای Blackwell مراجعه کنید.



گفتگو