اگر هر بار با خروجی اشتباه مدل، به سراغ مدلهای بزرگتر یا افزودن مثالهای بیشتر در پرامپت میروید، احتمالاً ریشه مشکل را نادیده گرفتهاید. این واکنشهای غریزی بهندرت علت اصلی شکست را حل میکنند. طبق راهنمای فنی منتشر شده توسط SotaTek در ۱۲ اکتبر ۲۰۲۶، گرانترین اشتباه در توسعه مدلهای زبانی (LLM)، اعمال یک راهکار رفتاری برای حل مشکلی است که در واقع مربوط به دسترسی به دانش است.
بیشتر شکستهای هوش مصنوعی در سازمانها به دو دسته کلی تقسیم میشوند: دسترسی به دانش و رفتار. شکست در دسترسی به دانش زمانی رخ میدهد که مدل پاسخی قدیمی یا نادرست میدهد، چون آخرین سیاستها یا دادههای بهروز هرگز به پنجره زمینه (Context Window) — مثل میز کاری که جا برای چند ورق دارد، نه برای کل کتابخانه — نرسیده است. در مقابل، شکست رفتاری زمانی است که مدل تمام دادههای لازم را در اختیار دارد، اما بارها در رعایت یک فرمت خروجی خاص یا دنبال کردن دستورالعملهای ساختاری شکست میخورد.
برای حل این مسئله، مهندسان باید اپلیکیشن را به صورت یک پشته سه لایه ببینند. لایه اول بازیابی (Retrieval) است که سیستم در آن به دنبال شواهد میگردد. لایه دوم زمینه (Context) است که شواهد در آن فیلتر شده و به مدل ارسال میشوند. لایه سوم تولید (Generation) است که مدل در آن پاسخ نهایی را ترکیب و سنتز میکند.
تشخیص لایه شکست
اگر سیستم نمیتواند شواهد درست را پیدا کند، مشکل در لایه بازیابی است. در این حالت، بزرگتر کردن مدل کمکی نمیکند، چون اگر سند درست در رتبههای اول نتایج نباشد (مثلاً خارج از ۵ نتیجه اول باشد)، مدل هر چقدر هم قدرتمند باشد، به آن دسترسی ندارد. راهکار اینجاست که استراتژیهای جستوجو، متادیتا یا تکهبندی (Chunking) را بهبود ببخشید. برای ارتقای این لایه، استفاده از روابط ساختاریافته میتواند دقت استدلال در سیستمهای RAG را به طور چشمگیری افزایش دهد.
اگر شواهد بازیابی شدهاند اما مدل آنها را نادیده میگیرد، مشکل در لایه زمینه است. این وضعیت نیازمند ساختار بهتر پرامپت یا انتخاب دقیقتر زمینه است تا مدل یاد بگیرد اولویت را به شواهد ارسالی بدهد و به جای تکیه بر آموزشات داخلی خود، از دادههای فراهم شده استفاده کند.
تنها زمانی که مدل شواهد درست را دارد اما فرمت خروجی نامنظم یا متناقض است، با شکست در تولید روبرو هستیم. این تنها سناریویی است که تنظیم دقیق (Fine-tuning) — مثل وقتی به یک پزشک عمومی، تخصص پوست میدهیم تا روی یک حوزه دقیق شود — به عنوان راهکار اصلی پیشنهاد میشود.
چارچوب تشخیصی دقیق
به نقل از SotaTek، برای جلوگیری از اشتباهِ تغییر مدل در زمان شکست بازیابی، باید از یک ماتریس تشخیصی خاص استفاده کرد:
- لایه بازیابی: این سوال را بپرسید: «آیا سیستم شواهد درست را یافت؟» اگر پاسخ منفی است، مداخله باید روی بهبود جستوجو، متادیتا، تکهبندی یا بازرتبهبندی (Reranking) متمرکز شود.
- لایه زمینه: این سوال را بپرسید: «آیا شواهد مرتبط به مدل رسید؟» اگر پاسخ منفی است، تمرکز باید روی بهبود انتخاب زمینه و ساختار پرامپت باشد.
- لایه تولید: این سوال را بپرسید: «آیا مدل از شواهد درست استفاده کرد؟» اگر پاسخ منفی است، تمرکز باید روی بهبود پرامپتینگ، اعتبارسنجی یا ارزیابی امکان تنظیم دقیق باشد.
مکانیسمهای RAG
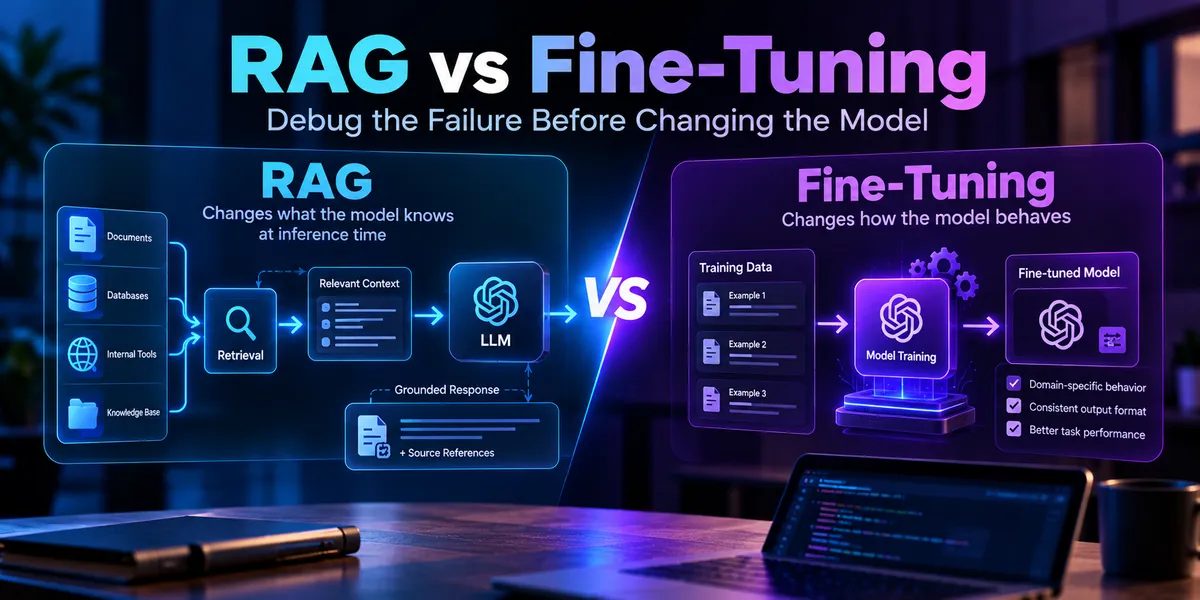
تولید بازیابیافزا (RAG) — مثل دانشآموزی که قبل از جواب دادن، اول کتاب درسی را باز میکند و از آن نقل میآورد — اطلاعات در دسترس مدل را در زمان استنتاج (Inference) تغییر میدهد بدون اینکه وزنهای مدل را دستکاری کند. این فرآیند از یک خط لوله مشخص پیروی میکند: پرسوجوی کاربر $ \rightarrow $ پردازش پرسوجو $ \rightarrow $ جستوجو/بازیابی $ \rightarrow $ بازرتبهبندی و انتخاب زمینه $ \rightarrow $ مدل LLM + شواهد بازیابی شده $ \rightarrow $ پاسخ + مراجع منابع.
این روش برای اطلاعات خصوصی، متغیر یا نیازمند ردیابی (مثل کاتالوگ محصولات داخلی، مستندات فنی، سوابق مشتریان یا سیاستهای داخلی شرکت) ایدهآل است. بهروزرسانی یک سیستم RAG به سادگیِ ایندکس کردن مجدد یک منبع دانش است و نیاز به چرخههای هزینهبر آموزش مجدد را هر بار که یک سیاست شرکت تغییر میکند، از بین میبرد. برای پیادهسازی این ساختار، مقایسه چارچوبهای مختلف RAG از نظر سختافزار و حریم خصوصی میتواند در انتخاب ابزار مناسب کمککننده باشد.
مکانیسمهای تنظیم دقیق
تنظیم دقیق، وزنهای مدل پیشآموزشدیده را با استفاده از مثالهای ورودی-خروجی خاص تغییر میدهد تا یک رفتار مطلوب تقویت شود. برای مثال، تبدیل یک گزارش حادثه خام به یک طرح JSON ثابت، یک وظیفه رفتاری است. یک جفت آموزشی نمونه میتواند به این شکل باشد:
- ورودی: «تاول در سطح نزدیک به کانکتور شناسایی شد.»
- خروجی:
{ "category": "MATERIAL_DELAMINATION", "severity": "S2", "inspection_route": "MICROSCOPY" }
تنظیم دقیق برای یاد دادن حقایق جدید درباره اتفاقات دیروز نیست؛ بلکه برای سازگار کردن مدل در انجام طبقهبندیهای تخصصی، استخراج ساختاریافته، تبدیلهای خاص دامنه یا کارهای حجیمی است که در آنها هزینه پرامپت و کارایی استنتاج حیاتی است.
ایجاد خط پایه (Baseline)
همانطور که در تحلیلهای قبلی ما درباره بهینهسازی مدلهای زبانی اشاره کردیم، اندازهگیری دقیق پیش از هر تغییری ضروری است. SotaTek توصیه میکند ابتدا یک خط پایه با استفاده از موارد تست نماینده ایجاد کنید. یک خط پایه نمونه ممکن است معیارهای زیر را ردیابی کند:
- صحت پاسخ: ۷۱٪
- میزان مبنیسازی (Groundedness): ۶۸٪
- رعایت فرمت: ۹۱٪
- نرخ بازیابی (Recall@5): ۶۲٪
اندازهگیری جداگانه بازیابی و تولید حیاتی است. اگر نرخ بازیابی ضعیف باشد (مانند مثال ۶۲٪)، تنظیم دقیق مدل تولیدکننده اتلاف منابع است، چون مدل همچنان با اطلاعات ناقص کار میکند. در واقع، انتخاب بین مکانیسمهای RAG و تنظیم دقیق برای کاهش هزینههای عملیاتی مستقیماً به این نتایج اندازهگیری وابسته است.
ارزیابی اجزای RAG
در یک سیستم RAG، لایه بازیابی باید مستقل از لایه تولید سنجیده شود. یک تابع ارزیابی ساده شده میتواند recall_at_5 را با مقایسه retrieved_ids در برابر expected_doc_ids ردیابی کند.
در محیط عملیاتی، این ارزیابی باید گسترش یابد تا مواردی چون چندین سند مرتبط، رتبهبندی بازیابی، نتایج خالی، مجوزهای دسترسی و درجهبندی کیفیت پاسخ را مدیریت کند. بدون این تفکیک، یک امتیاز کلی برای کیفیت پاسخ فقط میگوید «چیزی شکست خورده»، اما نمیگوید «کجا» باید بررسی شود.
ساخت RAG در مقیاس صنعتی
یک خط لوله ساده (سند $ \rightarrow $ بردار $ \rightarrow $ پایگاهداده برداری) برای محیط تولید کافی نیست. سیستمهای حرفهای به جریان پیچیدهتری نیاز دارند:
- پردازش سند: تجزیه سند (Parsing)، استخراج ساختار، تکهبندی و غنیسازی متادیتا.
- استراتژی جستوجو: ترکیب جستوجوی برداری، لغتنامهای (Lexical) یا ترکیبی (Hybrid) به همراه بازنویسی پرسوجو.
- بهبود: فیلترهای مبتنی بر سطح دسترسی، بازرتبهبندی و انتخاب زمینه.
- خروجی: نقشهبرداری استنادی و ارزیابی مبنیسازی.
نکته حیاتی این است که مجوزهای دسترسی (Authorization) باید در لایه اپلیکیشن اعمال شوند. در یک اپلیکیشن سازمانی چندمستاجری (Multi-tenant)، بازیابی باید مجوزهای کاربر را پیش از ارسال اسناد به مدل اعمال کند. فیلتر کردن پاسخ نهایی جایگزینی برای جلوگیری از ورود زمینههای غیرمجاز به خط لوله تولید نیست.
زمان ارزیابی تنظیم دقیق
تنظیم دقیق زمانی توجیه میشود که مدل اطلاعات کافی را دریافت میکند اما باز هم در انجام وظیفه شکست میخورد. نشانههای کلیدی عبارتند از:
- ناپایداری در فرمت خروجی علیرغم دستورات واضح.
- نتایج متناقض در وظایف طبقهبندی تخصصی.
- درک نادرست مکرر از اصطلاحات تخصصی دامنه.
- بزرگ شدن بیش از حد پرامپت به دلیل نیاز به مثالهای Few-shot زیاد.
- زمانی که یک مدل کوچکتر نیاز دارد رفتاری را بازتولید کند که قبلاً با مدل بزرگتر به دست آمده بود.
حتی در این شرایط، ابتدا باید دستورات واضحتر یا محدودیتهای خروجی ساختاریافته را امتحان کرد. اگر آموزش آغاز شد، دادهها باید به صورت ۷۰/۱۰/۲۰ بین مجموعههای آموزش، اعتبارسنجی و آزمون (Holdout) تقسیم شوند. SotaTek استفاده از ابزارهایی مثل train_test_split را توصیه میکند. برای مجموعهدادههای تولیدی، تقسیمبندی باید بر اساس واحد (مشتری، سند یا بازه زمانی) باشد تا از نشت مثالهای تقریباً مشابه بین مجموعهها جلوگیری شود.
مقایسه هزینههای کل سیستم
این دو روش هزینهها را به بخشهای مختلف منتقل میکنند و توازنهای زیر را ایجاد میکنند:
- مهندسی اولیه: RAG روی جذب داده و بازیابی تمرکز دارد؛ تنظیم دقیق روی آمادهسازی مجموعه داده و آموزش.
- بهروزرسانی دانش: RAG نیاز به همگامسازی یا ایندکس مجدد منابع دارد؛ تنظیم دقیق ممکن است نیاز به یک چرخه تنظیم مجدد داشته باشد.
- تأخیر استنتاج: RAG مراحل بازیابی و بازرتبهبندی را اضافه میکند؛ تنظیم دقیق ممکن است مسیر استنتاج را سادهتر کند.
- اندازه پرامپت: زمینه در RAG میتواند حجیم باشد؛ تنظیم دقیق نیاز به مثالهای پرامپت را کاهش میدهد.
- نگهداری: RAG روی تازگی دادهها تمرکز دارد؛ تنظیم دقیق روی نسخههای مدل و مدیریت آرتیفکتها.
- ردیابی: RAG از طریق متادیتا امکان ردیابی منبع را میدهد، اما تنظیم دقیق ذاتاً این قابلیت را فراهم نمیکند.
رویکرد ترکیبی
برخی اپلیکیشنهای پیچیده به هر دو نیاز دارند. یک دستیار انطباق سازمانی باید آخرین مقررات را بازیابی کند (RAG)، بندها را مقایسه کرده، طرح طبقهبندی خاص سازمان را اعمال کند (تنظیم دقیق) و خروجی ساختاریافته با استناد تولید کند.
معماری چنین سیستمی به این صورت خواهد بود: درخواست کاربر $ \rightarrow $ بازیابی مبتنی بر مجوز $ \rightarrow $ شواهد جاری + متادیتای منبع $ \rightarrow $ مدل تنظیمشده $ \rightarrow $ خروجی ساختاریافته $ \rightarrow $ اعتبارسنجی + بررسی استنادات $ \rightarrow $ بازبینی انسانی.
ترکیب این دو باید تصمیمی مبتنی بر شواهد باشد، زیرا زمینههای بازیابیشده نامرتبط میتوانند نویزی ایجاد کنند که حتی عملکرد یک مدل با موفقیت تنظیمشده را کاهش دهد.
چارچوب تصمیمگیری
جریان کاری توصیه شده با مدل پایه و پرامپتینگ ساده شروع میشود. اگر شکست رخ داد، توسعهدهنده باید تشخیص دهد که آیا شکست به دلیل فقدان دانش است (منجر به RAG) یا رفتار نامنظم (منجر به تنظیم دقیق).
اگر هر دو مشکل باقی ماند، رویکرد ترکیبی ارزیابی میشود. هدف همیشه حفظ سادهترین معماری است که معیارهای پذیرش را برآورده کند. چند قانون کاربردی عبارتند از:
۱. اگر مدل به اطلاعات جاری، خصوصی یا دارای منبع نیاز دارد، با RAG شروع کنید.
۲. اگر اطلاعات در دسترس است اما وظیفه به درستی انجام نمیشود، پیش از تنظیم دقیق، رفتار و پرامپتینگ را بررسی کنید.
۳. اگر هر دو در حال شکست هستند، پیش از ترکیب، مداخلات را به صورت مستقل ارزیابی کنید.
۴. اگر مدل پایه در حال حاضر معیارها را برآورده میکند، از افزودن زیرساخت اضافی خودداری کنید.
این انضباط مهندسی از تله رایج افزودن زیرساخت بدون دلیل قابل اندازهگیری جلوگیری میکند. با جداسازی لایه شکست، تیمها میتوانند هزینهها را کاهش داده و قابلیت اطمینان را بدون تعقیب کورکورانه مدلهای بزرگتر، بهبود ببخشند.
گام بعدی شما
- برای هر شکست در خروجی، ابتدا بپرسید: «آیا سند درست در ورودی مدل بود؟» تا لایه بازیابی را از لایه تولید تفکیک کنید.
- اگر از RAG استفاده میکنید، معیار Recall@5 را به صورت مستقل از صحت پاسخ اندازه بگیرید.
- پیش از شروع تنظیم دقیق، سعی کنید با استفاده از خروجیهای ساختاریافته (Structured Outputs) مشکل فرمت را حل کنید.
اما مدیریت هزینههای استنتاج در این معماریهای ترکیبی چالش بعدی است — به تحلیل ما درباره بهینهسازی GPU در مقیاس صنعتی مراجعه کنید.



گفتگو