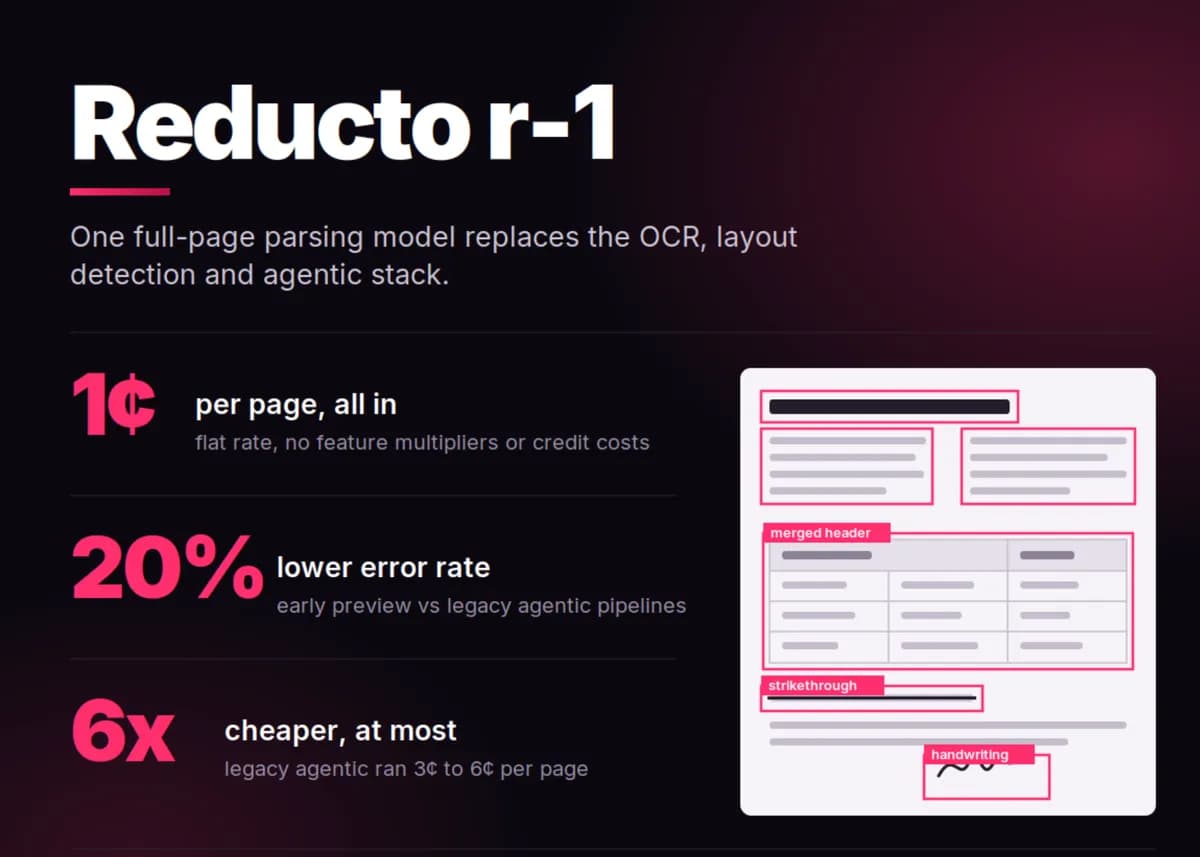
پردازش اسناد پیچیده اکنون بهطور قابلتوجهی ارزانتر و دقیقتر شده است. Reducto هفتهی گذشته مدل r-1 را منتشر کرد؛ مدلی که خط لولهی سنتی و چندمرحلهای نویسهخوانی نوری (OCR) را در یک گذر واحد از کل صفحه ادغام میکند و طبق ادعای این شرکت، نرخ خطا را در مقایسه با سیستمهای عاملمحور قدیمی خود ۲۰٪ کاهش داده است.
برای سالها، پردازش اسناد سازمانی بر یک زنجیرهی تکهتکه متکی بود: ابتدا OCR، سپس تشخیص چیدمان و در نهایت پسپردازش. هر مرحله باعث افزایش تأخیر و ایجاد نقاط شکست جدید میشد. همانطور که در تحلیلهای پیشین ما دربارهی امنیت و استخراج داده از مدلهای زبانی اشاره کردیم، هر لایهی اضافی در پردازش داده، احتمال بروز توهم (Hallucination) را افزایش میدهد. مدل r-1 دقیقاً همین هزینههای هماهنگی و خطاهای زنجیرهای را هدف قرار داده است.
این مدل جدید، معماری عاملمحور (Agentic) چندمرحلهای شرکت را با یک ساختار بازنویسیشده جایگزین میکند. در حالی که سیستمهای قدیمی، مراحل OCR و تشخیص چیدمان را بهصورت مجزا اجرا میکردند، r-1 تمام این فرآیندها را در یک گذر (Pass) انجام میدهد و تأخیر ناشی از فراخوانیهای مکرر مدل را حذف میکند.
به نقل از گزارش Marktechpost، مدل r-1 متن، جداول، اشکال و ترتیب خواندن را در یک عملیات واحد ادغام میکند. این یکپارچگی به مدل اجازه میدهد تا عناصر پیچیده را بهصورت بومی مدیریت کند، از جمله:
- ساختارهای جدولی: خواندن سلولهای ادغامشده و سرتیترهای تودرتو با استفاده از زمینه (Context) صفحه.
- فرمتبندی: حفظ معنای متون برجسته (Bold)، زیرخطدار و خطخورده.
- مبنیسازی (Grounding): ارائه جعبههای محصورکننده (Bounding Boxes) برای هر بلوک محتوا جهت اتصال آن به موقعیت دقیق در صفحه.
- ورودیهای متنوع: پشتیبانی بومی از متن دیجیتال، اسکنها و دستخط.
- تفکیک چیدمان: مدیریت همزمان ستونها، سربرگها، پانویسها و نوارهای کناری.
- تشخیص اشکال: شناسایی تصاویر و ارائه یک شرح کوتاه تولیدشده برای آنها.
شرکت Reducto بهطور خاص بر توانایی این مدل در مدیریت موارد «دمدراز» (Long Tail) تأکید دارد؛ مواردی مانند جداول متراکم، چیدمانهای غیرمعمول، اسکنهای با کیفیت پایین و اسنادی که از هیچ الگوی پیشبینیپذیری پیروی نمیکنند.
تغییر اقتصادی این مدل به اندازه تغییرات فنی آن چشمگیر است. در حالی که مدلهای عاملمحور قدیمی بسته به حجم کاری بین ۳ تا ۶ سنت برای هر صفحه هزینه داشتند، r-1 با قیمت ثابت ۱ سنت در هر صفحه عرضه میشود. Reducto این اقدام را گامی به سوی نرخهای قیمتگذاری تخت (Flat Rate) میداند.
بر اساس ادعای این شرکت، r-1 در ارزیابیهای داخلی بر مدلهای پایه شرکتهای بزرگ مانند Amazon Textract و Azure Document Intelligence و همچنین مدلهای زبانی بزرگ (LLM) در پردازش اسناد پیچیده پیروز شده است. با این حال، باید اشاره کرد که کاهش ۲۰ درصدی خطا در مقایسه با خط لولهی قبلی خودِ Reducto اندازهگیری شده است، نه بر اساس یک محک (Benchmark) شخص ثالث. همچنین، نتایج پیروزی در برابر رقبای ابری توسط خودِ فروشنده اجرا شده و هیچ مجموعه داده یا ابزار ارزیابی عمومی برای جامعهی توسعهدهندگان منتشر نشده است.
از منظر فنی، این حرکت نشاندهندهی چرخش از «OCR عاملمحور» — که در آن چندین فراخوانی LLM برای اصلاح خطاها لایهبندی میشد — به سمت معماریهای تخصصی تکمرحلهای است. Reducto با ادغام چیدمان و مبنیسازی در گذر اول، روی این فرضیه شرط بسته است که کارایی معماری بر اصلاحات تکراری برتری دارد.
مدل r-1 در حال حاضر از طریق API میزبان Parse در نسخه V3 در دسترس است. این مدل وزنهای باز (Open Weights) ندارد و امکان میزبانی شخصی (Self-hosting) برای آن فراهم نیست. با این حال، پلتفرم کلی از استقرار در ابر چندمستاجری، VPC مشتری، درونسازمانی (On-premises) و محیطهای ایزوله (Air-gapped) پشتیبانی میکند. سطوح بالاتر دسترسی شامل گواهینامه SOC 2 Type II و پردازش مطابق با HIPAA است.
برای توسعهدهندگان، این موضوع محاسبات استقرار را در خط لولههای حجیم و تحت نظارت تغییر میدهد. در فناوریهای بیمه یا حقوقی، یک خطخوردهی نادیده گرفته شده میتواند معنای یک بند قرارداد را کاملاً تغییر دهد. r-1 با کاهش خطاهای دمدراز، ریسک توهمات عاملمحور ناشی از ورود دادههای غلط را کاهش میدهد.
مهاجرت به این مدل از طریق API نسخه V3 انجام میشود. درخواستهایی که تنظیمات مدل را ذکر نمیکنند، برای جلوگیری از شکستهای ناگهانی همچنان روی زیرساخت قدیمی اجرا میشوند، اما خط لولههای جدید Studio بهطور پیشفرض از r-1 استفاده میکنند. کاربران میتوانند مدل را با کد زیر فعال کنند:
result = client.parse.run( input=upload.file_id, settings={"model": "r-1"} )
البته Reducto پردازش عاملمحور را بهطور کامل کنار نگذاشته است. گردشکارهای نیازمند پرامپتهای سفارشی یا استخراج پیشرفتهی نمودارها همچنان از خط لولهی عاملمحور عبور میکنند که اکنون نتایج r-1 را تقویت میکند، هرچند این کار تأخیر را افزایش میدهد. تیمهایی که پیکربندیهای موجود خود را منتقل میکنند باید صفحه سازگاری r-1 را بررسی کنند، زیرا برخی تنظیمات قدیمی نادیده گرفته میشوند.
این شرکت از پیش مرحله بعدی نقشه راه خود را اعلام کرده است: مدل r-1 mini برای حجمهای کاری حساس به هزینه و یک سیستم مسیریابی خودکار بهازای هر صفحه که بهینه ترین مدل را بر اساس پیچیدگی صفحه انتخاب میکند.
سازمانهایی که قصد جایگزینی پارسرهای خود را دارند، در حال حاضر میتوانند تا ۵,۰۰۰ دلار اعتبار برای مقایسههای موازی درخواست کنند تا صحت ادعاهای مربوط به دقت را تأیید کنند.
گام بعدی شما
- اگر از خط لولههای OCR چندمرحلهای استفاده میکنید، هزینه استنتاج خود را با نرخ ۱ سنتی r-1 مقایسه کنید.
- در صورت استفاده از API نسخه V3، تنظیمات مدل را به r-1 تغییر دهید تا کاهش ۲۰ درصدی خطا را در اسناد پیچیده آزمایش کنید.
- برای اسنادی با چیدمانهای غیرمتعارف، قابلیت مبنیسازی (Grounding) مدل را برای اعتبارسنجی خروجیها به کار بگیرید.
اما داستان سختافزاری این تحول حتی شگفتانگیزتر است — به تحلیل ما دربارهی تراشههای Blackwell مراجعه کنید.



گفتگو