اگر در حال استقرار عاملهای صوتی برای مشتریان جهانی هستید، بزرگترین نقطه شکست شما نه نبود پشتیبانی زبانی، بلکه لحظهای است که کاربر در میانهی جمله زبان را تغییر میدهد. طبق تحلیل فنی منتشر شده در ۹ ژوئن ۲۰۲۶ در وبسایت huggingface.co، مدلهای ElevenLabs Scribe V2، Gemini 3 Flash و AssemblyAI Universal 3-Pro به عنوان برترین مدلها برای مدیریت این چالش شناخته شدهاند.
برای بیش از نیمی از جمعیت جهان، «تغییر کد» (Code-switching) — یعنی جابهجایی سریع و بدون وقفه بین دو زبان، حتی در میانهی یک جمله — بخشی طبیعی از ارتباطات روزمره است. در محیطهای سازمانی مانند مراکز تماس، میزهای پشتیبانی IT یا پورتالهای منابع انسانی، یک کاربر ممکن است درخواست خود را به زبان اسپانیایی شروع کند و برای بیان اصطلاحات فنی به انگلیسی تغییر جهت دهد. گویندگان در این لحظات بهطور سیال با هر زبانی که در آن لحظه طبیعیتر به نظر برسد، سازگار میشوند.
اگر سیستم تشخیص خودکار گفتار (ASR) در لحظهی این تغییر زبان شکست بخورد، خطا به کل زنجیرهی پردازش (Pipeline) منتقل میشود. در محیطهای حرفهای، جایی که یک تیکت اشتباه هدایت شده یا یک پرسش اشتباه در مورد سیاستهای سازمانی میتواند پیامدهای عملیاتی واقعی داشته باشد، درست نوشتن متن (Transcript) حیاتیترین گام است. با وجود شیوع گسترده گویندگان دوزبانه در سطح جهان، پیش از این پژوهش، کارهای اندکی بر روی نحوهی برخورد عاملهای صوتی با گفتارهای تغییر-کد شده، بهویژه در محیطهای سازمانی، انجام شده بود.
پژوهشگران برای کمیسازی این مسئله، بنچمارکی تخصصی و مجموعهدادهای را با استفاده از چارچوب ارزیابی AU-Harness طراحی کردند. آنها بر چهار جفت زبانی کلیدی که بیشترین ارتباط را با پایگاه مشتریان آنها داشت تمرکز کردند: اسپانیایی-انگلیسی، فرانسوی-انگلیسی، فرانسوی کانادایی-انگلیسی و آلمانی-انگلیسی. در این بنچمارک، زبان غیرانگلیسی به عنوان چارچوب اصلی (Matrix Framing) قرار گرفته و زبان انگلیسی با طولهای متغیر در آن جایگذاری شده است. این مجموعهداده سناریوهای حساس منابع انسانی (HR) و مدیریت خدمات IT (ITSM) را هدف قرار داده است؛ از جمله پرسوجوهای کارکنان درباره حقوق و مزایا، و درخواستهای پشتیبانی مانند دسترسی به VPN، بازنشانی رمز عبور یا عیبیابی دستگاهها.
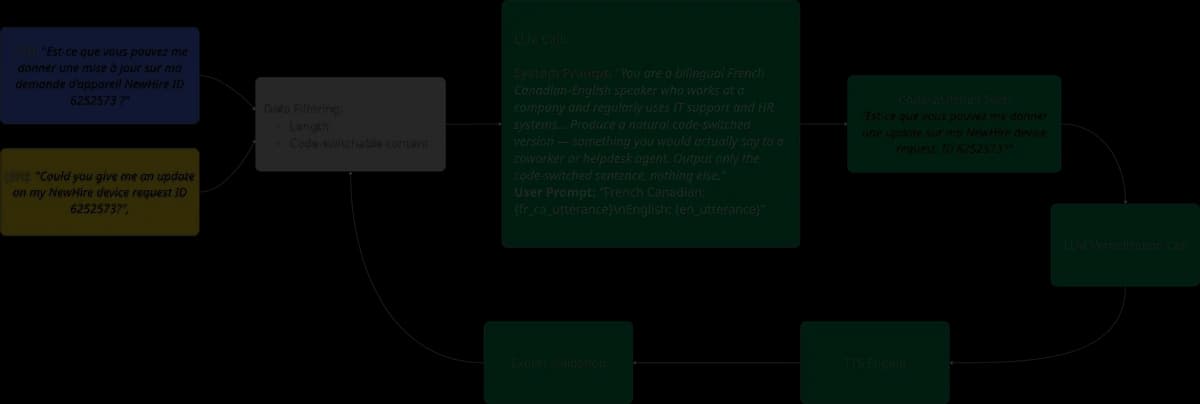
خط لوله دادههای بنچمارک
برای اطمینان از واقعگرایانه بودن دادهها، تیم تحقیق یک خط لوله (Pipeline) سختگیرانه را توسعه داد که با یک کورپوس داخلی از تعاملات IT و HR شروع میشد. برای ایجاد هر عبارت تغییر-کد شده، آنها ابتدا با جملات موازی کاربر به زبان انگلیسی و یکی از چهار زبان غیرانگلیسی شروع کردند و سپس کاندیداهای باکیفیت برای تغییر کد را فیلتر نمودند.
فرآیند فنی ایجاد عبارات تغییر-کد شده طبق مراحل زیر بود:
- فیلتر کردن کاندیداها: تیم تحقیق جملاتی را نگه داشت که بین ۱۲ تا ۴۰ کلمه بودند. این بازه تضمین میکند که جملات برای نوبتهای گفتاری طبیعی به اندازه کافی کوتاه، و برای ایجاد فرصتهای واقعی تغییر زبان به اندازه کافی بلند باشند.
- حذف موجودیتها (Entities): جملاتی که عمدتاً شامل ایمیلها، شماره تلفنها، شناسهها (ID) یا URLها بودند حذف شدند. این عناصر باعث میشوند متن به دلیل ضرورت فنی «نیمه انگلیسی» باشد، نه به دلیل انتخاب دوزبانه گوینده.
- الزامات محتوایی: هر عبارت باید حداقل سه کلمه محتوایی قابل تغییر داشت — بهویژه اسمها، فعلها یا صفتهایی که موجودیت یا نام محصول نباشند. این امر به مدل تولیدکننده اجازه داد تا نسخهای معنادار از تغییر کد ایجاد کند.
- تولید: یک پرامپت سادهی شخصیتمحور (Persona Prompt) به یک مدل زبانی بزرگ (OpenAI/GPT-5) ارسال شد تا متن تغییر-کد شده را تولید کند. پس از آن، یک مرحله «کلامیسازی» (Verbalization) توسط LLM انجام شد تا متن به فرم گفتاری تبدیل شود.
- سنتز و بازبینی: صوتها با استفاده از ElevenLabs Multilingual V2 تولید شدند. سپس هر عبارت توسط یک زبانشناس AI/NLP که گوینده بومی زبان اصلی (Matrix Language) بود، بازبینی شد. عباراتی که علامتگذاری شده بودند، یا حذف شدند و یا مجدداً تولید و بازبینی شدند.
مجموعهداده نهایی شامل رکوردهای زیر بود:
- اسپانیایی-انگلیسی: ۲۵۹ رکورد
- فرانسوی-انگلیسی: ۲۹۸ رکورد
- فرانسوی کانادایی-انگلیسی: ۱۸۸ رکورد
- آلمانی-انگلیسی: ۱۷۳ رکورد
چارچوب ارزیابی
این مطالعه فراتر از نرخ خطای کلمات (WER) ساده رفت تا درک کند خطاهای تبدیل صوت به متن چگونه بر کاربرد واقعی اثر میگذارند. آنها سه معیار متمایز را برای سنجش دقت دقیق transcription و حفظ معنا برای وظایف پاییندستی پیادهسازی کردند:
- نرخ خطای کلمات (WER): معیار استاندارد فاصله بین حقیقت (Ground Truth) و خروجی مدل. پژوهشگران WER کلی برای هر جفت زبانی و همچنین WER را به تفکیک هر زبان گزارش کردند.
- نرخ خطای معنایی (SWER): این امتیاز نشاندهنده نرخ خطاهایی است که از نظر معنایی مؤثر تشخیص داده شدهاند. این پیادهسازی بر اساس بنچمارک STT شرکت Pipecat است و از مدل Gemma-4-31B به عنوان داور استفاده میکند.
- نرخ خطای پاسخ (AER): یک تست عملکردی بر اساس متدولوژی Bhushan et al. (IISc/ARTPARK, arXiv 2507.16456). برای هر عبارت، سیستم سه سوال درک مطلب پاییندستی ایجاد میکند. سپس یک LLM متن استخراج شده توسط ASR را میخواند تا ببیند آیا میتواند به آنها درست پاسخ دهد یا خیر؛ این معیار میسنجد که آیا جزئیات حیاتی — مانند شماره پرونده، نامها، تاریخها یا دلیل درخواست — حفظ شدهاند یا خیر.

رتبهبندی عملکرد
پژوهشگران هفت مدل را ارزیابی کردند: AssemblyAI Universal 3-Pro، Deepgram Nova 3 Multilang، ElevenLabs Scribe V2، Google Gemini 3 Flash، Mistral AI Voxtral Small 24B-2507، Nvidia Parakeet TDT 0.6b V3 و OpenAI Whisper Large V3 Turbo.
در تمامی موارد، ElevenLabs Scribe V2 و AssemblyAI Universal 3-Pro در دقت خام transcription (WER) مشترکاً در صدر قرار گرفتند. آنها در جفت اسپانیایی-انگلیسی برابر بودند و در سایر جفتهای زبانی تنها ۰.۰۲ تا ۰.۱۳ درصد تفاوت داشتند، به طوری که Scribe برتری بسیار اندکی در هر مورد داشت.
Google Gemini 3 Flash در رتبههای بعدی قرار گرفت، هرچند در جفت فرانسوی کانادایی-انگلیسی بیشترین فاصله را داشت و ۰.۱۴ امتیاز پایینتر از Scribe و ۰.۱۲ امتیاز پایینتر از AssemblyAI بود. مدلهای Deepgram Nova-3، Mistral Voxtral و Nvidia Parakeet رتبههای میانی را اشغال کردند. Parakeet در مجموع ضعیفترینِ این سه بود اما در جفت آلمانی-انگلیسی فاصله را کم کرد و از هر دو مدل Nova-3 و Voxtral بهتر عمل کرد.
با این حال، معیارهای معنایی تغییری در نتایج ایجاد کردند. Gemini 3 Flash بهطور مداوم در AER و SWER از AssemblyAI پیشی گرفت و AssemblyAI را به رتبه سوم راند (اگرچه AssemblyAI همچنان در اسپانیایی-انگلیسی بهتر از Gemini بود). از آنجایی که Gemini یک مدل زبانی صوتی بزرگ (LALM) است که برای استدلال و درک زبان بهینه شده، معنای عبارات را بهطور مؤثرتری حفظ کرد، حتی زمانی که transcription خام آن کمی کمتر دقیق بود.
در مقابل، OpenAI Whisper Large V3 Turbo در جایگاه آخر قرار گرفت و WER آن بین ۰.۱۶ تا ۰.۶۱ متغیر بود. پژوهشگران یک حالت شکست خاص را ذکر کردند: وقتی Whisper بدون پارامتر صریح زبان فراخوانی شود، اغلب بهجای تبدیل متن دوزبانه، سعی میکند صوت را به انگلیسی ترجمه کند و در نتیجه در حفظ زبانی که در صوت گفته شده شکست میخورد.

یک مورد عجیب در نتایج معنایی، مدل Deepgram Nova-3 بود. در حالی که این مدل در SWER در سطح متوسط بود، در AER در تمامی جفتهای زبانی در رده آخر یا یکی مانده به آخر قرار گرفت. این شکاف در جفت اسپانیایی-انگلیسی بسیار شدیدتر بود، جایی که نرخ کلی خطاهای معنایی Nova-3 کمتر از نرخ خطای آن در جزئیات خاصی بود که برای وظایف پاییندستی اهمیت داشتند.
هزینه تغییر زبان
برای جداسازی «جریمه تغییر زبان» (Switching Penalty)، تیم تحقیق صوتهای تغییر-کد شده را با دو خط مبنای تکزبانه مقایسه کرد: یک صوت تکزبانه به زبان اصلی (Matrix) با همان محتوا و یک صوت تکزبانه انگلیسی. آنها تفاوت (Delta) در WER بین شرایط تغییر-کد شده و تکزبانه را اندازهگیری کرده و این دلتاها را در کل بنچمارک تجمیع کردند.

یافتهها نشان داد مدلهای تراز اولی مانند Scribe V2، Gemini 3 Flash و AssemblyAI جریمههای بسیار کمی میپردازند. Scribe V2 بهطور قابل توجهی از خط مبنای L2 خود بهتر عمل کرد که نشاندهنده استحکام واقعی در برابر ورودیهای دوزبانه است. بهطور کلی، سیستمهای برتر جریمه کمی دارند، در حالی که مدلهای پایینتر بهشدت دچار افت کیفیت میشوند؛ این امر نشان میدهد که تغییر کد، تفاوتها در استحکام مدلها را آشکار میکند، نه اینکه دشواری را بهطور یکسان برای همه افزایش دهد.
یک الگوی ساختاری ثابت ظاهر شد: هزینه نسبت به انگلیسی (میلههای سبز) تقریباً همیشه بیشتر از هزینه نسبت به زبان اصلی L2 (میلههای قرمز) بود. این مورد قابل انتظار است، زیرا خط مبنای L2 معمولاً برای مدلها سختتر از انگلیسی است، بنابراین جریمه خالص تغییر زبان در مقایسه با آن کوچکتر است.
Whisper بیشترین تخریب را نشان داد و در جفت آلمانی-انگلیسی به افزایش ۰.۸۵ واحدی در WER نسبت به انگلیسی رسید. جالب این است که Whisper تنها مدلی بود که روی گفتار تغییر-کد شده بهتر از صوت تکزبانه L2 عمل کرد، صرفاً به این دلیل که پیشفرض ترجمه آن، زبان اصلی را بهطور کلی دور میزند.
مدل شکست ASR
پژوهشگران از یک مدل دو بخشی برای شناسایی محرکهای خطا استفاده کردند. ابتدا، یک رگرسیون لجستیک تعیین کرد که چه متغیرهایی با «وقوع» خطا مرتبط هستند. دوم، یک رگرسیون حداقل مربعات معمولی (OLS) بررسی کرد که چه چیزی بر «میزان» خطا پس از وقوع اثر میگذارد. آنها از سه پیشبینیکننده استفاده کردند:
- تعداد دفعات تغییر زبان در عبارت.
- طول عبارت (به عنوان کنترل).
- شاخص ترکیب کد (CMI) — نسبت کلمات زبان دوم به زبان اصلی، طبق متدولوژی Gambäck و Das.
آنها دریافتند که «تعداد تغییرات زبان» در یک عبارت، قویترین پیشبینیکننده برای وقوع خطا است. هر تغییر زبان، فرصت جدیدی برای شکست فرآیند transcription ایجاد میکند. این موضوع بهویژه در جفت فرانسوی-انگلیسی معنادار بود، جایی که شش مدل از هفت مدل این رابطه را نشان دادند.

پس از وقوع خطا، «شاخص ترکیب کد (CMI)» میزان خطا را تعیین میکند. این امر در جفتهای آلمانی-انگلیسی مشهودتر بود، جایی که چهار مدل از هفت مدل رابطه مثبت معنیداری بین CMI و WER نشان دادند. این نشان میدهد که شدت شکست توسط تراکم ترکیب شکل میگیرد: هرچه زبانها در هم تنیدهتر باشند، خطاهای transcription حاصله بزرگتر خواهند بود.
پارادوکس انگلیسی
یکی از ضدشهودیترین یافتهها، محل وقوع واقعی خطاها بود. تیم تحقیق با استفاده از GPT-5 برای برچسبگذاری زبان کلمات، هر خطای transcription را به زبانی که کلمه در آن بود نسبت داد تا WER هر زبان را محاسبه کند.

آنها کشف کردند که خطاها در بخشهای انگلیسی عبارت متمرکز شدهاند، نه در بخشهای زبان اصلی غیرانگلیسی. این یافته غافلگیرکننده است زیرا مدلها معمولاً انگلیسی تکزبانه را بهتر از هر چیزی پردازش میکنند. محققان دو دلیل برای این موضوع فرضیهسازی کردند:
- ویژگیهای واژگانی: بخشهای انگلیسی در گفتارهای تغییر-کد شده ممکن است بهطور نامتناسبی حاوی واژگان فنی یا موجودیتهای نامگذاری شدهای باشند که تبدیل آنها سختتر است.
- تطبیق بافتاری: بخشهای زبان جاسازی شده، صرفنظر از نوع زبان، بافتی چالشبرانگیز ایجاد میکنند. وقتی مدل به بخشی از گفتار غیر-اصلی وارد میشود، باید در میانهی عبارت با یک رژیم واژگانی و فونولوژیکی متفاوت سازگار شود و این دقیقاً احتمال خطا را در آن بازه افزایش میدهد.
این نشان میدهد که دشواری transcription تنها در نقاط تغییر زبان متمرکز نیست، بلکه در کل بازهی زبان جاسازی شده گسترش مییابد. تفکیک اینکه آیا این موضوع بازتابدهنده ویژگیهای واژگانی است، نقشهای ساختاری یا تطبیق محدود مدل، مسیر اصلی کارهای آینده است.

محدودیتهای سنتتیک
این مطالعه چندین محدودیت را میپذیرد:
- صوت سنتتیک: بنچمارک سنتتیک است. تمام صوتها از طریق تبدیل متن به گفتار (TTS) با استفاده از ElevenLabs Multilingual V2 تولید شدهاند و نه توسط گویندگان دوزبانه واقعی. در نتیجه، ممکن است ویژگیهای عروضی (Prosodic) و فونولوژیکی دنیای واقعی را بهطور کامل منعکس نکند.
- تشخیص خودکار: تمام مدلها تنها با استفاده از «تشخیص خودکار زبان» تست شدند. در حالی که برخی سیستمها توکنهای اجباری زبان یا راهنماییهای چندزبانه ارائه میدهند، تشخیص خودکار برای شبیهسازی محیطهای تولید انتخاب شد، جایی که سیستم از پیش نمیداند کاربر از کدام جفت زبانی استفاده خواهد کرد.
- WER به تفکیک زبان: محاسبات هر زبان، «درجها» (Insertions) را حذف میکنند. چون درجها را نمیتوان بدون یک فراخوانی اضافی مدل برای شناسایی زبان کلمه درج شده به زبانی نسبت داد، آنها از دستههای تفکیکی حذف شدند، اگرچه در WER کلی باقی ماندند.
برای معماران فنی، این تحلیل این فرض را که «یک مدل انگلیسی خوب برای کاربران دوزبانه کافی است» تغییر میدهد. دادهها نشان میدهند که استحکام در برابر تغییر کد یک قابلیت مجزا است. در حالی که مدلهای پیشرو در حال پر کردن این شکاف هستند، واریانس بین جفتهای زبانی همچنان بالا است.
اگر در حال انتخاب ارائهدهنده ASR هستید، دیگر نمیتوانید به بنچمارکهای عمومی تکیه کنید. شما باید دقیقاً برای جفتهای زبانی که مشتریان شما استفاده میکنند تست بگیرید، زیرا بهترین مدل برای اسپانیایی-انگلیسی ممکن است برای آلمانی-انگلیسی بهترین نباشد.



گفتگو