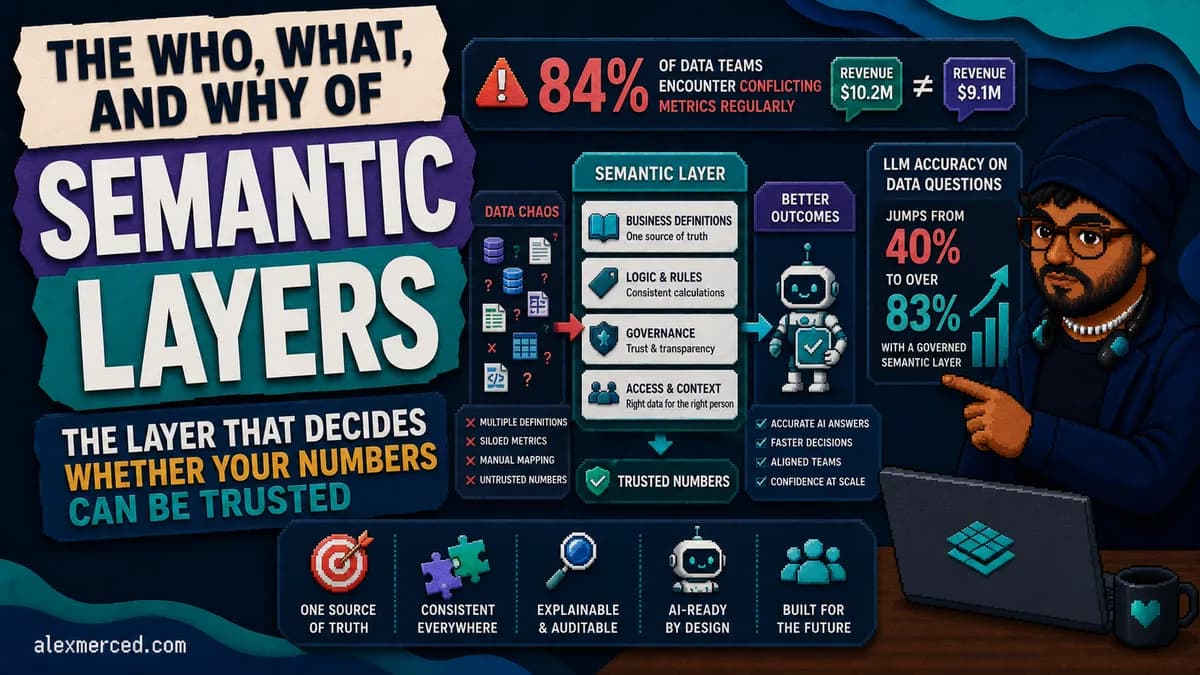
تصور کنید مدیر مالی یک شرکت، عددی برای «درآمد» ارائه میدهد که با عدد ارائهشده توسط مدیر فروش کاملاً متفاوت است. این تضاد، ریشه در بحرانی عمیق در اعتماد به دادههای سازمانها دارد که اکنون با ظهور عاملهای هوش مصنوعی به نقطه بحرانی رسیده است.
طبق گزارشهای صنعتی، ۸۴ درصد از تیمهای داده بهطور منظم با نسخههای متضاد از یک معیار واحد مواجه میشوند. این یک آمار تکاندهنده است که نشاندهنده بحرانی فراگیر در اعتماد به استکهای دادهای مدرن است. این شکست سیستماتیک باعث میشود چرخههای گزارشدهی بهجای تحلیل، صرف بحثهای بیپایان بر سر تعاریف شود؛ برای مثال، اینکه آیا «درآمد» به معنای مبلغ ناخالص (Gross) است یا خالص (Net)، و یا اینکه «نرخ ریزش مشتری» (Churn) بر اساس تعداد صندلیهای فعال (Seats) محاسبه شده یا بر اساس تعداد کل حسابها (Accounts).
برای سه دهه، پاسخ صنعت به این پراکندگی، لایه معنایی (Semantic Layer) بوده است. برای بخش زیادی از این مدت، لایه معنایی به عنوان یک مؤلفه خفته در استک هوش تجاری (BI) باقی مانده بود؛ مجموعهای از تعاریف که در داخل یک ابزار خاص پنهان شده بودند، توسط تعداد کمی از متخصصان نگهداری میشدند و تا حد زیادی توسط کل سازمان نادیده گرفته میشدند. با این حال، آن دوران گمنامی بهطور ناگهانی و با ظهور عاملهای هوش مصنوعی به پایان رسیده است.
وقتی یک مدل زبانی بزرگ (LLM) — شبیه کتابخانهداری که میلیاردها صفحه را خوانده و حالا با همان لحن کتابها جواب میدهد — وظیفه استخراج داده را بر عهده میگیرد، لایه معنایی از یک «امکان رفاهی» به یک «زیرساخت حیاتی» تبدیل میشود. بدون این لایه، عاملهای هوش مصنوعی اساساً بر اساس نام جداول خام و سرستونها (Column Headers) حدس میزنند؛ اما با وجود آن، این عاملها بر اساس منطق تجاری حاکم (Governed Business Logic) مستقر میشوند.
تاثیر این تغییر بهطور قابلسنجی مشخص است: صحت پاسخهای LLM در مواجهه با پرسشهای دادهمحور، زمانی که بهجای جداول خام بر یک لایه معنایی حاکم متکی هستند، از حدود ۴۰ درصد به بیش از ۸۳ درصد جهش میکند. این جهش خیرهکننده در عملکرد توضیح میدهد که چرا لایه معنایی اکنون عامل تعیینکننده در این است که آیا یک پیادهسازی هوش مصنوعی، بینشهای قابل اعتماد تولید میکند یا توهماتی با اعتمادبهنفس کامل (Confident Hallucinations). در همین راستا، برای مقابله با خطاهای پنهان در کوئریها، ابزارهایی مانند sqlsure برای شناسایی دقیق خطاهای معنایی در SQL توسعه یافتهاند تا ریسک توهمات دادهای را به حداقل برسانند.

برای درک دقیقتر، لایه معنایی را به عنوان یک لایه ترجمه ببینید. در یک سو، دادههای فیزیکی و اغلب نامنظم در انبار دادههای ابری مانند Snowflake، Databricks یا BigQuery قرار دارند. در سوی دیگر، کاربر تجاری، مدیر اجرایی یا یک عامل هوش مصنوعی است که میپرسد: «رشد ما در منطقه EMEA در فصل گذشته چقدر بود؟»
لایه معنایی موتور ترجمه است که این پرسش تجاری را به یک کوئری دقیق SQL تبدیل میکند. این لایه واژه «رشد» را به یک فرمول محاسباتی خاص، «منطقه EMEA» را به مجموعهای از کدهای کشور و «فصل گذشته» را به یک بازه زمانی (Date Range) مشخص نگاشت میکند. با جدا کردن (Decoupling) منطق تجاری از ذخیرهسازی فیزیکی، لایه معنایی تضمین میکند که فارغ از ابزار مورد استفاده برای دسترسی به دادهها — خواه یک داشبورد Tableau باشد، خواه یک دفترچه Python یا یک رابط چت هوش مصنوعی مولد — پاسخ همواره یکسان بماند. این «منبع واحد حقیقت» (Single Source of Truth) از سناریوی ترسناکی جلوگیری میکند که در آن اسلایدهای مدیر مالی یک عدد را نشان دهند و داشبورد معاون فروش، عددی دیگر را.
با نزدیک شدن به سال ۲۰۲۶، معماری این لایه در حال تکامل است. در گذشته، منطق در داخل خود ابزار BI تعبیه شده بود (رویکرد BI-centric). اگر از Looker استفاده میکردید، منطق شما در LookML زندگی میکرد. اگر از Tableau استفاده میکردید، منطق در منبع دادهها (Data Source) قرار داشت. مشکل این بود که این منطق «محبوس» بود. اگر یک دانشمند داده میخواست از همان معیار در یک دفترچه Jupyter استفاده کند، مجبور بود منطق SQL را بهصورت دستی بازسازی کند که این امر ریسک واگرایی (Divergence) و بروز خطا را بهشدت افزایش میداد.
اکنون صنعت به سمت لایه معنایی «بدون سر» (Headless) یا «جهانی» حرکت میکند. این رویکرد، منطق را از ابزار بصری خارج کرده و به یک لایه مستقل منتقل میکند که بین انبار داده و تمام نقاط مصرف قرار میگیرد. این ساختار به شرکت اجازه میدهد یک معیار را تنها «یکبار» تعریف کند و در «همهجا» مصرف نماید. چه درخواست از طریق یک ابزار BI ارسال شود، چه از طریق یک API یا یک LLM، لایه معنایی تعریف را کنترل میکند و ثبات را در کل سازمان تضمین مینماید. این تکامل در معماری مشابه رویکرد Sonn در جایگزینی بازیابی غیرفعال با لایههای استدلالی است که دقت در پردازش اطلاعات را افزایش میدهد.
بررسی بازار فعلی، فلسفههای متفاوتی را نشان میدهد:
- dbt: با معرفی dbt Semantic Layer بهشدت و تهاجمی وارد این میدان شده است و از جایگاه خود به عنوان ابزار اصلی تبدیل دادهها (Transformation) برای بسیاری از تیمها بهره میبرد.
- Cube: رویکردی منعطف و API-first دارد که بهخوبی پاسخگوی نیاز توسعهدهندگانی است که در حال ساخت اپلیکیشنهای دادهای سفارشی هستند.
- AtScale: بر مجازیسازی با عملکرد بالا (High-performance Virtualization) برای مجموعهدادههای عظیم تمرکز دارد.
- Looker: در حالی که پیشگام این حوزه است، اما همچنان بهطور تنگاتنگی با پلتفرم بصری خود ادغام شده است، هرچند گامهای بلندی در جهت باز کردن APIهای خود برداشته است.
- Snowflake و Databricks: با ارائه لایههای بومی در انبار داده (Warehouse-native)، تلاش میکنند استک را با ادغام قابلیتهای معنایی مستقیماً در موتور ذخیرهسازی، متراکم و ساده کنند.
- Dremio: رویکرد متفاوتی دارد و بر توانایی کوئری گرفتن از منابع متنوع بدون نیاز به جابهجایی حجیم دادهها تأکید میکند و لایه معنایی را در یک معماری Lakehouse با عملکرد بالا ادغام نموده است.
هر یک از این ابزارها مشکل بنیادی یکسانی را حل میکنند، اما در مورد اینکه «مرکز ثقل» (Gravity) منطق کجا باشد متفاوتاند؛ برخی آن را نزدیک به تبدیل دادهها، برخی نزدیک به انبار داده و برخی دیگر به عنوان یک سرویس مستقل ترجیح میدهند.
این موضوع که چه کسی مالک لایه معنایی است، نقطه بحثهای سازمانی بزرگی است. در گذشته، این حوزه اغلب در اختیار مدیر سیستمهای BI بود. در عصر مدرن، مالکیت به سمت «مهندسان تحلیل» (Analytics Engineers) میرود؛ نقشی که دقت مهندسی نرمافزار (مشابه رویکرد dbt) را با بستر تجاری یک تحلیلگر داده ترکیب میکند. مهندس تحلیل مسئول تعریف معیارها، اطمینان از عملکرد بهینه Joinها و مستندسازی منطق است تا کاربران تجاری دقیقاً بدانند به چه چیزی نگاه میکنند.
با تبدیل شدن عاملهای هوش مصنوعی به مصرفکنندگان اصلی، نیازهای لایه معنایی تغییر کرده است. مصرفکننده دیگر تنها انسانی نیست که به یک نمودار نگاه میکند؛ مصرفکننده بهطور فزایندهای یک عامل AI است. این تغییر، الزامات لایه را دگرگون میکند. دیگر صرفاً دقت کافی نیست؛ لایه باید «قابل کشف» (Discoverable) باشد. عاملهای هوش مصنوعی به متادیتا (Metadata) — شامل توصیفات، مترادفها و روابط — نیاز دارند تا بفهمند کدام معیار را برای هر پرامپت (Prompt) خاص به کار گیرند. لایه معنایی بدون متادیتای غنی، شبیه کتابخانهای بدون فهرست است؛ اطلاعات وجود دارد اما هوش مصنوعی نمیتواند آن را بیابد.
در نهایت، لایه معنایی جایی است که دوران هوش مصنوعی در دادهها، پیروز یا شکستخورده میشود. وعده «گفتگو با دادهها» یک سراب است اگر هوش مصنوعی مستقیماً با جداول خام درگیر شود. جداول خام برای بهرهوری در ذخیرهسازی طراحی شدهاند، نه برای فهم انسان یا AI. آنها حاوی نامهای ستونی رمزگونهای مثل cust_v2_final و txn_amt_usd_adj هستند. یک LLM ممکن است حدس بزند که txn_amt_usd_adj به معنای درآمد است، اما نمیتواند با قطعیت بداند که آیا این ستون مالیاتها را حذف کرده یا هزینههای ارسال را شامل میشود یا خیر.
لایه معنایی این حفاظها (Guardrails) را ایجاد میکند و به AI میگوید: «وقتی کاربر درآمد را میخواهد، دقیقاً از این فرمول استفاده کن و حسابهای تست داخلی را فیلتر کن.» این حاکمیت (Governance)، تنها راه مقیاسپذیر کردن هوش مصنوعی در سازمانهای بزرگ است. بدون آن، ریسک اتخاذ تصمیمات استراتژیک بر اساس توهمات تولید شده توسط AI، برای هر مدیر مالی جدی، بسیار بالا و غیرقابل قبول است.
در آینده، ادغام لایههای معنایی احتمالاً نامرئی خواهد شد. ما دیگر درباره آنها بهعنوان «لایههای» جداگانه صحبت نخواهیم کرد و در عوض آنها را بهعنوان رابط بنیادین (Fundamental Interface) انبار داده خواهیم دید. هدف این است که به حالتی برسیم که فاصله بین یک پرسش تجاری و یک پاسخ قابل اعتماد صفر شود. این امر مستلزم رویکردی منضبط در تعریف معیارها و تعهدی به حاکمیت متمرکز است.
شرکتهایی که امروز روی لایه معنایی خود سرمایهگذاری میکنند، صرفاً در حال پاکسازی گزارشهای خود نیستند؛ آنها در حال ساختن «نقشه شناختی» (Cognitive Map) هستند که نیروی کار AI آنها در آینده برای پیمایش در کسبوکار از آن استفاده خواهد کرد. گذار از «دادهمحور» (Data-driven) به «هوشمصنوعیمحور» (AI-driven)، موضوع خرید یک LLM بهتر نیست، بلکه فراهم کردن یک نقشه قابل اعتماد از حقیقت برای آن LLM است. در نهایت، لایه معنایی درباره «اعتماد» است. این لایه تفاوت بین تیم دادهای است که وقت خود را صرف بحث بر سر اعداد میکند و تیم دادهای که وقت خود را صرف کشف بینشها (Insights) مینماید. سازمانها با استانداردسازی زبان تجاری خود، میتوانند در نهایت از تردید در مورد اعداد دست بردارند و بر اساس آنها اقدام کنند.
گام بعدی شما
- اگر از مدلهای زبانی برای تحلیل داده استفاده میکنید، ابتدا یک لایه متادیتا ساده برای ستونهای کلیدی خود تعریف کنید.
- ابزارهای Headless Semantic مانند Cube یا dbt را برای یکسانسازی معیارهای گزارشدهی در سازمان بررسی کنید.
- متادیتاهای هر معیار (توضیحات و مترادفها) را بهگونهای بنویسید که برای یک LLM قابل شناسایی باشد.
اما این نقشه راه دادهها تنها بخشی از ماجراست؛ تأثیر این ساختار بر کاهش هزینههای استنتاج مدلهای استدلالی را در گزارش بعدی بررسی خواهیم کرد.



گفتگو