اگر برای هر صفحهی اسناد اداری ۱۰ سنت پرداخت میکنید، باید بدانید که کف قیمتی این صنعت در حال فروپاشی است. یک API جدید بر پایه مدلهای بینایی-زبانی، هزینهی استخراج داده از هر صفحه را تا ۱۰۰ برابر کاهش داده است.
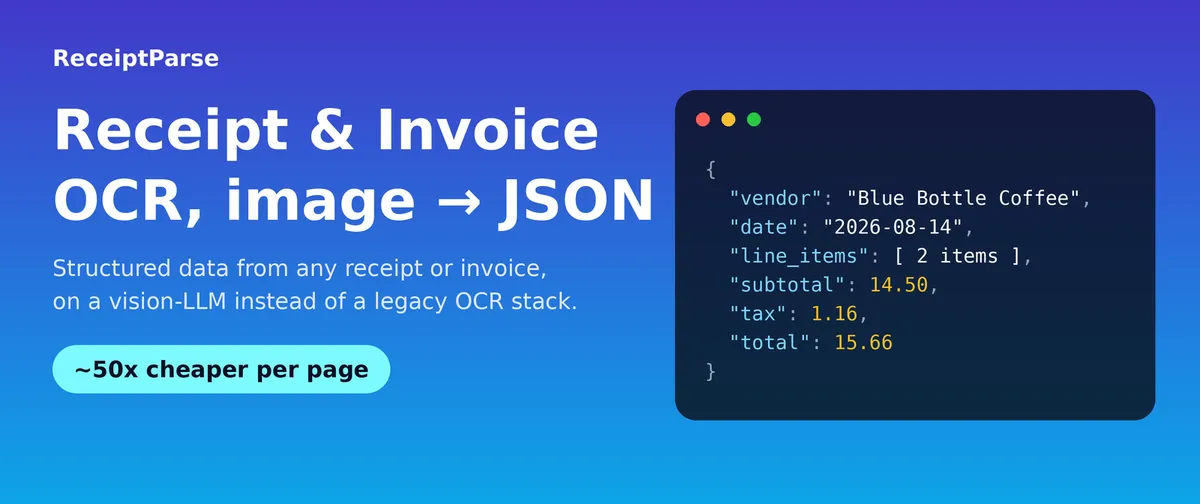
به نقل از گزارشی در dev.to که در ۸ سپتامبر ۲۰۲۶ منتشر شد، این توسعهدهنده خط لولههای سنتی نویسهخوانی نوری (OCR) — که شبیه به یک مترجم است که ابتدا تکتک حروف را میشناسد و بعد سعی میکند معنای جمله را بفهمد — را با یک مدل بینایی تک-پرامپتی جایگزین کرده است تا دادههای ساختاریافتهی JSON را از رسیدها و فاکتورها استخراج کند.
سالها بود که برنامهنویسان به ابزارهای سازمانی مانند Azure Document Intelligence و Google Document AI متکی بودند. این سرویسها معمولاً پس از اتمام طرحهای رایگان، مبلغ ۰.۱۰ تا ۰.۳۰ دلار برای هر صفحه دریافت میکنند. اگرچه این ابزارها برای پردازش میلیونها صفحه قدرتمند هستند، اما هزینههایشان برای توسعهدهندگان مستقل یا محصولات کوچک SaaS که قابلیتهای سادهای برای مدیریت هزینهها میسازند، بازدارنده است.
همانطور که در تحلیل قبلی ما دربارهی برتری دادههای تراکنشی اختصاصی نسبت به مدلهای عمومی اشاره کردیم، این پروژه ثابت میکند که برای اسناد استاندارد و ساده، مدلهای بینایی-زبانی عمومی اکنون کفایت میکنند. این رویکرد در راستای استراتژیهای بهینهسازی است که در بررسی تفاوت تجزیهکنندههای تخصصی و مدلهای چندوجهی برای کاهش هزینههای پردازش به آن پرداختیم. این چرخش، صنعت را از وابستگی به قالبهای سختگیرانهی هر فروشنده، به سمت رویکردی منعطف و مبتنی بر پرامپت میبرد.
جزئیات فنی
این سامانه از طریق یک نقطه اتصال (Endpoint) واحد به نام POST /v1/extract عمل میکند که تصاویر یا PDFها را میپذیرد. طبق مستندات این پروژه، جزئیات فنی کلیدی عبارتاند از:
- بهینگی هزینه: هزینهی خام استنتاج (Inference) — لحظهای که مدل واقعاً جواب تولید میکند، مثل خودِ آشپزی و نه دورهی آموزش آشپز — بین ۰.۰۰۱ تا ۰.۰۰۲ دلار برای هر صفحه است؛ در حالی که رقبای قدیمی بیش از ۰.۱۰ دلار میگیرند.
- خروجی ساختاریافته: مدل خروجی JSON تایپشدهای شامل نام فروشنده، تاریخ، ارز و اقلام تفصیلی (شرح، تعداد و قیمت واحد) ارائه میدهد.
- تطبیقپذیری: سامانه بدون نیاز به مجموعهی دادههای آموزشی سفارشی، عکسهای نامرتب دوربین گوشی و PDFهای چندصفحهای را مدیریت میکند.
مدل قیمتگذاری
سطوح قیمتگذاری برای کاربران مقیاسکوچک طراحی شده است:
۱. سطح ورودی: ۹ دلار در ماه برای ۱,۰۰۰ صفحه.
۲. سطح رشد: ۷۹ دلار در ماه برای ۲۰,۰۰۰ صفحه.
۳. سطح رایگان: برای تستهای اولیه در دسترس است.
این تغییر نشان میدهد که هزینهی بالای OCRهای قدیمی دیگر یک ضرورت فنی نیست، بلکه یک لنگر قیمتی است که به معماریهای قدیمی موتورهای قاعدهمند گره خورده است. برای کاربر نهایی، این یعنی استخراج دادههای باکیفیت از یک هزینه کلان بودجهای به یک قابلیت کالایی و ارزان تبدیل میشود.
برنامهنویسان اکنون در حال بررسی این موضوع هستند که آیا خروجی JSON ساده کافی است یا محیطهای عملیاتی به امتیازات اطمینان (Confidence Scores) برای هر فیلد و جعبههای محصورکننده (Bounding Boxes) برای تایید نیاز دارند. این پروژه در حال حاضر در مرحله اعتبارسنجی پیش از عرضه است تا مشخص شود آیا این ویژگیهای پیشرفته برای پذیرش در بازار ضروری هستند یا خیر.
گام بعدی شما
- اگر اپلیکیشنی دارید که با رسیدها سروکار دارد، هزینههای فعلی خود را با مدلهای VLM مقایسه کنید.
- بررسی کنید که آیا دقت مدلهای عمومی در اسناد خاص شما، جایگزین ابزارهای گرانقیمت Azure یا Google میشود یا خیر.
- برای کاهش هزینهها، استخراج داده را از یک خط لوله چندمرحلهای به یک پرامپت واحد تبدیل کنید.
اما داستان سختافزاری این تحول حتی شگفتانگیزتر است — به تحلیل ما دربارهی تراشههای Blackwell مراجعه کنید.



گفتگو