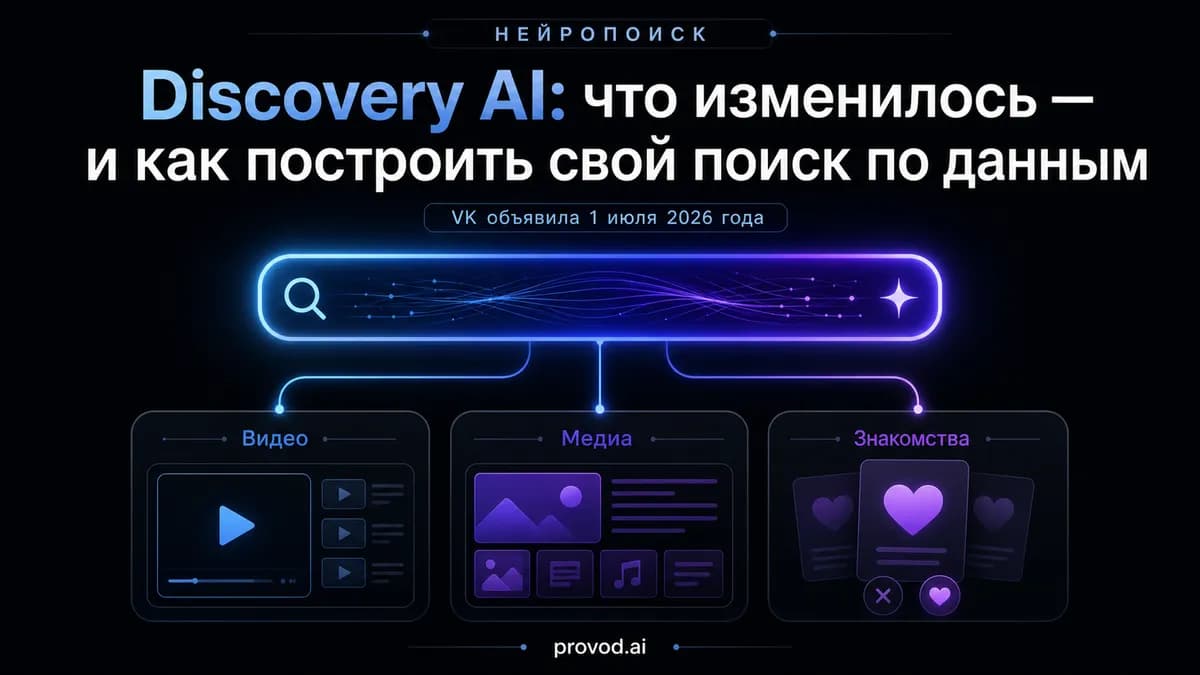
تصور کنید به جای فیلترهای خشک و محدود، به یک دستیار بگویید «کسی را برای کوه پیمایی پیدا کن» و او دقیقاً همان فرد را از میان میلیونها پروفایل بیرون بکشد. این دقیقاً همان چیزی است که VK با انتشار Discovery AI در ۱ جولای ۲۰۲۶ به دست آورده است. این سیستم یک لایه جستوجوی عصبی واحد است که در سراسر اکوسیستم محصولات این شرکت گسترده شده است. این راهکار یک اپلیکیشن مستقل یا یک API عمومی برای توسعهدهندگان خارجی نیست، بلکه یک موتور داخلی است که نحوه یافتن محتوا در انواع مختلف رسانهها را بهطور کلی تغییر میدهد.
زمانبندی این خبر بسیار حائز اهمیت است؛ چرا که همزمان با گردهمایی VK AI درباره سیستمهای توصیهگر (Recommendation Systems) در ۱ جولای برگزار شد. این همزمانی سیگنال میدهد که ما با یک بحث درباره تکنولوژی اختصاصی (Proprietary) رو به روییم، نه عرضه یک محصول بستهبندی شده با لیست قیمتهای عمومی و مستندات فنی برای استفاده همگان. در واقع، VK قصد دارد توانمندیهای داخلی خود را به نمایش بگذارد تا نشان دهد چگونه میتواند تجربه کاربری را در مقیاس کلان تغییر دهد.
همانطور که در تحلیلهای قبلی ما دربارهی شکست عاملهای هوش مصنوعی (LLM Agents) به دلیل نبود قراردادهای مشاهدهپذیر (Observable Contracts) اشاره کردیم، استقرار Discovery AI نشاندهندهی چرخش استراتژیک به سمت محیطهای بسته و غنی از داده است. این رویکرد در حالی صورت میگیرد که امنیت عاملها به شدت مورد بحث است؛ بهطور مثال در تحلیل ما پیرامون پدیده HalluSquatting دیدیم که چگونه توهمات مدلها میتوانند به درگاههای اجرای بدافزار تبدیل شوند. در حالی که باتهای عمومی با دقت و صحت پاسخها دستوپنج نرم میکنند، VK روی یک سیستم «حلقه بسته» شرطبندی کرده است؛ سیستمی که در آن مدل هوش مصنوعی دسترسی مستقیم و اختصاصی به رفتار کاربران و محتوا در چندین پلتفرم مختلف دارد و این امر ریسک توهمات مدل را کاهش میدهد.
یکپارچهسازی اکوسیستم
این سامانه جدید به عنوان یک لایه هوشمند واحد برای سه سرویس کلیدی VK Video، Mail.ru Media و Zen عمل میکند. طبق بیانیه مطبوعاتی VK و گزارش خبرگزاری CNews در ۱ جولای ۲۰۲۶، هدف نهایی این است که کشف اطلاعات مرتبط با هر کاربر (Personally Relevant Information) از طریق تحلیل دادههای متقاطع در تمام سرویسهای VK تسریع شود. Discovery AI به عنوان یک فناوری جستوجوی عصبی اختصاصی توصیف شده است که بر پایه مدل زبانی большо (LLM) خودِ شرکت VK توسعه یافته است تا بتواند به طور یکپارچه با زیرساختهای موجود ترکیب شود.

یکی از متمایزترین کاربردهای این سیستم در سرویسهای دیتینگ (دوستیابی) VK مشاهده میشود. این مدل از جستوجوی زبان طبیعی (Natural Language Discovery) پشتیبانی میکند. این یعنی کاربر به جای تکیه بر فیلترهای سخت و محدود (مانند بازه سنی یا شهر)، میتواند درخواستهایی مانند «پیدا کردن فردی برای کوه پیمایی» را وارد کند. این رویکرد، جستوجو را از یک تمرین سادهی مبتنی بر کلمات کلیدی (Keyword Exercise) به یک درک معنایی (Semantic Understanding) از قصد و نیت کاربر تبدیل میکند و باعث میشود نتایج بسیار دقیقتر و انسانیتر باشند.
عملکرد و جزئیات فنی
شرکت VK ادعا میکند که این سیستم پاسخها را در کمتر از ۰.۵ ثانیه تولید میکند که نشاندهنده بهینهسازی شدید در لایههای استنتاج است. علاوه بر این، یک حالت خاص به نام «Deep Research» یا پژوهش عمیق معرفی شده است که برای تحلیلهای جامع و تفصیلی درباره یک موضوع خاص طراحی شده است. در اینجا یک نکته فنی بسیار مهم وجود دارد: Deep Research یک حالت داخلی و خاص در Discovery AI است. توسعهدهندگان نباید آن را با حالتهای مشابهی که در محصولات سایر شرکتهای AI وجود دارد اشتباه بگیرند؛ زیرا اینها محصولات متفاوتی هستند که صرفاً از یک اصطلاح بازاریابی مشترک استفاده میکنند.
ایلیا آلتوخوف، مدیر فناوریهای تجربی AI در VK، تأکید میکند که ارزش واقعی این سیستم در تحلیل دادههای متقاطع بین سرویسها (Cross-service Data Analysis) نهفته است. با این حال، شرکت هنوز اندازه مدل (Model Size) یا معماری دقیق آن را فاش نکرده است. بنابراین، هرگونه ادعایی که در خلاصههای منابع غیررسمی درباره «میلیاردها پارامتر» یا اندازه «پنجره زمینه» (Context Window) میبینید، در حال حاضر صرفاً گمانهزنی است، زیرا این جزئیات در انتشار رسمی ۱ جولای ذکر نشده بودند و هرگونه عدد و رقم در این مورد غیررسمی است.
درک مفهوم «جستوجوی عصبی»
وقتی کاربران به دنبال «شبکه عصبی برای جستوجوی اطلاعات» میگردند، اغلب تصور میکنند منظور یک محصول واحد است. اما در واقعیت، این درخواست سه دستهبندی کاملاً متفاوت را شامل میشود که درک تفاوت آنها برای مهندسان ضروری است:
۱. جستوجوی عصبی داخلی در سرویسهای شخص ثالث: این دقیقاً همان جایی است که Discovery AI قرار دارد (مثلاً در VK Video یا Zen). شما به عنوان مصرفکننده از آن استفاده میکنید، اما نمیتوانید آن را در وبسایت یا بات شخصی خود ادغام کنید زیرا دسترسی به API آن بسته است.
۲. مدل زبانی به عنوان موتور متصل به دادههای شخصی: این روش با نام تولید بازیابیافزا (RAG - Retrieval-Augmented Generation) شناخته میشود. این همان چیزی است که شما زمانی میسازید که نیاز به جستوجو در مستندات داخلی، کاتالوگها یا آرشیوهای خاص خود دارید تا مدل بر اساس دادههای شما پاسخ دهد.
۳. دستیارهای چت عمومی: اینها از دانش داخلی مدل (که در زمان آموزش یاد گرفتهاند) استفاده میکنند اما جستوجوی لحظهای و دقیق روی دادههای خاص و واقعی شما انجام نمیدهند و در نتیجه مستعد توهم هستند.
مکانیسم یک لایه واحد
آنچه از دیدگاه تحریریه در مورد Discovery AI جذاب است، صرفاً جستوجوی AI نیست، بلکه این واقعیت است که یک موتور واحد، محصولاتی با ماهیت کاملاً متفاوت را سرویسدهی میکند. طبق توصیفات، Discovery AI سه وظیفه متمایز را با یک لایه حل میکند:
- توصیهی محتوا: تصمیمگیری در مورد اینکه بر اساس علایق کاربر، چه چیزی در VK Video و Zen نمایش داده شود.
- تجمیع بافت خبری: جمعآوری اطلاعات مربوط به یک موضوع واحد از منابع رسانهای مختلف و ساخت یک نمای کلی.
- تطبیق زبان طبیعی: متصل کردن پرسشی مانند «فردی برای کوه پیمایی» به پروفایلهای دیتینگ بر اساس تحلیل معنایی.
این موضوع ثابت میکند که ارزش جستوجوی عصبی به ندرت در خودِ مدل است، بلکه در دادههایی است که مدل میتواند به آنها دسترسی داشته باشد. مزیت VK در توانایی مشاهده رفتار کاربر در ویدیوها، فیدها و اپلیکیشنها برای ایجاد یک شخصیسازی واحد (Unified Personalization) است. برای مهندسان، درس کلیدی این است: مدل قابل جایگزینی است، اما دادهها و نحوه برش و ایندکسگذاری آنها، محرک اصلی کیفیت هستند. این فرآیند در واقع تکامل یافتهی همان چرخه تبدیل دادههای خام به استنتاج است که در آن کیفیت دادههای ورودی، تعیینکننده نهایی دقت مدل است.
ساخت جستوجوی عصبی شخصی
برای توسعهدهندگان، Discovery AI یک قابلیت کاربر-محور است و ابزاری نیست که بتوانید در کد خود ادغام کنید. برای دستیابی به نتایج مشابه با دادههای خود، باید یک خط لوله RAG پیاده کنید. این فرآیند شامل ایندکس کردن متون در یک پایگاهداده برداری (مانند Qdrant یا pgvector در Postgres) و بازیابی قطعات مرتبط پیش از ارسال آنها به یک LLM است.

یک خط لوله RAG کاربردی باید این مراحل فنی دقیق را طی کند:
- جمعآوری منبع: استخراج تمام اسناد، مقالهها یا کارتهای اطلاعاتی و تبدیل آنها به فرمت متن ساده (Plain Text).
- تکهبندی (Chunking): شکستن متن به قطعات کوچک ۵۰۰ تا ۱۰۰۰ کاراکتری. باید از یک همپوشانی (Overlap) کوچک بین قطعات استفاده کنید تا معنای جملات در مرزهای تکهها از بین نرود و پیوستگی حفظ شود.
- ساخت ایندکس: اجرای تمام قطعات از طریق یک مدل Embedding و ذخیره بردارهای حاصل در دیتابیس برداری برای جستوجوی سریع.
- پردازش پرسش: محاسبه Embedding برای سوال ورودی کاربر و یافتن N مورد از نزدیکترین قطعات (Top-N) بر اساس شباهت برداری.
- تولید پاسخ: ارسال سوال و قطعات یافته شده به LLM. دستور سیستم (System Prompt) باید مدل را اکراه کند که فقط از متن ارائه شده پاسخ دهد و اگر پاسخ در متن نبود، صراحتاً عبارت «یافت نشد» را بازگرداند.
- ارائه منابع: بازگرداندن لینکها یا ارجاعاتی به قطعات اصلی. بدون این مرحله، کاربران نمیتوانند حقیقت را از «توهمات» AI تشخیص دهند و اعتبار سیستم زیر سوال میرود.
بهینهسازی هزینهها و نقش مدلها
استفاده از مدلهای ردهبالا (High-end) برای تمام مراحل خط لوله جستوجو ضروری و حتی اقتصادی نیست. یک خط لوله RAG حرفهای، نقشها را برای تعادل بین هزینه و کیفیت توزیع میکند:
- Embedding: استفاده از مدلهای Embedding ارزان و سریع برای بردارسازی کل مجموعه داده و پرسشها.
- انتخاب اولیه (Rough Selection): استفاده از مدلهایی مانند DeepSeek یا Qwen برای محدود کردن کاندیداهای احتمالی به صورت ارزان در جریانهای انبوه داده پیش از رسیدن به مرحله نهایی.
- پاسخ نهایی: استفاده از مدلهای قدرتمندی مانند Claude یا GPT برای فرمولبندی نهایی پاسخ، جایی که دنبال کردن دقیق دستورالعملها و کیفیت ادبی متن حیاتی است.
- تحلیل عمیق: استفاده از یک مدل سنگین و پیشرفته برای درخواستهای نادر و پیچیدهای که نیاز به پژوهش عمیق و استدلالهای چند مرحلهای دارند.

برای کسانی که در مناطقی با محدودیتهای پرداخت یا دسترسی هستند، تجمعیکنندگانی (Aggregators) مانند provod.ai یک API واحد و سازگار با OpenAI ارائه میدهند. این به توسعهدهندگان اجازه میدهد تنها با تغییر یک رشته متنی در کد، بین خانوادههای مدل پیشرو مانند Claude 4.6، GPT-5.5، Gemini 3.1، DeepSeek V4 Pro و Qwen 3.6 Plus جابجا شوند. در هنگام کار با این مدلها، بهویژه مدلهای Claude، ممکن است با چالشهای فنی در اتصال مواجه شوید؛ برای این منظور روشهای رفع خطاهای پیکربندی Claude Code راهنمای مفیدی برای عیبیابی اتصال به APIهای سازگار است. پرداختها از طریق موجودی روبل (با کارتهای RF، SBP یا حساب بانکی) با ارائه اسناد کامل برای حسابداری انجام میشود تا مشکلات مالیاتی و قانونی برطرف شود.

در اینجا نحوه تولید پاسخ با استفاده از یک کلاینت سازگار آمده است:
from openai import OpenAI
# فقط کلید و base_url تغییر میکنند
client = OpenAI(
api_key="YOUR_PROVOD_KEY", # جایگزین با کلید شما، در گیت کامیت نکنید
base_url="https://api.provod.ai/v1",
)
def answer(question: str, context_chunks: list[str]) -> str:
context = "\n\n".join(context_chunks)
resp = client.chat.completions.create(
model="claude-sonnet-5", # یا gpt/gemini/deepseek/qwen
messages=[
{"role": "system", "content": "Отвечай только по контексту. Если ответа нет — так и скажи."},
{"role": "user", "content": f"Контекст:\n{context}\n\nВопрос: {question}"},
],
)
return resp.choices[0].message.content
تلههای رایج در پیادهسازی
بیشتر شکستهای جستوجوی عصبی ناشی از آمادهسازی ضعیف دادهها است، نه ضعف مدل زبانی. «تلههای» رایج که باید از آنها دوری کرد عبارتند از:
- قطعات بیش از حد بزرگ: وقتی تکهها خیلی بزرگ باشند، سیگنالهای واقعی در میان نویز گم میشوند و مدل پاسخهای مبهم و کلی میدهد.
- نبود آستانه مرتبط بودن (Relevance Threshold): اگر نزدیکترین قطعه یافت شده همچنان از نظر معنایی دور باشد، سیستم باید پاسخ «یافت نشد» را برگرداند، به جای اینکه مدل را مجبور کند با تخیل پاسخ دهد.
- فقدان استناد (Citations): پاسخهای بدون لینک منبع در محیطهای تجاری غیرقابل اعتماد هستند و کاربر را گمراه میکنند.
- نادیده گرفتن خطاهای API: تایم-اوتها و محدودیتهای نرخ درخواست (Rate Limits) اجتنابناپذیرند. باید فراخوانیها را در منطق Retry با توقفهای زمانی (Exponential Backoff) قرار داد و تمام کدهای پاسخ را لاگ کرد.
- نشت کلیدهای امنیتی: ذخیره کلیدهای API در مخازن کد (Repos) منجر به تخلیه سریع بودجه توسط رباتها میشود؛ همیشه از متغیرهای محیطی یا Secret Managerها استفاده کنید.

توسعهدهندگان میتوانند این گردشکارهای پیچیده را بدون کدنویسی سنگین با استفاده از n8n مدلسازی کنند. یک زنجیره no-code معمولی به این صورت است:
۱. Trigger: دریافت سوال کاربر از طریق یک وبهوک (Webhook) یا پیام دریافتی در یک بات.
۲. HTTP Request: ارسال پرسوجو به دیتابیس برداری برای یافتن برترین قطعات مرتبط.
۳. HTTP Request: فراخوانی یک API سازگار (با استفاده از base_url و کلید دسترسی) برای تولید پاسخ نهایی بر اساس قطعات.
۴. Response: ارسال پاسخ نهایی به کاربر به همراه لینکهای منبع برای تایید صحت.
اگر API در n8n خطای احرازهویت (Authorization) برگرداند، معمولاً به دلیل اشتباه در base_url یا وارد کردن کلید به صورت متن ساده به جای هدر (Header) است. اگر پاسخ در میانه راه قطع شد، محدودیتهای Context Window و املای دقیق نام مدل را بررسی کنید.
تحلیل استراتژیک و محدودیتها
این حرکت VK سیگنال میدهد که مزیت رقابتی واقعی در جستوجوی AI دیگر مدل نیست، بلکه «خندق دادهای» (Data Moat) زیربنایی است. با یکپارچهسازی جستوجو در ویدیو، خبر و دیتینگ، VK در حال ایجاد پروفایلی از کاربر است که بسیار دقیقتر و granularتر از هر موتور جستوجوی سنتی است.
با این حال، درک مرزهای این راهکارها ضروری است تا انتظارات واقعبینانه باشد:
- Discovery AI یک API نیست: شما نمیتوانید روی آن چیزی بسازید. هیچ مستندات عمومی، کتابخانه یا Endpoint ای برای استفاده خارجی وجود ندارد.
- RAG سفارشی جایگزین VK نیست: سیستم شما فقط به اندازه کیفیت و حجم دادههای خودتان خوب خواهد بود؛ شما هرگز دسترسی متقاطع VK بین چندین سرویس عظیم را نخواهید داشت.
- تجمعیکنندهها پلتفرم کامل نیستند: ابزارهایی مثل provod.ai پل پرداخت و API را فراهم میکنند، اما جایگزین پلتفرمهای اتوماسیون (مانند n8n) نمیشوند، زیرساخت on-prem ارائه نمیدهند و منطق پیادهسازی RAG را مدیریت نمیکنند.
- هوش مصنوعی تضمینکننده حقیقت نیست: بدون تعریف دقیق آستانه مرتبط بودن و ارائه منابع، هر جستوجوی عصبی، هر چقدر هم پیشرفته باشد، گاهی با اطمینان کامل توهم میزند.
برای توسعهدهنده مستقل، درس روشن است: مدل قابل جایگزینی است، اما دادهها نه. کیفیت یک سیستم RAG با نحوه برش، پاکسازی و ایندکسگذاری دادهها تعیین میشود، نه با اینکه کدام LLM برای خلاصه نهایی استفاده شده است.



گفتگو