
۱۵۰ دلار و ۴۵۰ میلیون توکن تقریباً یکشبه از حساب تیم Wagtail ناپدید شدند. این جهش هزینهای نتیجهٔ یک اشتباه ساده در انتخاب مدل طی آزمونی در سپتامبر ۲۰۲۶ بود؛ جایی که توسعهدهندگان تصمیم گرفتند یک ماه کامل را صرفاً با مدل GLM 5.3 Flash کدنویسی کنند.
برای بسیاری از برنامهنویسان، جذابیت Vibe Coding (کدنویسی بر اساس حس و شهود) — شبیه به نقاشی سریع روی بوم بدون داشتن پیشطرح دقیق و تکیه بر شهود بهجای معماری سختگیرانه — بسیار زیاد است. اما همانطور که تیم Wagtail دریافت، این رویکرد اگر با الگوهای عاملمحور (Agentic) و مدل اشتباه ترکیب شود، میتواند منجر به نشت شدید بهرهوری شود. این چالشها یادآور هزینههای پنهان Vibe Coding در اپلیکیشنهای پیچیده است که پیشتر به بررسی تضادهای محاسباتی در این رویکرد پرداخته بودیم.
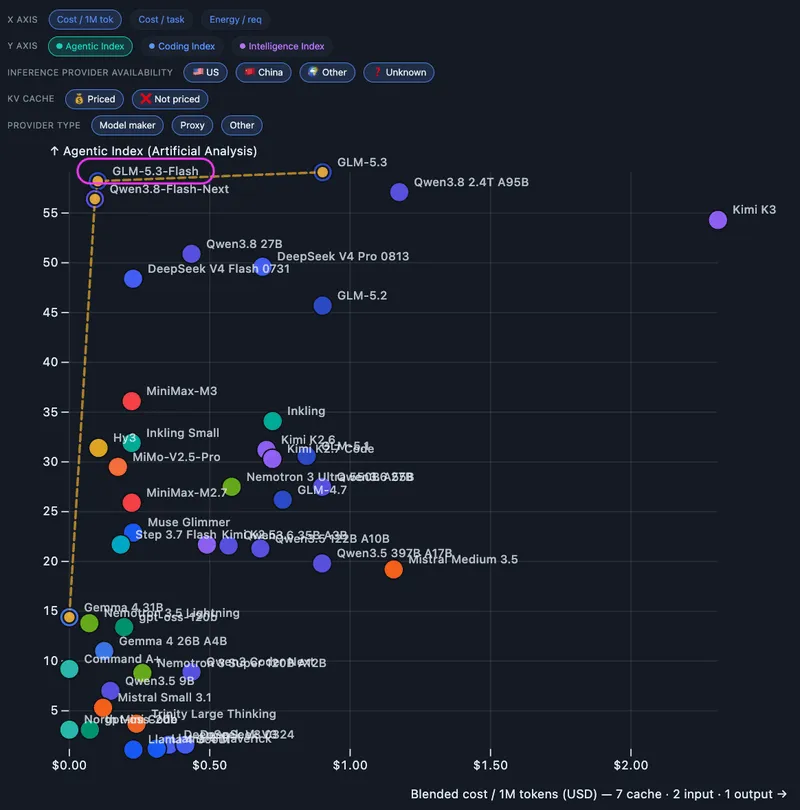
به نقل از گزارش wagtail.org که در ۲ اکتبر ۲۰۲۶ منتشر شد، هدف تیم حفظ یک پشتهٔ فناوری سبک بود. آنها در نیمهٔ اول ماه با موفقیت از GLM 5.3 Flash استفاده کردند و در این بازه تنها ۶۸ دلار هزینه کردند که منجر به تولید ۳۶۵ گرم کربن (تقریباً ۴ کیلووات ساعت انرژی) شد.
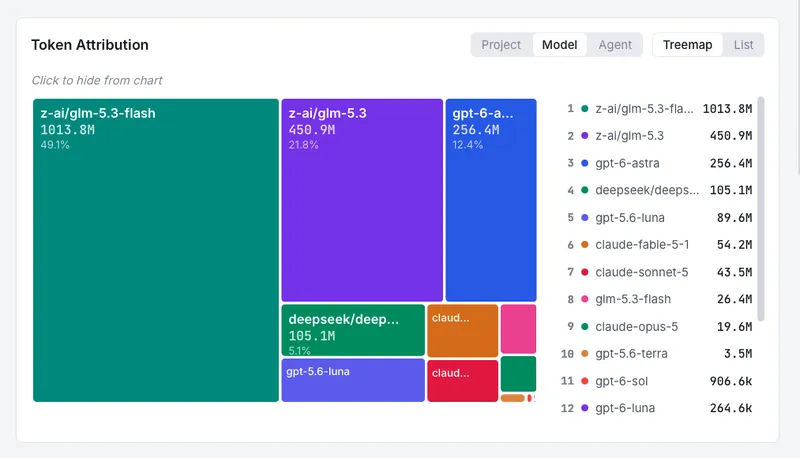
همانطور که در تحلیلهای قبلی ما دربارهی بهینهسازی هزینههای استنتاج اشاره کردیم، توازن بین دقت و هزینه حیاتی است. اما در نیمهٔ دوم ماه، هزینهها بهشدت افزایش یافت. تیم در نهایت چالش را با ۱ میلیارد توکن به مدلهای دیگر به پایان رساند، به این معنی که تنها ۵۰٪ از هدف استفاده از مدل هدف محقق شده است. مصرف کل انرژی نیز بهجای ۱۰ کیلووات ساعت پیشبینی شده، به ۳۵ کیلووات ساعت رسید.
بر اساس مستندات این تیم، سه مانع اصلی شناسایی شد:
هزینهٔ Vibe Coding
یک سرور آزمایشی Wagtail MCP (پروتکل زمینهٔ مدل) بهصورت یک نمونهٔ اولیه با رویکرد Vibe Coding ساخته شد. اگرچه این سرور بهخوبی کار میکند و نمایش عالیای از قابلیتها ارائه میدهد، اما فرآیند توسعه آن بهشدت ناکارآمد بود.
- خطا: تیم مدل «اشتباهی» را برای ساخت این نمونهٔ اولیه انتخاب کرد.
- پیامد: سیستم تقریباً یکشبه ۴۵۰ میلیون توکن — تکههای کوچکی از متن که مدل تکهتکه میخورد — و ۱۵۰ دلار هزینه و ۵ کیلووات ساعت انرژی مصرف کرد.
- درس: با کمی تلاش بیشتر در طراحی و برنامهریزی، میتوانستند به همین نتیجه با هزینهای احتمالاً ۵ برابر کمتر برسند.
ناپایداری زیرساختی
با وجود کارایی مدل، تیم با مشکل در دسترس بودن مواجه شد. چون GLM 5.3 Flash در لبهٔ بهینهٔ عملکرد و هزینه (Pareto frontier) قرار دارد، ارائهدهندگان سرویس استنتاج (Inference) — لحظهای که مدل واقعاً جواب تولید میکند — در مقایسه با آزمایشگاههای بزرگی که GPUها را انبار میکنند، با مشکل ظرفیت مواجه شدند.
- افت عملکرد: تیم متوجه شد که محدودیتهای ظرفیت باعث کاهش کیفیت و عملکرد GLM 5.3 Flash شده است.
- تغییر مسیر: این وضعیت تیم را مجبور کرد به مدلهای مشابهی مثل DeepSeek V4.1 Flash و Qwen 3.8 Flash کوچ کند.
سربار تحقیق و توسعه
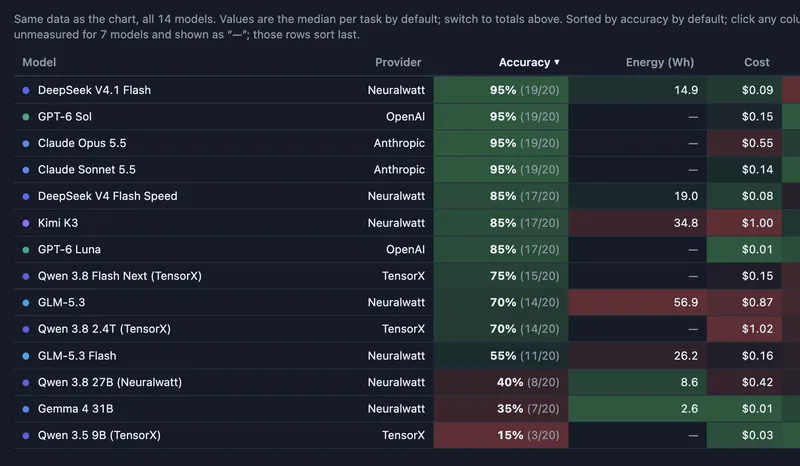
علاوه بر کارهای روزمره، تیم منابع قابل توجهی را صرف محکزنی (Benchmarking) مدلهای مختلف روی وظایف خاص Wagtail کرد تا کاربران را به سمت گزینههای سبکتر هدایت کند. این تحقیق و توسعه برای ساخت یک نمونهٔ اولیه CLI که بهطور بهینه با عاملها (Agents) کار کند، ضروری بود.
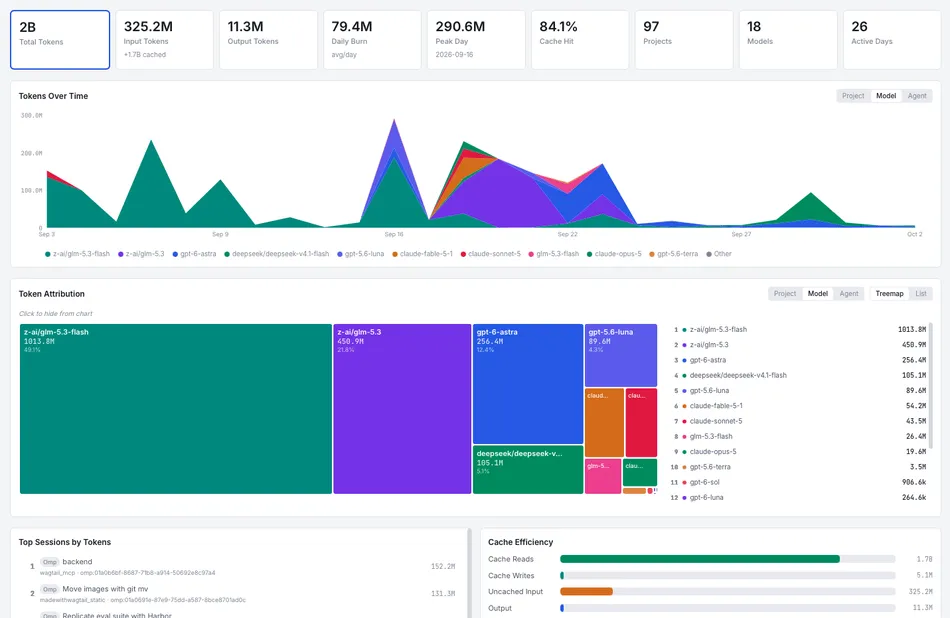
این تجربه ثابت میکند که «تعداد توکنها» معیار بیمعنایی برای موفقیت است. توسعهدهندگان باید موفقیت هوش مصنوعی را با مصرف انرژی و هزینهٔ واقعی مالی بسنجند. انتقال به مدلهای ردهٔ Flash ممکن است، اما تنها در صورتی که با گزارشدهی دقیق مصرف محلی و اهداف محدود برای عاملها همراه باشد.
برای جلوگیری از این اتفاقات، تیم اکنون در حال پیادهسازی یک معماری چندعاملی است. در این ساختار، نقشها به عاملهای سازماندهنده (Orchestrator)، پیشرو (Scout)، اجراکننده (Implementer) و بازبین (Reviewer) تقسیم میشوند تا از مصرف افسارگسیختهٔ توکنها که در سپتامبر دیده شد، جلوگیری شود. آنها همچنین در حال بررسی مدلهای انتشار تصمیمگیری به سبک Jev و جدیدترین مدلهای پرچمدار برای بهرهوری بیشتر هستند.
گام بعدی شما
- اگر از مدلهای Flash برای اتوماسیون استفاده میکنید، حتماً سقف هزینه (Budget Cap) روزانه تعریف کنید.
- برای پروژههای Agentic، بهجای یک مدل همهکاره، از معماری تفکیک نقشها (Orchestrator/Reviewer) استفاده کنید.
- مصرف انرژی و هزینهٔ واقعی را جایگزین معیار تعداد توکن در تحلیلهای خود کنید.
نتایج این تکنیکهای اصلاحشده در رویداد Wagtail Space ۲۰۲۶ در نوامبر منتشر میشود تا ببینیم آیا پشتههای AI سبک در مقیاس واقعی پایدار هستند یا خیر. اما داستان سختافزاری این تحول حتی شگفتانگیزتر است — به تحلیل ما دربارهی تراشههای Blackwell مراجعه کنید.



گفتگو