۶ دلار در برابر ۱۲۷ دلار؛ این شکاف قیمتی تکاندهنده برای پردازش ماهانه ۱۰۰ هزار صفحه جهت تغذیه یک شاخص RAG است. این تفاوت ۲۱ برابری که بر اساس دشواری سایت و انتخاب تامینکننده شکل میگیرد، یک نقطه اصطکاک حیاتی برای توسعهدهندگان هوش مصنوعی ایجاد کرده است: انتخاب بین اجاره یک ناوگان مدیریتشده ضدبات یا مالکیت زیرساخت.
استخراج وب از یک وظیفه ساده استخراج داده به یک مسابقه تسلیحاتی تبدیل شده است. همانطور که وبسایتهای هدف لایههای ضدبات خود را تقویت میکنند، هزینه دسترسی به دادهها افزایش مییابد. طبق گزارش Apify درباره وضعیت استخراج وب در سال ۲۰۲۶ که در ۲۹ ژانویه ۲۰۲۶ منتشر شد، ۶۲.۵٪ از تیمهای استخراج، امسال بیشتر از سال ۲۰۲۵ هزینه زیرساختی پرداخت کردهاند.
این جهش هزینهها به دلیل نیازهای مدل زبانی بزرگ (LLM) — مثل کتابخانهداری که میلیاردها صفحه را خوانده و حالا با همان لحن کتابها جواب میدهد — اتفاق افتاده است. خط لولههای فعلی هوش مصنوعی به دادههای تمیز و بهروز نیاز دارند، اما اکثر URLها اکنون بهجای متن قابل خواندن، مودالهای رضایت، لودرهای اسکلتی یا بستههای جاوااسکریپت ۲۰۰ کیلوبایتی برمیگردانند. توسعهدهندگان اکنون باید تصمیم بگیرند که یک ناوگان مرورگر بدون سر (Headless Browser) بسازند یا برای فعال نگه داشتن یکی از آنها، هزینه API پرداخت کنند. این چالش در واقع بخشی از یک رویه گستردهتر در مدیریت هزینههای توسعه است، جایی که موازنه میان دقت و سهمیههای رایگان در برابر APIهای تجاری به یکی از دغدغههای اصلی سال ۲۰۲۶ تبدیل شده است.
زمینه بازار و پروفایل خریداران
تقاضا برای این ابزارها محدود نیست، بلکه قیمت است که مانع است. نظرسنجی Apify نشان میدهد پروفایل خریداران با آنچه در ارائههای فروش سازمانی (Enterprise) گفته میشود، متفاوت است. بخش بزرگی از کاربران، اپراتورهای کوچک هستند: ۳۵.۸٪ فریلنسر و ۴۹.۱٪ فعال در استارتاپها یا کسبوکارهای کوچک.
فشار مالی بر این تیمها در حال افزایش است. هزینه پروکسی برای ۵۸.۳٪ از پاسخدهندگان نسبت به سال قبل افزایش یافته است. هزینه کل زیرساخت برای ۶۲.۵٪ آنها بالا رفته و تقریباً یکچهارم این تیمها شاهد افزایش بیش از ۳۰ درصدی صورتحسابهای خود بودهاند، زیرا سایتهای هدف لایههای ضدبات تهاجمیتری را پیاده کردهاند.
پذیرش هوش مصنوعی در این تیمها هنوز در حال تکامل است. در حالی که ۶۶.۲٪ قصد دارند ابزارهای کمکی AI را امتحان کنند، ۵۴.۲٪ هنوز هوش مصنوعی را در گردش کار خود ادغام نکردهاند. با این حال، برای اقلیتی که از این ابزارها استفاده میکنند، ۷۲.۷٪ بهبود قابل اندازهگیری در نتایج گزارش کردهاند.
تفکیک هزینهها
برای یافتن هزینه واقعی، پردازش ۱۰۰ هزار صفحه در ماه در پنج تامینکننده تا تاریخ ۳ سپتامبر ۲۰۲۶ قیمتگذاری شد. نتایج نشاندهنده شکاف عمیق بین صورتحسابهای مبتنی بر محاسبات و مبتنی بر رکورد است:
- Zyte: کمترین نرخ نهایی را با ۶ دلار در ماه برای سایتهای ساده ارائه میدهد (با فرض تعهد ماهانه ۵۰۰ دلاری). اما برای سایتهای «سخت» در طرح پرداخت بهازای مصرف، هزینه به ۱۲۷ دلار در ماه میرسد.
- Crawl4AI: ارزانترین گزینه مطلق با ۲۴ دلار در ماه است که در واقع هزینه یک VPS با ۴ گیگابایت رم برای میزبانی ابزار متنباز است.
- Firecrawl: برای ۱۰۰ هزار اعتبار در صورت پرداخت سالانه ۸۳ دلار و در حالت ماهانه ۹۹ دلار هزینه دارد.
- Bright Data: بهازای هر رکورد موفق صورتحساب صادر میکند. نرخ استاندارد ۱ دلار بهازای هر ۱۰۰۰ رکورد (۱۰۰ دلار در ماه) است، هرچند کد تخفیفهایی مانند APIS25 میتواند این مبلغ را برای ۶ ماه به ۷۵ دلار کاهش دهد.
- Apify: بهعنوان بازاری از «اکتورها» (Actors) عمل میکند و بر اساس واحدهای محاسباتی (CU) هزینه میگیرد که هر واحد برابر با ۱ گیگابایت رم برای یک ساعت است. قیمتها بسته به طرح از ۰.۲۰ تا ۰.۱۳ دلار متغیر است.
بررسی عمیق تامینکنندگان
Firecrawl رشد انفجاری داشته و مخزن آن از ۱۷۶ هزار ستاره در گیتهاب عبور کرده است؛ این رقم حتی از مجموع ستارههای پروژههای متنباز Bright Data، Zyte و Apify بیشتر است. این ابزار با بازگرداندن Markdown تمیز یا JSON ساختاریافته در یک فراخوانی، گردش کار را ساده میکند. توابع Scrape, Crawl و Map هر کدام ۱ اعتبار بهازای هر صفحه هزینه دارند و رندرینگ جاوااسکریپت در نرخ پایه گنجانده شده است.
نسخه ۲.۱۱.۰ که در ۱۹ ژوئن ۲۰۲۶ منتشر شد، ویژگیهای کلیدی جدیدی را معرفی کرد:
- یک شاخص پژوهشی شامل بیش از ۳ میلیون مقاله arXiv.
- حذف خودکار اطلاعات شناسایی شخصی (PII).
- فرمت
deterministicJsonکه استخراجکنندههای هر سایت را کش میکند تا در پیمایشهای تکراری، هزینه یادگیری مجدد ساختار صفحه توسط LLM پرداخت نشود.
با این حال، نکاتی وجود دارد. حالت Stealth هزینه را به ۵ اعتبار بهازای هر صفحه میرساند. توابع Search و Interact بالاتر از نرخ پایه هزینه میشوند. همچنین اعتبارها در تمام طرحها بهجز Scale، ماهانه منقضی میشوند. سطوح قیمتی شامل طرح رایگان (۱۰۰۰ اعتبار)، Hobby (۱۶ دلار سالانه/۱۹ دلار ماهانه)، Standard (۸۳ دلار سالانه/۹۹ دلار ماهانه) و Scale (۵۹۹ دلار سالانه/۷۴۹ دلار ماهانه) است. هسته این ابزار تحت AGPL-3.0 و SDKهای آن تحت MIT هستند.
Apify بر انعطافپذیری تمرکز دارد. کاربران میتوانند از ۶۷ هزار اکتور منتشرشده انتخاب کنند یا خودشان بنویسند. این پلتفرم کد بهینه را پاداش میدهد؛ یک اکتور Cheerio که HTML استاتیک را تجزیه میکند ارزان است، اما جایگزینی آن با Playwright برای رندرینگ، واحدهای محاسباتی را چندین برابر سریعتر میسوزاند.
دو تاریخ حیاتی مسیر فعلی Apify را تعریف میکنند:
- ژوئن ۲۰۲۶: فعال شدن x402 که به عاملها اجازه میدهد بهجای موجودی پیشپرداخت، بهازای هر اجرا پرداخت کنند.
- ۱ اکتبر ۲۰۲۶: حذف اجاره ماهانه اکتورها و انتقال تمام اکتورهای منتقلنشده به مدل پرداخت بهازای مصرف.
طرحها شامل Free (۵ دلار مصرف)، Starter (۱۹ دلار در ماه)، Scale (۱۹۹ دلار در ماه) و Business (۹۹۹ دلار در ماه) است. این پلتفرم اختصاصی است، هرچند کتابخانه Crawlee آن تحت Apache-2.0 است.
Crawl4AI جایگزین بدون واسطه است. این ابزار Markdown آماده برای LLM را از طریق Chromium بدون نیاز به صورتحساب فراهم میکند. این پروژه با بیش از ۸۱ هزار ستاره، استخراج هدایتشده توسط LLM و CSS-selector را از طریق یک Image Docker پشتیبانی میکند.
نسخه ۰.۹.۳ که در ۳۱ اوت ۲۰۲۶ منتشر شد، یک بهروزرسانی امنیتی حیاتی بود و ۵ باگ افشا شده، از جمله SSRF در مسیر PDF و نوشتن فایلهای دلخواه (arbitrary file write) را برطرف کرد. اگرچه رایگان و تحت لایسنس Apache-2.0 است، اما هیچ استخر پروکسی مدیریتشده یا SLA ارائه نمیدهد. کاربرانی که این مسیر را انتخاب میکنند، خودشان تبدیل به «تیم پروکسی» میشوند و باید هزینه چرخش IPها را پس از شناسایی توسط سایتهای هدف بپردازند.
Bright Data از یک شبکه عظیم پروکسی مسکونی با ۴۰۰ میلیون IP ماهانه در ۱۹۵ کشور استفاده میکند. مزیت اصلی آن این است که فقط برای رکوردهای موفق هزینه میگیرد و تلاشهای مسدود شده رایگان هستند. این سرویس بیش از ۱۵۰۰ اسکرپر اختصاصی برای سایتهای مختلف ارائه میدهد و از کارهای حجیم تا ۵۰۰۰ URL در هر درخواست پشتیبانی میکند. هیچ مسیر میزبانی شخصی (self-hosted) وجود ندارد و کاتالوگ آن گسترده است و SERP APIها، Unlockerها و مجموعهدادهها را بهعنوان اقلام جداگانه میفروشد.
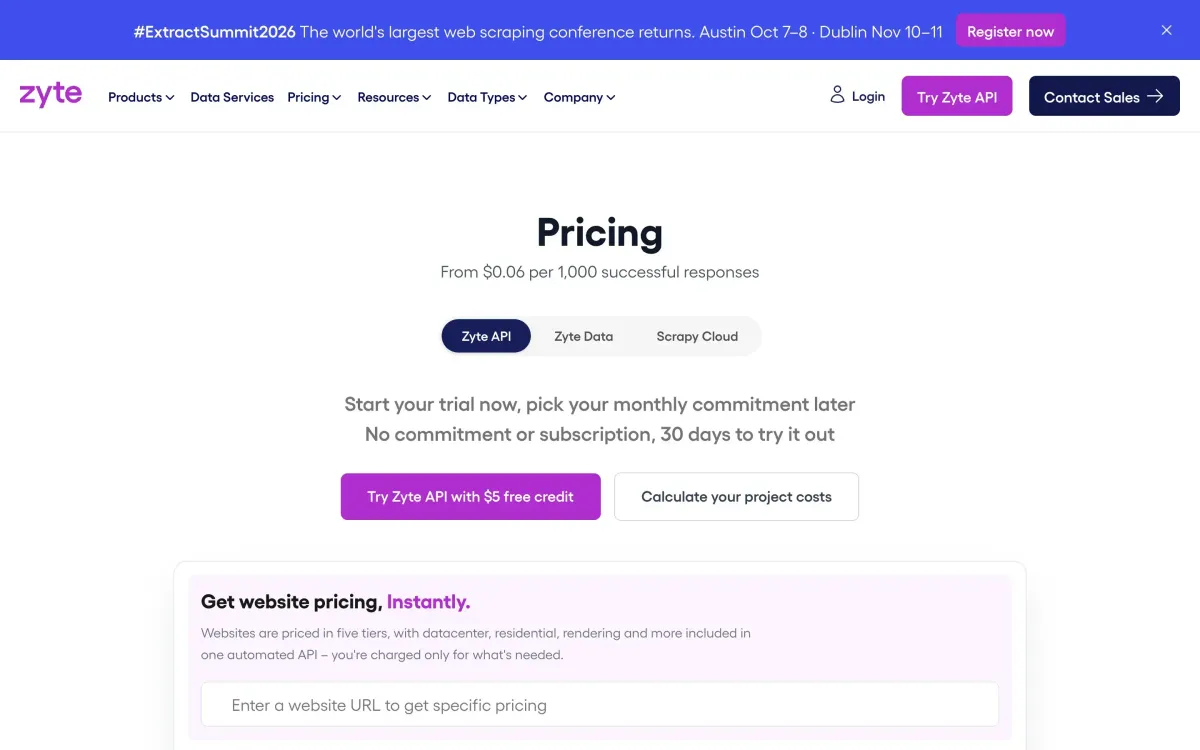
Zyte (که تا فوریه ۲۰۲۱ Scrapinghub نام داشت) تیمی است که Scrapy را توسعه داده است. این شرکت قیمتها را بر اساس دشواری سایت در ۵ سطح، از Simple تا Advanced، تعیین میکند. این موضوع باعث نوسان شدید قیمت میشود؛ ۱۰۰۰ درخواست بسته به پیچیدگی هدف، حالت رندر و سطح تعهد، میتواند بین ۰.۰۶ تا ۱۶.۰۸ دلار هزینه داشته باشد — یک بازه ۲۶۸ برابری در یک جدول قیمت. یک اعتبار آزمایشی ۵ دلاری برای ۳۰ روز در دسترس است. کاربران فعلی Scrapy میتوانند از Scrapy Cloud برای مهاجرتی ارزانتر از بازنویسی اسپایدرها استفاده کنند.
تحلیل استراتژیک
برای توسعهدهنده هوش مصنوعی، این دادهها نشان میدهد که تعداد صفحات خام یک معیار توخالی است. محرک واقعی هزینه، توزیع دامنههای هدف است. پردازش HTML استاتیک پیشپاافتاده است، اما لیستی که تحت تسلط صفحات رندر شده با جاوااسکریپت یا سایتهای دارای CAPTCHA باشد، بودجهای را که بر اساس قیمتهای «سطح ورودی» تنظیم شده، نابود میکند.
ما شاهد شکاف بازار بین «لولهکشی» و «زیرساخت» هستیم. ابزارهایی مثل Firecrawl راحتیِ دادههای آماده برای تولید بازیابیافزا (RAG) — مثل دانشآموزی که قبل از جواب دادن، اول کتاب درسی را باز میکند و از آن نقل میآورد — را میفروشند. در مقابل، Bright Data و Zyte دسترسی به محافظترین گوشههای وب را میفروشند. این تمایل به استفاده از ابزارهای متنباز برای کاهش هزینهها، مشابه روندی است که در مدلهای زبانی دیده میشود، جایی که استفاده از مدلهای وزنباز توانسته است هزینههای APIهای انحصاری را به شدت کاهش دهد.
برای استارتاپها و فریلنسرها — که به ترتیب ۳۵.۸٪ و ۴۹.۱٪ بازار را تشکیل میدهند — ریسک اصلی انتخاب تامینکننده بر اساس دمو است. اکثر دموها از سادهترین سطح سایتها استفاده میکنند و هزینه واقعی تنها زمانی ظاهر میشود که اولین هدف «سخت» مورد اصابت قرار گیرد.
انتخاب پشته تکنولوژی (Stack)
اگر در حال ساخت یک خط لوله RAG هستید و به Markdown بدون مدیریت سرور نیاز دارید، Firecrawl به دلیل اعتبارهای پیشبینیپذیر و کشینگ JSON قطعی، قابلاعتمادترین انتخاب است. اگر هزاران سایت با حجمهای پیشبینیناپذیر دارید، Apify برای کسانی که میتوانند کد اکتور را بهینه کنند بهترین است، در حالی که Bright Data برای کسانی مناسب است که هزینه ثابت بهازای هر رکورد و اسکرپرهای پیشساخته را ترجیح میدهند.
برای کسانی که الزامات سختگیرانه حاکمیت داده دارند یا بودجهشان صفر است، Crawl4AI تنها راه است، به شرطی که آماده مدیریت زیرساخت پروکسی خود باشند. کاربران فعلی Scrapy باید برای جلوگیری از هزینه بازنویسی اسپایدرها، به Scrapy Cloud پایبند بمانند.
قبل از تمدید هر قرارداد استخراج، توسعهدهندگان باید اهداف خود را ممیزی کنند. دامنههای خود را به دستههای استاتیک، رندر شده با JS و محصور (Walled) تقسیم کنید. این توزیع، و نه تعداد کل صفحات، تنها راه پیشبینی دقیق بودجه دادههای هوش مصنوعی برای سال ۲۰۲۷ است. علاوه بر این، لایسنسها را بررسی کنید: AGPL-3.0 (در هسته Firecrawl) مستلزم انتشار تغییراتی است که بهعنوان سرویس شبکه ارائه میشوند، در حالی که Apache-2.0 و BSD چنین الزامی ندارند.
نتیجهگیری
تعداد ستارههای Firecrawl و نظرسنجی Apify به یک نکته اشاره دارند: این دستهبندی رشد کرد چون خط لولههای هوش مصنوعی به آن نیاز داشتند، نه به این دلیل که استخراج وب سادهتر شده باشد. حذف قیمتهای اجارهای Apify در اکتبر ۲۰۲۶ و ارائه شاخص arXiv توسط Firecrawl بهجای فرمتهای خروجی بیشتر، نشان میدهد که بازار هنوز در حال تصمیمگیری است که دقیقاً چه چیزی را میفروشد.
قبل از تمدید هر سرویسی، به این سوال پاسخ دهید: آیا هزینه شما بهازای هر صفحه است یا بهازای هر واحد محاسباتی، و آیا این مدل با محور رشد حجم کاری شما مطابقت دارد؟ هر کدام را که انتخاب کنید، به یاد داشته باشید که HTML خام بهندرت برای پنجرههای متنی (Context Window) ایدهآل است. ابزارهایی مانند HTML Cleaner میتوانند استایلهای داخلی و نویزهای نشانهگذاری را حذف کنند تا در مصرف توکنها صرفهجویی شود، و تبدیلکنندههای JSON به CSV میتوانند به شما کمک کنند تا نتایج را قبل از ورود کامل به سیستم بررسی کنید.
اما داستان سختافزاری این تحول حتی شگفتانگیزتر است — به تحلیل ما درباره تراشههای Blackwell مراجعه کنید.



گفتگو