یک مدل قدرتمند که به یک هارنس ضعیف متصل شده باشد، عاملی هوشمند اما غیرقابلاعتماد میسازد. طبق تحلیل فنی منتشر شده در وبسایت dev.to در ۹ اکتبر ۲۰۲۶، «مغز» یک هوش مصنوعی تنها به اندازه «بدنی» که به آن اجازه عمل میدهد، مؤثر است.
بسیاری از توسعهدهندگان وقتی یک عامل شکست میخورد، بهطور غریزی مدل را مقصر میدانند. اما یک مدل زبانی بزرگ (LLM) — مثل کتابخانهداری که میلیاردها صفحه را خوانده و حالا با همان لحن کتابها جواب میدهد — بهتنهایی فقط میتواند متن پردازش کند؛ او نمیتواند فایلها را باز کند، APIها را فراخوانی کند یا صحت پاسخهایش را بسنجد. مدل حتی به یاد نمیآورد ۱۰ دقیقه پیش چه اتفاقی افتاده است. این شکاف توسط هارنس (Harness) پر میشود؛ همان سیستم معماری که یک مدل ایستا را به یک عامل (Agent) کاربردی تبدیل میکند. این رویکرد نشان میدهد که سیستمهای مدیریت عامل در واقع لایهای حیاتیتر از خودِ هوش مدل در ساخت نرمافزارهای خودگردان هستند.
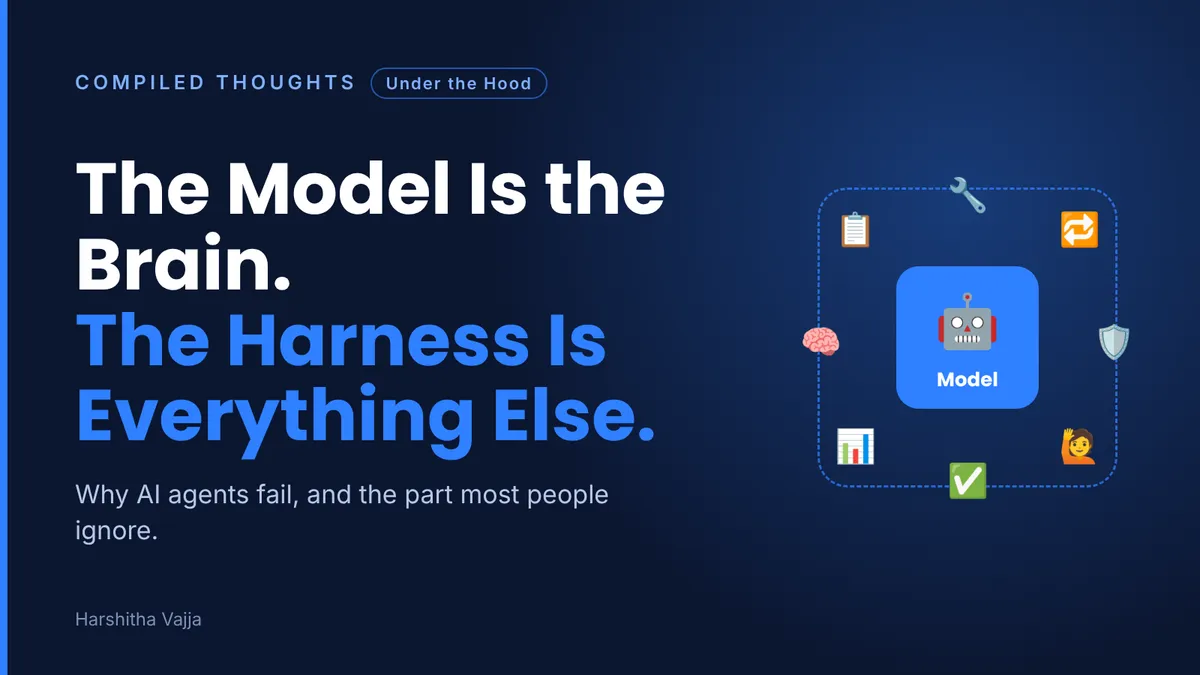
هارنس را شبیه تفاوت بین یک نابغه در اتاقی دربسته و یک متخصص با جعبهابزاری کامل بدانید. در حالی که مدل استدلال را فراهم میکند، هارنس قدرت عمل را میبخشد. بدون آن، عامل صرفاً بر اساس الگوها حدس میزند، نه اینکه با واقعیت تعامل کند. یک راه ساده برای به خاطر سپردن این رابطه این است: عامل = مدل + هارنس.
کالبدشناسی یک هارنس
یک هارنس مستحکم از چندین بلوک سازنده حیاتی تشکیل شده است که عملکرد را دیکته میکند. اگرچه هیچ استاندارد واحدی در صنعت وجود ندارد، اما اکثر هارنسها از این اجزا ساخته شدهاند:
- دستورالعملها: قوانین خاص، اهداف و زمینه پروژه که عامل با آنها شروع میکند.
- ابزارها: رابطهای مجاز برای استفاده، مانند APIها، دسترسی به سیستم فایل، جستوجو یا اجراکنندههای کد.
- حافظه: توانایی حفظ اطلاعات بین مراحل مختلف یا جلسات کاری.
- حلقه کنترل: فرآیند تکرارشوندهی «برنامهریزی $\rightarrow$ اجرا $\rightarrow$ بررسی نتیجه $\rightarrow$ تصمیم برای گام بعدی $\rightarrow$ توقف».
- حفاظها (Guardrails) و بررسیها: محدودیتهای ایمنی (آنچه مدل اجازه ندارد بدون اجازه انجام دهد) و تستهای اعتبارسنجی برای تأیید خروجی.
- گزارشها (Logs) و بازبینی انسانی: ثبت هر گام برداشته شده و مراحل تأیید دستی برای کارهای پرریسک.
هارنس در عمل چگونه عمل میکند؟
برای درک عملی، یک عامل کدنویسی را تصور کنید که وظیفه دارد یک تست شکستخورده را اصلاح کند. مدلی بدون هارنس، صرفاً کدی مینویسد که «درست به نظر میرسد» و امیدوار است کار کند. اما مدلی با هارنس، یک جریان ساختاریافته را طی میکند:
ابتدا، دستورالعملها ساختار پروژه و دستورات خاصی که باید استفاده شوند را توضیح میدهند. سپس، یک ابزار به عامل اجازه میدهد فایل تست و کدی که در حال تست شدن است را بخواند. ابزاری دیگر به او اجازه میدهد تست را اجرا کند تا پیام خطای واقعی را مشاهده کند.
پس از ویرایش کد، سیستم بررسی مجدداً تست را اجرا میکند. اگر باز هم شکست بخورد، حلقه کنترل عامل را برای تلاش دوباره (تا یک حد مشخص و تعیینشده) بازمیگرداند. پیش از هر تغییر ریسکپذیر، یک حفاظ فعال شده و درخواست تأیید انسانی میدهد. تمام این مراحل در گزارشها ذخیره میشود تا شفافیت کامل برقرار باشد. در همین راستا، گزارشهای فنی نشان دادهاند که بهینهسازی لایهی Harness میتواند عملکرد عاملهای کدنویس را تا ۱۳.۷ درصد ارتقا دهد.
این تفاوت ساختاری توضیح میدهد چرا دو تیم با استفاده از یک مدل یکسان، نتایج کاملاً متفاوتی میگیرند. هارنس دقیقاً کنترل میکند که مدل چه ببیند (زمینه)، چه بتواند بکند (ابزارها)، خطاها چگونه شناسایی شوند (بررسیها) و چه زمانی متوقف شود تا زمان و هزینه تحت کنترل بماند.
ریسکهای نادیده گرفتن مهندسی هارنس
نادیده گرفتن مهندسی هارنس به شکستهای پیشبینیپذیری منجر میشود. وقتی یک مدل قدرتمند با یک هارنس ضعیف جفت شود، مشکلات رایج شامل موارد زیر است:
- حلقههای بیپایان: عامل یک گام را تکرار میکند چون هیچ مکانیزمی به او نمیگوید که متوقف شود.
- از دست رفتن زمینه: در میانه یک کار طولانی، تصمیمات قبلی را فراموش میکند.
- خطاهای بررسینشده: پاسخهای غلط بدون هیچ اعتبارسنجی مستقیماً عبور میکنند و پذیرفته میشوند.
- اقدامات ریسکپذیر: بدون مرحله تأیید، فایلها را حذف، ارسال یا تغییر میدهد.
- شکستهای خاموش: چیزی میشکند اما بدون وجود گزارشها (Logs)، نمیتوانید بفهمید چرا این اتفاق افتاده است.
- افزایش هزینهها: هر حلقه اضافی در یک فرآیند خراب، یک فراخوانی پولی دیگر از مدل است.
برای کسانی که عامل میسازند، تمرکز باید از بنچمارک مدلها به پنج پرسش کلیدی تغییر کند: آیا عاملم قوانین را میشناسد؟ آیا فقط ابزارهای لازم را دارد؟ چگونه کارش را بررسی میکند؟ چه زمانی متوقف میشود؟ و آیا میتوانم ببینم چه کرده است؟
در نهایت، در حالی که یک مدل بهتر، عامل را هوشمندتر میکند، تنها یک هارنس بهتر است آن را قابلاعتماد میسازد. مزیت رقابتی در هوش مصنوعی عاملمحور از انتخاب LLM به سمت مهندسی سیستم پیرامونی آن در حال تغییر است.
گام بعدی شما
- در طراحی عاملهای خود، ابتدا روی تعریف «حلقه کنترل» و «توالی توقف» تمرکز کنید تا از حلقههای بیپایان جلوگیری شود.
- برای هر ابزاری که به مدل میدهید، یک لایه اعتبارسنجی (Validation) در هارنس تعریف کنید تا خروجی ابزار پیش از پذیرش بررسی شود.
- سیستم گزارشدهی (Logging) را به گونهای طراحی کنید که بتوانید هر تصمیم مدل را به یک ابزار یا دستورالعمل خاص متصل کنید.
اما داستان سختافزاری این تحول حتی شگفتانگیزتر است — به تحلیل ما دربارهی تراشههای Blackwell مراجعه کنید.



گفتگو