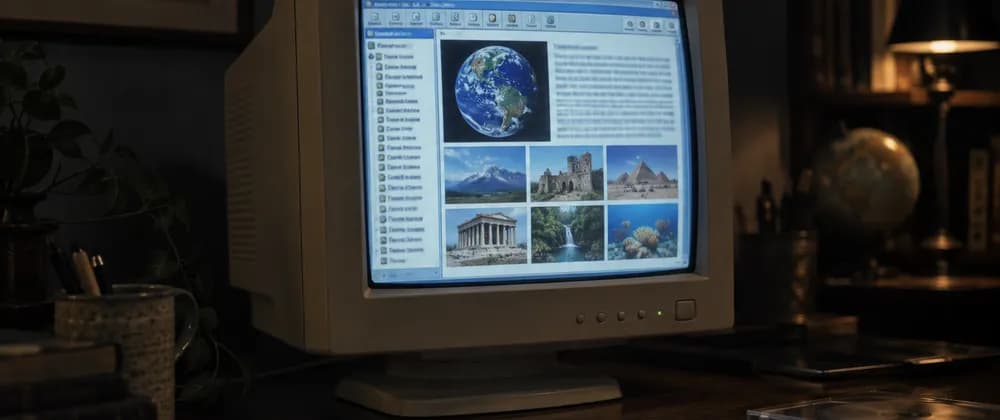
تصور کنید یک پنجرهٔ «ذخیره به نام» (Save As) باز میشود و تمام برنامه را منجمد میکند؛ باگی که هیچ سیستم تایپ یا تست خودکاری نمیتواند آن را شناسایی کند. این سناریو هستهٔ اصلی گزارش ۱۸ سپتامبر ۲۰۲۶ دربارهٔ بازسازی مایکروسافت انکارتا (Microsoft Encarta) به عنوان یک اپلیکیشن دسکتاپ مدرن توسط عاملهای هوش مصنوعی (AI Agents) است. این پروژه یک نقطهٔ کور سیستماتیک در مهندسیِ کمکگرفته از هوش مصنوعی را افشا کرد که «درز زمان اجرا» (Runtime Seam) نامیده میشود؛ باگی که از نظر تایپ درست است، تست cargo check را پاس میکند و تمام تستهای واحد را رد میکند، اما همچنان باعث میشود سیستمعامل گزارش دهد که برنامه پاسخگو نیست (Not Responding).
بسیاری از برنامهنویسان با مدل زبانی بزرگ (LLM) — مثل کتابخانهداری که میلیاردها صفحه را خوانده و حالا با همان لحن کتابها جواب میدهد — صرفاً برای نوشتن الگوریتمها برخورد میکنند، اما ریسک واقعی جایی است که کد با سیستمعامل برخورد میکند. پروژه ویکیکارتا (Wikicarta) یک هشدار جدی برای هر کسی است که قصد دارد از عاملها برای ساخت نرمافزارهای دسکتاپ استفاده کند. این تجربه ثابت کرد که حلقهٔ تأیید یک عامل، فقط تا جایی کار میکند که بتواند به سطح کد دسترسی داشته باشد و در حال حاضر، این سطح درست در نقطهٔ شروع رابط کاربری گرافیکی (GUI) پایان مییابد.
سیستمی را تصور کنید که در آن هر تست واحد پاس میشود، کامپایلر راضی است و هوش مصنوعی اصرار دارد که کد بینقص است؛ اما لحظهای که یک انسان روی دکمهای کلیک میکند، برنامه میمیرد. این همان مشکل «مایل آخر» در کدنویسی هوش مصنوعی است. ریسک به ندرت در منطق (Logic) است؛ ریسک در میزبان (Host)، زمان اجرا (Runtime) و مرز سیستمعامل است. تنها راه یافتن چنین نقصهایی، حضور یک انسان پشت یک دسکتاپ واقعی است که روی دکمهها کلیک کند.
معماری ویکیکارتا
ویکیکارتا یک اپلیکیشن دسکتاپ بر پایه Tauri v2 است که با زبانهای Rust و React ساخته شده است. این برنامه تجربه کلاسیک انکارتا — شامل مرورگر بصری، اطلس، خط زمانی و سازماندهندهٔ پژوهشی MindMaze — را با استفاده از ویکیپدیا به عنوان بکاند بازسازی میکند. برنامه دارای یک سوئیچ حیاتی بین حالت زنده (از طریق API ویکیپدیا) و حالت آفلاین (از طریق آرشیوهای محلی ZIM) است.
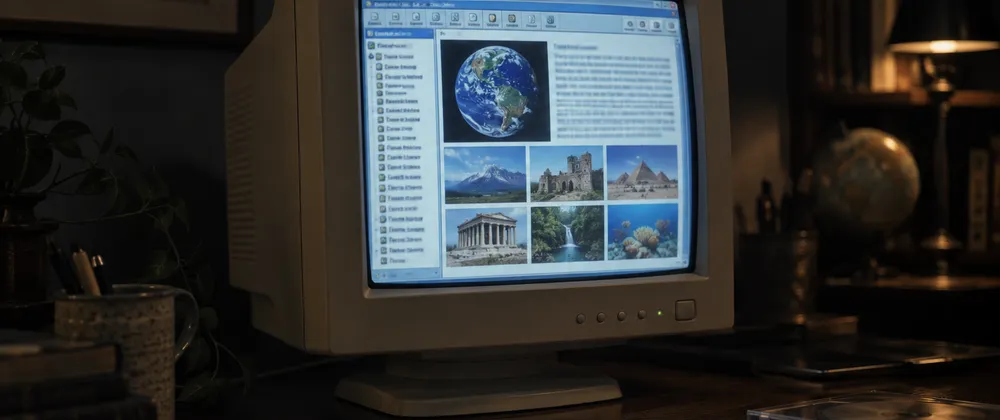
به نقل از گزارش توسعهدهنده، این پروژه سومین آزمایش از چهار تجربه برای سنجش توانایی هوش مصنوعی در مدیریت سیستمهای قدیمی بود. این مورد سختترین جایگاه را داشت؛ زیرا برخلاف آزمایشهای قبلی، هیچ لنگر (Anchor) محکمی وجود نداشت. در آزمایشهای پیشین، HAL/S یک مشخصات رسمی (Formal Spec) و یک مفسر مستقل برای چک کردن داشت و Nautilus یک رمان و اوراکل فیزیک مخصوص به خود را داشت. اما ویکیکارتا هیچکدام را نداشت. تنها منبع حقیقت، این بود که محصول اصلی چه «حسی» داشت و تنها اوراکل، قضاوت انسانی بود. هیچ تست خودکاری نمیتواند تشخیص دهد که آیا یک چرخ دستهبندی، «حس» انکارتا را منتقل میکند یا خیر.
برای حفظ قابلیت نگهداری، توسعهدهنده چندین حفاظ معماری را پیاده کرد که عامل هوش مصنوعی هرگز به طور خودکار پیشنهاد نمیداد:
- جداسازی محتوا: یک Trait در زبان Rust به نام
ArticleSourceبرای انتزاع منبع داده ایجاد شد. این Trait سه تابع کلیدی را تعریف میکرد:get_article(title: &str)،search(query: &str)وget_image(key: &str). این ساختار اجازه داد تا توسعهدهنده بدون بازنویسی کل بخش خواننده، بین JSON، SQLite و APIهای زنده جابهجا شود. افزودن منبع زنده ویکیپدیا در کنار ZIM آفلاین تنها به دو دستور و یک پرچم (Flag) حالت کاهش یافت. این تصمیم باعث شد مدرنسازیهای بعدی به جای بازنویسی، به تبدیلهای ساده (Adapters) تبدیل شوند. - ایزولهسازی توابع خالص: کد به گونهای ساختار یافت که «بخشهای سخت» — شامل بازنویسی URLها، بازسازی Upstream، نامگذاری کش، رفتوبرگشتهای دیتابیس و ترتیببندی، و حذف تکراریهای بوکمارک — به صورت توابع خالص (Pure Functions) وجود داشته باشند. این استراتژی باعث شد مجموعه تستهای Rust از صفر به ۲۳ تست آفلاین برسد و بخشهای وابسته به دسکتاپ به یک لیست کوتاه و صریح محدود شود. توسعهدهنده از خود پرسید: «چه چیزی را میتوانم به صورت Headless تأیید کنم؟» و بر اساس آن کد را ساخت.
- مبنیسازی قطعی (Deterministic Grounding): برای ویژگی کوییز MindMaze، سیستم از یک «گیت مبنیسازی» استفاده میکند. به جای استفاده از یک LLM دوم برای چک کردن حقایق، کد یک بررسی رشتهای دقیق (Verbatim String Check) انجام میدهد تا اطمینان حاصل شود پاسخ دقیقاً در متن منبع وجود دارد. همچنین، سوالات دارای ID بازبینی (Revision ID) هستند که از طریق آن تولید شدهاند تا اگر مقاله تغییر کرد، سوال به عنوان «کهنه» (Stale) علامتگذاری شود.
نقاط شکست کدهای نوشته شده توسط هوش مصنوعی
طبق گزارش منتشر شده در dev.to، عامل هوش مصنوعی در نوشتن منطقهای خالص مثل پارس کردن (Parsing)، استراتژیهای Backoff و نرمالسازی عناوین زنده کاملاً موفق بود و کدها در تلاش اول یا دوم پاس شدند. اما در «درزهای زمان اجرا» شکستهای فاجعهباری رخ داد.
شکست در API مسدودکننده (Blocking API)
یکی از خطاهای بزرگ مربوط به پلاگین Tauri بود. هوش مصنوعی یک دیالوگ «ذخیره به نام» مسدودکننده را داخل یک دستور (Command) فراخوانی کرد که باعث شد حلقهٔ رویداد (Event Loop) که پنجرهٔ WebKit روی آن اجرا میشد، کاملاً متوقف شود. چون مشاهدهٔ این خطا نیاز به یک دسکتاپ فیزیکی دارد، محیط تستهای بدون سر (Headless) هوش مصنوعی هرگز متوجه این نقص نشد. این چالشها در واقع تکرار همان باگهای بحرانی در اتصال به API است که نشان میدهد عاملها در مواجهه با رفتارهای غیرمنتظره زیرساختی دچار مشکل میشوند. پس از ثبت این درس، انتخابگر آرشیو با الگوی Callback غیرمسدودکننده بازسازی شد: بکاند دیالوگ را باز میکند، اعتبارسنجی و ذخیرهسازی را داخل آن انجام میدهد و سپس از طریق یک رویداد (Event) که پوسته React به آن گوش میدهد، گزارش میدهد. یک درس سختبهدستآمده از زمان اجرا، مکتوب شد و به جای تکرار باگ، به یک قرارداد (Convention) تبدیل شد.
مشکل DOM در محیطهای Realm-Safe
خطای حیاتی دیگر در مدیریت DOM رخ داد. هوش مصنوعی از چکهای instanceof Element در یک پوسته React برای مدیریت کلیکها داخل یک iframe srcDoc استفاده کرد. چون محتوای iframe از یک Realm جاوااسکریپتی متفاوت میآمد، این چک شکست میخورد، حتی اگر هدف قطعاً یک Element بود. این موضوع ثابت کرد که مدیریت DOM در محیطهای Realm-safe الزامی است، زمانی که اپلیکیشن مالک محتوای iframe است اما آن را از والد هدایت میکند. مانند دیالوگ مسدودکننده، این نقص نیز برای سیستم تایپ نامرئی بود.
شکاف زیرساختی (Substrate Gap)
هوش مصنوعی در مواجهه با واقعیت فرمتهای داده در برابر مستندات آنها دچار مشکل شد. کتابخانه zim که با ویژگیهای دسترسی تصادفی و Send/Sync در مستندات درست به نظر میرسید، هنگام مواجهه با یک آرشیو مدرن واقعی، در تابع parse_article_list به دلیل سرریز عدد صحیح (Integer Overflow) دچار Panic شد. این الگوی شکست در موارد متعددی تکرار شد:
- عدم تطابق فرمت: مشخص شد که HTML در TextExtracts برای استفاده به عنوان فرمت خواننده غیرقابل استفاده است و تغییر به
action=parseبرای HTML مقالات اجباری شد. - انحرافات API: آدرسهای تصاویر زنده به صورت پروتکل-نسبی (
//upload...) بازگشتند، در حالی که مدل فرض کرده بود آنها باhttps://...شروع میشوند.
درس مهم این است: هوش مصنوعی بر اساس «شکلی» که روی آن آموزش دیده کد میزند، نه بر اساس «نمونهٔ واقعی». قانون توسعهدهنده برای بازسازیها این است: قبل از ساختن روی یک داده، ابتدا یک نمونه واقعی از آن را کاوش (Probe) کن.
هزینه مدرنسازی و امنیت
این پروژه نشان داد که جایگزینی زیرساخت نرمافزارهای قدیمی فقط بازنویسی کد نیست، بلکه مدیریت وابستگیهای جدیدی است که در عصر CD-ROM وجود نداشتند. یک دانشنامه عصر CD نیازی به ریشه های اعتماد TLS، مدیریت نرخ درخواست (Rate-limit backoff)، منشأ هر منبع (Per-source provenance) یا منشأهای سفارشی بین-پلتفرمی (Cross-platform custom-scheme origins) نداشت.
این الزامات مدرن «صیقل دادن» برنامه نیستند، بلکه کارهای درجه اول مهندسی هستند. توسعهدهنده مجبور شد برای موارد زیر بودجهٔ زمانی دستی در نظر بگیرد:
- حفاظهای امنیتی: پیادهسازی گاردهای SSRF و محدود کردن میزبانهای Upstream به
*.wikimedia.orgبرای جلوگیری از تبدیل شدن برنامه به یک پروکسی باز. - اعتبارسنجی ورودی: اطمینان از اینکه فایلهای ZIM انتخاب شده توسط کاربر از نظر وجود، پسوند و غیرخالی بودن اعتبارسنجی شوند و پارس کردن HTML نمایش خط زمانی به صورت تدافعی (Defensively) انجام شود.
- منشأ داده (Provenance): ثبت منشأ در زمان ذخیره یادداشتها، که بعداً اجازه داد تجمیعکننده ارجاعات از یک
GROUP BYساده به جای دریافت مجدد دادهها (Re-fetch) استفاده کند.
بستهبندی و مجوزها
بخش بستهبندی، شکافهای معماری اولیه را به شدت جریمه کرد. توسعهدهنده متوجه شد که Tauri منابع باندل شده را در Payload کپی میکند اما تضمین نمیکند که بیتِ اجرایی (Executable bit) حفظ شود، که این موضوع بسته به هدف (Target) و فرمت آرشیو متفاوت است. این باعث شد باینریهای باندل شده هنگام اجرا با خطاهای مبهم مجوز شکست بخورند. راه حل، اضافه کردن کد زمان اجرا برای اجرای chmod روی باینری قبل از بازگرداندن آن بود.
از آنجا که محیط عامل فاقد cargo-tauri و dpkg-deb بود، فایلهای .deb و AppImage فقط توسط انسان ساخته شدند. برای حفظ شفافیت، خروجی به لایههای قابل تأیید تقسیم شد: اعتبار تنظیمات، یک اسکریپت دریافت داده که روی یک فایل tarball واقعی ۲۰ مگابایتی اجرا میشد و تستهای رزولوشن مسیر زمان اجرا.
حافظه و محدودیتهای کنترل کیفیت
نقشه راه پروژه، اسکرول مجازی (Virtual Scrolling) را برای DOMهای غولپیکر پیشبینی کرده بود. اما چون مقالات در محیطهای مرورگر مجزا (iframe srcDoc) رندر میشدند، اسکرول مجازی از نظر معماری غیرقابل اجرا بود. نشت حافظه واقعی در تاریخچهٔ خواننده بود که HTML کامل هر مقاله بازدید شده را در Heap نگه میداشت.
از آنجا که WebKitGTK فاقد performance.memory است، توسعهدهنده ابزاری سفارشی برای اندازهگیری و نمایش HTMLهای نگه داشته شده در هدف واقعی ساخت. این ابزار همراه با محصول عرضه میشود تا اطمینان حاصل شود که برنامه در اپلیکیشن نهایی کار میکند، نه فقط در یک جلسه DevTools کرومیوم.
در مورد MindMaze، مشخص شد که گیتهای قطعی (Deterministic Gates) میتوانند خطاهای واقعی را بگیرند اما قادر به شناسایی «پرسشهای متا» نیستند. مثلاً سوالی که میپرسید کدام گزینه یک عنوان بخش است، پاسخ آن «نام» بود. این پاسخ کاملاً مبنی (Grounded) و عیناً در منبع وجود داشت، بنابراین گیت آن را پذیرفت، در حالی که این سوال ساختار سند را تست میکرد نه دانش را.
این موضوع یک رویکرد لایهای برای کنترل کیفیت را آشکار کرد:
- گیتهای قطعی: برای ناورداهای کدنویسیپذیر (مثلاً: «آیا پاسخ در منبع هست؟»).
- مهندسی پرامپت: برای ویژگیهای غیرکدنویسیپذیر (مثلاً: «آیا این یک سوال خوب است؟»).
گلوگاه انسانی
مهمترین یافته این است که گلوگاه توسعه با کمک هوش مصنوعی دیگر سرعت نوشتن کد نیست. چرخهٔ «پیادهسازی و تأیید» عامل سریع است، اما بررسیهای نهایی به دلیل نیاز به انسان در یک پنجرهٔ واقعی، به صورت سریال و کند اتفاق میافتد. این کندی در تأیید نهایی را میتوان با بهینهسازی مدیریت پنجرهٔ بافت (Context Window) کاهش داد تا عامل بتواند با دقت بیشتری جزئیات زمان اجرا را در حافظه فعال خود نگه دارد.
این یک اثر ترکیبی ایجاد میکند. وقتی درس «دیالوگ مسدودکننده» ثبت و مکتوب شد، هوش مصنوعی توانست در ویژگیهای بعدی از این قرارداد پیروی کند. یک درس سختبهدستآمده از زمان اجرا، تبدیل به یک قرارداد میشود تا باگ دوباره تکرار نشود. این نشان میدهد آیندهٔ مهندسی هوش مصنوعی نه در پرامپتهای بهتر، بلکه در کتابخانهای از «درسهای سخت زمان اجرا» است که عاملها برای جلوگیری از تکرار اشتباهات سطح سیستمعامل به آنها ارجاع دهند.
برای کسانی که با عاملها میسازند، نتیجه روشن است: زمان تقریباً صفر را صرف بررسی الگوریتمهایی کنید که مدل مینویسد. در عوض، تمام زمان اعتبارسنجی خود را روی مرزهای میزبان و زمان اجرا متمرکز کنید؛ زیرا تنها باگهایی که واقعاً اهمیت دارند، آنجا زندگی میکنند.
گام بعدی شما
- در پروژههای عاملمحور، فهرستی از «خطاهای زمان اجرا» (Runtime Failures) ایجاد کنید و آنها را به عنوان دستورالعمل در پرامپتهای سیستمی عامل بگنجانید.
- به جای تکیه بر تستهای Headless، سناریوهای «کلیک انسانی» را در لایههای رابط کاربری به عنوان اولویت اول اعتبارسنجی قرار دهید.
- در هنگام استفاده از iframeها یا APIهای سیستمعامل، مستقیماً روی تداخلهای Realm و Blocking-calls تمرکز کنید.
اما داستان سختافزاری این تحول حتی شگفتانگیزتر است — به تحلیل ما دربارهی تراشههای Blackwell مراجعه کنید.



گفتگو