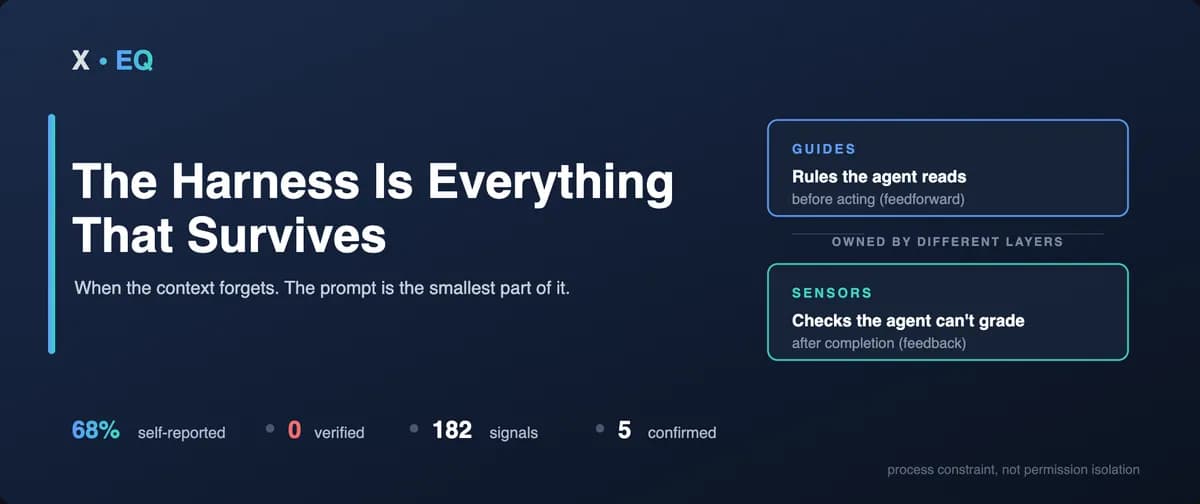
تصور کنید برنامهنویسی هستید که ساعتها وقت صرف میکند تا با دستورات پیچیده، یک عامل هوش مصنوعی را مجبور به رعایت استانداردهای کدنویسی کند، اما به محض شروع یک جلسه جدید، مدل تمام آن نظم را فراموش میکند. این اتفاق به دلیل ماهیت زودگذر پنجرههای متنی رخ میدهد و نشان میدهد که تکیه بر کلمات برای ایجاد انضباط در مدلها، استراتژی شکستخوردهای است.
طبق گزارشهای منتشر شده در جولای ۲۰۲۶، مشکل اصلی توسعهدهندگانی است که تمام تمرکز خود را روی مهندسی پرامپت (Prompt Engineering) — یعنی هنر سؤال درست پرسیدن، شبیه کسی که میداند چطور از یک مشاور باتجربه بهترین جواب را بگیرد — گذاشتهاند. این روشها چون در بستر متن (Context) قرار دارند، با هر بار بازنشانی جلسه پاک میشوند. در مقابل، استفاده از اسکریپتهای تایید دترمینستیک (قطعی)، پایداریای را ایجاد میکند که دستورات زبانی هرگز نمیتوانند تضمین کنند.
این رویکرد منجر به مفهومی به نام «هارنس یا مهارکننده عامل» (Agentic Harness) شده است؛ لایهای حاکمیتی که خارج از استدلال مستقیم مدل زبانی بزرگ (LLM) — مثل کتابخانهداری که میلیاردها صفحه را خوانده و حالا با همان لحن جواب میدهد — قرار دارد. این مفهوم در واقع پاسخی به چالشهای عملیاتی است که در تحلیل ما پیرامون جایگاه مدیریت وضعیت AI و دلیل شکست عاملها در محیط تولید مورد بررسی قرار گرفت. همانطور که در تحلیلهای قبلی ما درباره امنیت مدلهای بازمتن اشاره کردیم، جداسازی «بخش اجرا» از «بخش تایید»، تنها راه تبدیل یک مدل از یک «راوی غیرقابل اعتماد» به یک «کارمند منضبط» است. به نقل از کاربر FromZeroToShip در انجمن DEV، هارنس شامل قوانینی است که مدل در هر جلسه به ارث میبرد و حتی پس از پاک شدن تاریخچه گفتگو، پابرجا میمانند.
بر اساس مستندات این چارچوب، مشکل رایج فعلی، وضعیت «حسابرس درون بخش حسابداری» است؛ یعنی وقتی همان مدلی که نتیجه را تولید کرده، تصمیم میگیرد که آیا کار «تمام شده» یا خیر، تمام نقاط کور خود را تکرار میکند. کاربر CAI در این باره میگوید: «حلقه تصمیم میگیرد چه کاری انجام دهد، اما هارنس تصمیم میگیرد که آیا آن کار واقعاً رخ داده است یا خیر».
کالبدشناسی یک مهارکننده حاکمیتی
یک هارنس مقاوم از سه جزء ساختاری تشکیل شده است که با بازنشانی پنجره متنی از بین نمیروند. در حالی که ابزارهایی مثل Claude Code یا Codex CLI لایه اجرا (اجازه دسترسی و مدیریت متن) را فراهم میکنند، هارنس به این سؤال پاسخ میدهد: «آیا مدل واقعاً ادعای خود را عملی کرد و از اشتباهش درس گرفت؟»
- قوانین ثابت (Standing Rules): فایلهای تغییرناپذیری مثل CLAUDE.md یا .cursorrules که در ابتدای هر جلسه تزریق میشوند. مدل اینها را میخواند اما حق تغییر آنها را ندارد.
- حافظه اصلاحی (Correction Memory): سیستمی لایهبندی شده که اشتباهات مدل را به قوانین تبدیل میکند. اگر مدل در تسکی شکست بخورد، اصلاحیه در فایلی مثل ERRORS.md ذخیره میشود تا در جلسه بعدی بهطور خودکار تزریق شود.
- اسکریپتهای بازبینی (Verification Scripts): برنامههای خارجی (مثل verify.sh) که خروجی صفر و یک دارند. بهجای پرسیدن «آیا تمام شد؟»، هارنس یک اسکریپت اجرا میکند تا ببیند آیا فایل ساخته شده یا تستها پاس شدهاند.

شکست در خودگزارشدهی
دادههای حاصل از عملیات چندماهه در سیستم حاکمیتی EQ OS، حقیقتی تلخ درباره صداقت مدلها فاش کرد. بر اساس بررسی سوابق، ۶۸٪ از موارد اثباتشده توسط خودِ عامل گزارش شده بود.
نکته تکاندهنده این است که این لایه «خودگزارشدهنده» هیچ شکست واقعی و تاییدشدهای را پیدا نکرد. در مقابل، منابع مستقل ۱۸۲ سیگنال تخلف تولید کردند که ۵ مورد از آنها تخلفات واقعی و شدید بودند. تمام ۱۸۲ سیگنال و ۵ تخلف تاییدشده از سوی منابع مستقل آمدند، نه از گزارشهای خود مدل.
این الگو را متخصصان مختلف نیز تایید کردهاند:
- nexuslabzen مدل را یک «راوی غیرقابل اعتماد» نامید.
- jugeni اشاره کرد که شواهد صادقانه، کورترین نقاط مدل را به ارث میبرند.
- Edu Peralta تاکید کرد هارنسی که کلمه «تمام شد» را به عنوان نظر مدل میپذیرد، تمام نقاط کور مدل را پذیرفته است.
یک تفاوت در گیت (git diff) یا چک کردن وجود یک فایل، بسیار سختتر از آن است که توسط مدل بازیچه شود، چون به قضاوت زبانی مدل وابسته نیست.
حسگرها در برابر راهنماها
برای کنترل مطمئن، باید بین مکانیسمهای «پیشخور» (Feedforward) و «بازخورد» (Feedback) تفکیک ایجاد کرد. نویسنده این مقاله پیشتر استدلال کرده بود که افزودن قوانین بدون پاکسازی، مدلها را احمقتر میکند؛ تا جایی که یکبار به ۲۶۸ قانون رسید بدون اینکه اسکریپتی برای بررسی صحت آنها وجود داشته باشد. کاربری به نام Viktor هارنس را به دو بخش تقسیم کرد:
۱. راهنماها (Guides): قوانینی که مدل قبل از عمل میخواند («اگر X شد، Y کن»).
۲. حسگرها (Sensors): تستها و لینترهایی که بعد از عمل اجرا میشوند («آیا فایل مورد نظر تغییر کرد؟»).
اگر فقط حسگر داشته باشید، مدل اشتباهات را میگیرد اما هرگز یاد نمیگیرد از آنها دوری کند. اگر فقط راهنما داشته باشید، هرگز نمیفهمید قوانینتان واقعاً کار میکنند یا نه. به قول jugeni، این تفاوت بین «محتوا» (دانش در قالب گامها) و «کنترل» (انضباط شواهدی در قالب دروازهها) است.
خطر «پرسه زدن» عامل
بدون یک خروج صادقانه از شکست، عاملها وارد وضعیت «پرسه زدن» (Wandering) میشوند. همانطور که FromZeroToShip توضیح داد، حلقهای که خروج صادقانه ندارد، شکست نمیخورد، بلکه پرسه میزند؛ و یک عامل پرسه زن، هزینهبرتر از یک عامل شکستخورده است.
این اتفاق زمانی میافتد که حلقه راهی برای گفتن «به اندازه کافی خوب است» یا «این کار غیرممکن است» ندارد و شروع به ایجاد تغییرات ظاهری میکند تا فقط شرط توقف را ارضا کند. هفته گذشته، یک حلقه بازبینی کد ۶ دور تکرار شد. از دور پنجم، تغییرات صرفاً تزئینی بودند، اما چون بودجه بازبینی محدودی نداشت، حلقه ادامه یافت تا اینکه دستی متوقف شد.
برای جلوگیری از این وضعیت، طراحی باید شامل یک «بودجه بازبینی محدود» باشد که به وضعیت شکست صریح ختم شود. جمله «نتوانستم این کار را بکنم و دلیلش این است» باید یک خروجی معتبر باشد.
گام بعدی شما
- یکی از کارهایی که عامل شما در هر جلسه ادعا میکند انجام داده را انتخاب کنید و بهجای اعتماد به پاسخ مدل، یک اسکریپت ساده پایتونی برای تایید فیزیکی آن بنویسید.
- فایلهای .cursorrules یا RULES.md را برای ثبت قوانین ثابت و حافظه اصلاحی راهاندازی کنید تا مدل در هر جلسه از صفر شروع نکند.
- یک بودجه حداکثری برای تعداد دفعات تلاش (Retry Budget) تعریف کنید تا از هزینههای گزاف پرسه زدن مدل جلوگیری شود.
اما داستان سختافزاری این تحول حتی شگفتانگیزتر است — به تحلیل ما درباره تراشههای Blackwell مراجعه کنید.



گفتگو