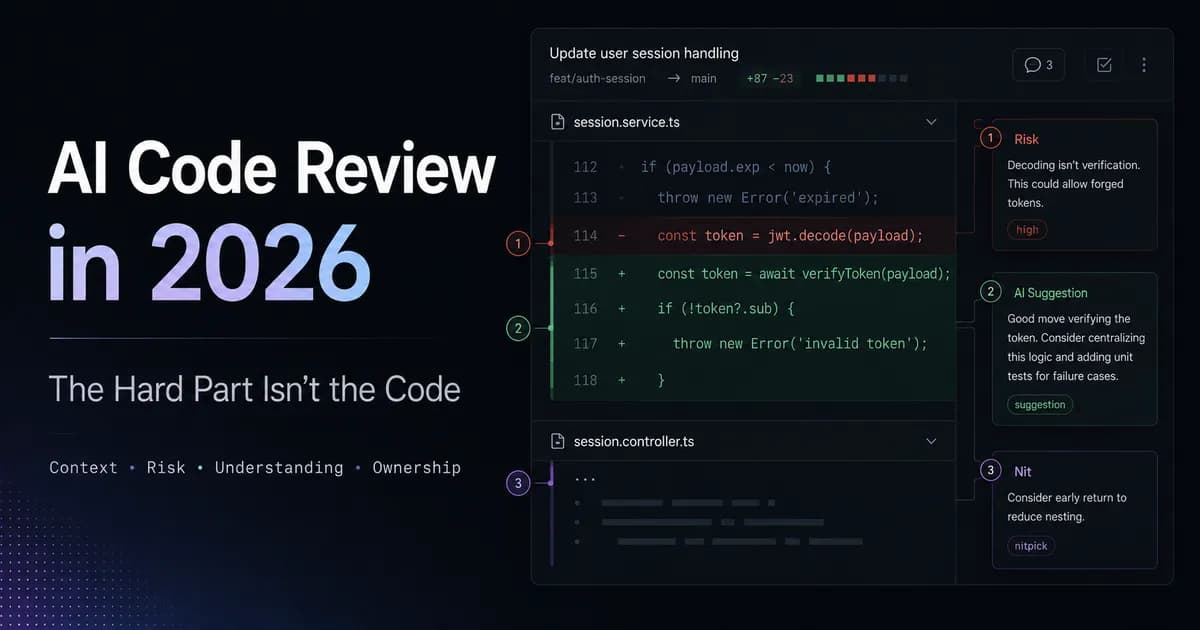
تصور کنید یک توسعهدهنده ارشد در سپتامبر ۲۰۲۶ با واقعیت عجیبی روبروست: نوشتن کد دیگر بخش گرانقیمت توسعه نرمافزار نیست. عاملهای کدنویسی (Coding Agents) اکنون میتوانند در عرض چند دقیقه مخازن کد را بررسی کنند، ویژگیهای جدید بسازند، تست بنویسند، آنها را اجرا کنند، خطاها را برطرف سازند و حتی درخواستهای ادغام (Pull Requests) را بازبینی کنند. تغییری که پیشتر ممکن بود ساعتها زمان ببرد، اکنون در دقایقی ظاهر میشود.
این سرعت خیرهکننده، شکافی خطرناک میان «پیادهسازی» و «درک» ایجاد کرده است. این تحول در حالی رخ میدهد که صنعت به سمت گردشکارهای کاملاً عاملمحور حرکت میکند. همانطور که در تحلیل قبلی ما دربارهی جایگزینی منتورینگ جونیورها با بازبینیهای هوش مصنوعی اشاره کردیم، تمرکز دیگر بر این نیست که یک خط کد را انسان نوشته، یا کوپایلت (Copilot)، کلود (Claude) یا عامل دیگری آن را تولید کرده است. خطر واقعی اکنون ماهیت «متقاعدکننده» کدهای تولیدشده توسط هوش مصنوعی است؛ کدهایی که اغلب حرفهای به نظر میرسند اما از نظر معماری کاملاً اشتباهاند.
تلهی کدهای متقاعدکننده
عاملهای هوش مصنوعی در تولید کدهایی که «درست به نظر میرسند» استادند. آنها از نامگذاریهای منطقی، فرمت تمیز و تایپینگ صحیح استفاده میکنند. حتی ممکن است تستهای لازم از پیش وجود داشته باشند. همین موضوع باعث میشود بازبین انسانی بهطور غافلگیرکنندهای سریع به کد اعتماد کند.
یک سناریو را در نظر بگیرید که در آن یک عامل، تابعی استاندارد برای دریافت کاربر (getUser) تولید میکند:
export async function getUser(id: string) {
  try {
    const response = await fetch(`/api/users/${id}`);
    if (!response.ok) {
      throw new Error("Failed to load user");
    }
    return response.json();
  } catch (error) {
    console.error(error);
    throw error;
  }
}
در حالت ایزوله، هیچ چیز بهطور واضح در این کد وحشتناک نیست و احتمالاً بهدرستی کار میکند. اما تصور کنید بقیه اپلیکیشن از یک الگوی متمرکز استفاده میکند:
import { apiClient } from "@/lib/api";
import { logger } from "@/lib/logger";
const user = await apiClient.get(`/users/${id}`);
با استفاده از نسخه سادهی fetch، هوش مصنوعی همین حالا یک الگوی HTTP دوم، یک استراتژی مدیریت خطای متفاوت و استفاده مستقیم از console.error را وارد پروژه کرده است. همچنین ممکن است احراز هویت، سیستمهای تلاش مجدد (Retries)، ردیابی (Tracing) یا سایر رفتارهایی که پیشتر در apiClient پیاده شده بودند را دور زده باشد. کد در ذات خود غلط نیست، اما برای آن مخزن کد خاص، اشتباه است.
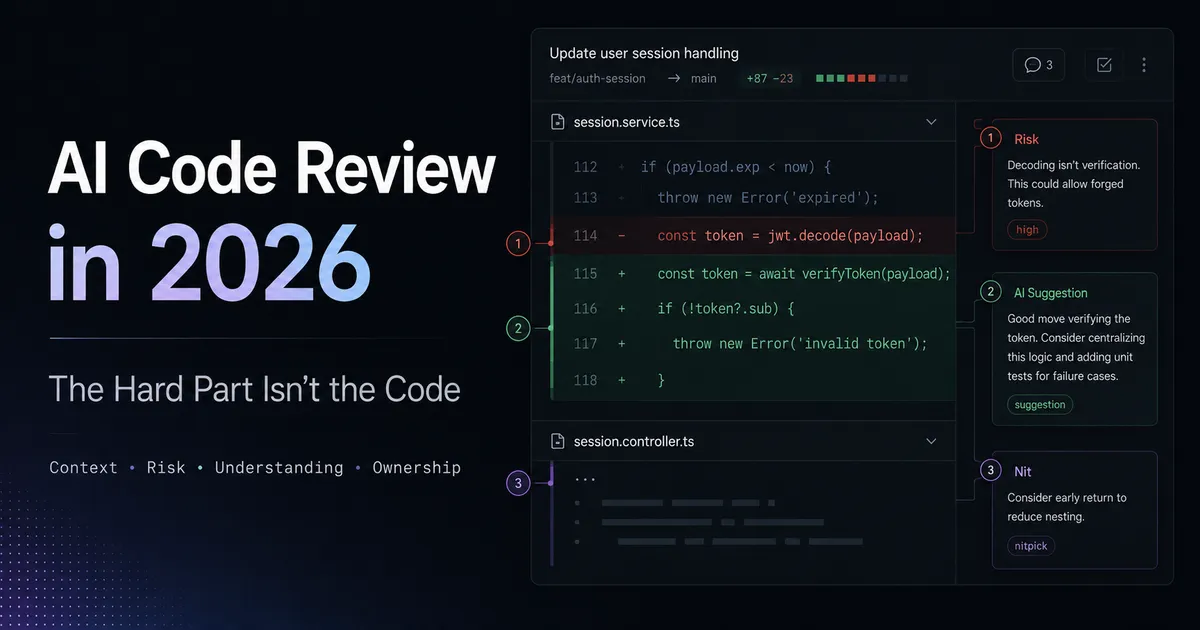
شکاف نیازمندیها
بازبینها متوجه شدهاند که عاملها دستورات را بهصورت تحتاللفه اجرا میکنند، حتی زمانی که آن دستورات ناقص باشند. واکنش طبیعی هنگام رسیدن یک Pull Request این است که بلافاصله فایلهای تغییریافته را باز کنیم، اما این کار اکنون یک اشتباه است. مهمتر این است که ابتدا درک کنیم این تغییر قرار بود چه هدفی را محقق کند.
برای مثال، اگر یک نیازمندی بگوید: «فقط کارکنان باید بتوانند ثبتنام کنند»، یک عامل ممکن است یک ابزار پیچیده برای اعتبارسنجی ایمیل بسازد که از دامنههای بینالمللی، آدرسهای دارای کوتیشن و لیست بلندی از موارد خاص RFC پشتیبانی کند.
در حالی که این کار از نظر فنی تحسینبرانگیز است، اما اغلب یک «بیشمهندسی» (Over-engineering) است. اگر قانون واقعی صرفاً این باشد که کارکنان از ایمیل شرکت استفاده کنند، یک بررسی ساده کفایت میکند:
const isEmployeeEmail = (email: string) => email.endsWith("@company.com");
خطر اینجاست که هوش مصنوعی تولید کد صیقلخورده حول یک فرض غلط تجاری را بسیار آسان کرده است. بازبینها اکنون باید بپرسند: آیا یک قانون تجاری مهم را نادیده گرفتیم؟ آیا مشکلی را حل کردیم که اصلاً وجود نداشت؟ آیا پیادهسازی، فرضاتی را در نظر گرفته که هرگز بخشی از درخواست نبودند؟
زمینه در برابر دانش دامنه
بازبینهای مدرن هوش مصنوعی در گشتوگذار در پروژههای موجود بهتر شدهاند. آنها میتوانند در مخزن جستجو کنند، فایلهای مجاور را بررسی کنند و از ابزارهای کمکی مجدد استفاده کنند. آنها از ابزارهای خاصی برای پر کردن این شکاف استفاده میکنند:
- MCP (Model Context Protocol): زمینههای خارجی را در اختیار عامل قرار میدهد.
- AGENTS.md: دستورالعملهای خاص هر مخزن را ارائه میدهد.
- Agent Skills: قابلیتهای تعریفشدهای که هوش مصنوعی باید دنبال کند.
با وجود این کمکها، «زمینه مخزن» با «دانش دامنه» یا «حافظه سازمانی» یکی نیست. یک مخزن کد همیشه داستان کامل را روایت نمیکند. برخی تصمیمات تنها زمانی معنا پیدا میکنند که تاریخچه محصول را بدانید:
- وضعیت سراسری (Global State): ممکن است اپلیکیشنی بهطور عمدی از آن دوری کند چون تیم ماهها وقت صرف حذف آن کرده است.
- منطق تلاش مجدد (Retry Logic): یک API Client ممکن است منطق عجیبی داشته باشد چون یک سرویس خارجی خاص غیرقابل اعتماد است.
- انتزاعهای عجیب (Awkward Abstractions): یک قطعه کد ممکن است عجیب به نظر برسد چون چندین تیم مختلف به آن وابسته هستند.
- فیلدهای منسوخ: فیلدی که بیاستفاده به نظر میرسد، ممکن است هنوز توسط یک کلاینت موبایل قدیمی مورد نیاز باشد.
یک عامل کد را میبیند اما تاریخچه را نه. هوش مصنوعی ناسازگاری معماری را اختراع نکرد؛ بلکه صرفاً ایجاد بیشترِ آن را سریعتر کرد. هنگام بازبینی، حیاتی است که به دنبال وابستگیهای جدید، ابزارهای تکراری یا انتزاعهایی باشید که با کدهای اطراف مطابقت ندارند.
توهم تستهای سبز
تستهای پاسشده دیگر سیگنال اطمینانی که سالها پیش داشتند را فراهم نمیکنند. چند سال پیش، پوشش تست خوب نشان میداد که نویسنده درباره رفتار کد فکر کرده است. امروز، هم پیادهسازی و هم تستها ممکن است توسط یک عامل واحد و از روی یک پرامپت واحد تولید شده باشند. این یعنی هر دو میتوانند دچار یک سوءتفاهم مشترک باشند.
یک نیازمندی را تصور کنید: «کاربر نمیتواند سفارش را پس از ارسال (Shipment) لغو کند».
پیادهسازی:
function canCancel(status: OrderStatus) {
  return status !== "delivered";
}
تستهای تولیدشده:
expect(canCancel("pending")).toBe(true);
expect(canCancel("delivered")).toBe(false);
همه چراغها سبز هستند. اما وضعیت «ارسالشده» (Shipped) همان وضعیت حیاتی بود. تستها ثابت میکنند که پیادهسازی طبق انتظارِ «خودِ پیادهسازی» رفتار میکند، نه اینکه با قانون تجاری مطابقت داشته باشد. بازبینها اکنون باید بررسی کنند که موارد تست از کجا آمدهاند و اطمینان حاصل کنند که منطق مهم از معیارهای پذیرش و قوانین دامنه مشتق شده است، نه از خودِ کد.
مناطق پرخطر
امنیت حوزهای است که بازبینهای انسانی باید در آن سرعت خود را بهشدت کم کنند. هوش مصنوعی پیادهسازیهای ناقص را متقاعدکننده جلوه میدهد. این نقطه اتصال (Endpoint) را در نظر بگیرید:
app.get("/users/:id", async (req, res) => {
  const user = await db.user.findUnique({
    where: { id: req.params.id },
  });
  res.json(user);
});
این کد ساده و خواناست. اما اگر وظیفه اصلی فقط «افزودن یک نقطه اتصال برای بازیابی کاربر» بوده باشد، عامل ممکن است بررسی حیاتی را حذف کند: آیا کاربر فعلی واقعاً اجازه دسترسی به آن رکورد را دارد؟
بازبینها باید زمان نامتناسبی (بیشتر از حد معمول) را صرف موارد زیر کنند:
- احراز هویت، مجوزها و دسترسیها (Authorization)
- کوئریهای پایگاهداده و مهاجرتها (Migrations)
- ورودیهای کاربر و دسترسی به فایلها
- پرداختها و دادههای شخصی
در حالی که تحلیلهای استاتیک و اسکنرهای امنیتی در خط لوله (Pipeline) برای شکار چیزهایی که انسانها از دست میدهند مفید هستند، اما آنها نمیتوانند هر قانون مجوز تجاری را استنباط کنند. گاهی اوقات محدودیتهای گمشده تنها زمانی آشکار میشوند که شما بدانید محصول قرار است چگونه رفتار کند.
تغییر معیار بازبینی
حجم کد تولیدشده توسط هوش مصنوعی دیگر سیگنال مفیدی برای تعیین عمق بازبینی نیست. یک عامل میتواند صدها خط تکراری را بدون تغییر ریسک زیاد بازنویسی (Refactor) کند. در مقابل، یک تغییر ۱۰ خطی در احراز هویت، پرداختها، مجوزهای IAM یا یک مهاجرت پایگاهداده میتواند بسیار مهمتر باشد.
اتوماسیون باید لایه اول را مدیریت کند. Linters، بررسیکنندههای تایپ و بازبینهای AI میتوانند مشکلات قطعی را بگیرند، منطقهای مشکوک را علامتگذاری کنند و دستورالعملهای مخزن را دنبال کنند. این کار انسانها را آزاد میکند تا سوالات سختتر را بپرسند:
- آیا این تغییر منطقی است؟
- آیا با معماری سازگار است؟
- وقتی شکست بخورد چه اتفاقی میافتد؟
- آیا ریسک جدیدی را وارد میکنیم؟
- آیا تیم در آینده در نگهداری این کد راحت خواهد بود؟
مدل مسئولیتپذیری
با وجود اتوماسیون، توسعهدهندهای که درخواست ادغام (PR) را ارسال میکند، همچنان مالک نتیجه است. اگر توسعهدهندهای کدی را ارسال کند که توسط یک عامل تولید شده، باید بتواند توضیح دهد که تغییر چه کاری انجام میدهد، چرا این رویکرد انتخاب شده، چه فرضاتی در نظر گرفته شده و ریسکها کجا هستند. استفاده از هوش مصنوعی، مسئولیت را از دوش توسعهدهنده برنمیدارد.
این عنصر انسانی حیاتی است. مطالعهای در سال ۲۰۲۶ روی ۱.۰۲ میلیون درخواست ادغام در ۲۰۷ پروژه گیتهاب نشان داد که برخی الگوهای بازبینی با حضور عاملها با تصمیمگیریهای سریعتر همراه بودهاند، اما این افزایش بهرهوری به بهبود کیفیت بازبینی تبدیل نشده است.
«چرا» در مهندسی
بسیاری از موثرترین کامنتهای بازبینی اکنون سوالات سادهای هستند: چرا به این انتزاع نیاز داریم؟ آیا جای دیگری این را حل کردهایم؟ اگر این فراخوانی شکست بخورد چه میشود؟ چرا این وابستگی جدید را اضافه میکنیم؟ آیا این واقعاً با نیازمندی مطابقت دارد؟ آیا میتوانست سادهتر باشد؟
اینها «سوالات هوش مصنوعی» نیستند؛ بلکه سوالات عادی مهندسی هستند. توسعهدهندگان مدتها پیش از کوپایلت هم دچار بیشمهندسی میشدند و موارد خاص (Edge Cases) را نادیده میگرفتند. تنها تفاوت این است که عاملها اکنون این اشتباهات را با سرعت بسیار بیشتری تولید میکنند، در حالی که آنها را در کدهایی با ظاهر مناسب میبندند.
خلاصه گردشکار جدید بازبینی
بازبینی کدهای کمکگرفته از هوش مصنوعی، کمتر درباره اثبات این است که کد در حالت ایزوله کار میکند و بیشتر درباره اطمینان از این است که تیم، تغییری را که قرار است مالک آن باشد، درک میکند. این فرآیند اکنون از یک رویکرد مبتنی بر ریسک پیروی میکند:
- اعتبارسنجی مسئله: آیا PR مسئله درست را حل میکند؟ آیا مشکلی را حل کردیم که اصلاً وجود نداشت؟
- تحلیل تناسب: پیادهسازی تا چه حد با مخزن کد موجود سازگار است؟ آیا روش دومی را برای حل یک مشکل شناختهشده معرفی میکند؟
- ارزیابی ریسک: آیا این یک تغییر CSS است (توجه کم) یا یک قانون احراز هویت (توجه زیاد)؟
- تاییدیه: آیا تستها بازتابدهنده نیازمندی هستند یا فقط بازتابی از پیادهسازیاند؟
پیادهسازی اکنون ارزان است. تولید نسخهها، نوشتن تستهای پایه و بازنویسی ارزان است. اما درک دامنه، شناسایی اینکه کدام موارد خاص اهمیت دارند و ایجاد توازنهای معماری (Trade-offs) ارزان نیست. اینجاست که ارزش توسعهدهنده ارشد در عصر جدید نهفته است.
نوبت شماست
کنجکاوم بدانم این موضوع برای سایر تیمها چگونه تغییر کرده است. وقتی امروز کدهای کمکگرفته از AI را بازبینی میکنید، چه چیزهایی را با دقت بیشتری نسبت به چند سال پیش بررسی میکنید؟ و چه چیزهایی را دیگر صرفاً به دلیل سبز بودن CI قبول نمیکنید؟ مشتاقم بشنوم که عادتهای بازبینی شما چگونه تغییر کرده است.
اما داستان سختافزاری این تحول حتی شگفتانگیزتر است — به تحلیل ما دربارهی تراشههای Blackwell مراجعه کنید.



گفتگو