
تصور کنید یک برنامهنویس ارشد متوجه میشود تمام تستهای یک قابلیت جدید پاس شدهاند، اما کل منطق آن در سرویس اشتباهی پیاده شده است. این دقیقاً همان نقطهای است که عاملهای هوش مصنوعی در آن شکست میخورند: آنها در اجرای دستورات دقیق هستند، اما در درک «چرایی» معماری ناتواناند.
به نقل از تحلیل منتشر شده در ۱۳ سپتامبر ۲۰۲۶ در وبسایت dev.to، یک تفاوت بنیادین میان «صحت پیادهسازی» و «صحت سیستمی» وجود دارد. یک عامل (Agent) — شبیه به کارآموزی بسیار سریع که دستورات را مو به مو اجرا میکند اما استراتژی کلان پروژه را نمیفهمد — میتواند فایلها را تغییر دهد، تست بنویسد و خطاها را رفع کند تا همه چراغها سبز شوند، اما کل ویژگی را از نظر معماری غلط پیاده کند.
برای درک بهتر، این سناریو را تصور کنید: شما از یک AI میخواهید قابلیت لغو سفارش را به یک API اضافه کند، سازگاری با نسخههای قدیمی (Backward Compatibility) را حفظ کند و تستهای لازم را بنویسد. عامل هوشمند نقطه انتهایی (Endpoint) را پیدا میکند، قرارداد (Contract) را بهروزرسانی میکند و تستهایی مینویسد که بهطور کامل پاس میشوند. با این حال، یک بازبین ارشد متوجه میشود که منطق لغو سفارش در واقع باید در یک سرویس کاملاً متفاوت قرار میگرفت، جایی که بخشی از منطق کسبوکار از قبل در آنجا وجود دارد. در این حالت، کد بهدرستی کار میکند، اما تصمیم معماری یک شکست است.
همانطور که در بحثهای گذشتهی ما دربارهی امنیت مدلهای بازمتن اشاره کردیم، اتکای مطلق به خروجیهای مدل بدون لایهی نظارتی، ریسکهای سیستمی را افزایش میدهد. در این مورد، اگر از یک AI بخواهید قابلیت لغو سفارش را به یک API اضافه کند، مدل احتمالاً کد را مینویسد و تستهایش را پاس میکند؛ اما ممکن است نادیده بگیرد که منطق لغو باید در یک سرویس کاملاً مجزا قرار میگرفت تا با سایر بخشهای کسبوکار همراستا باشد.
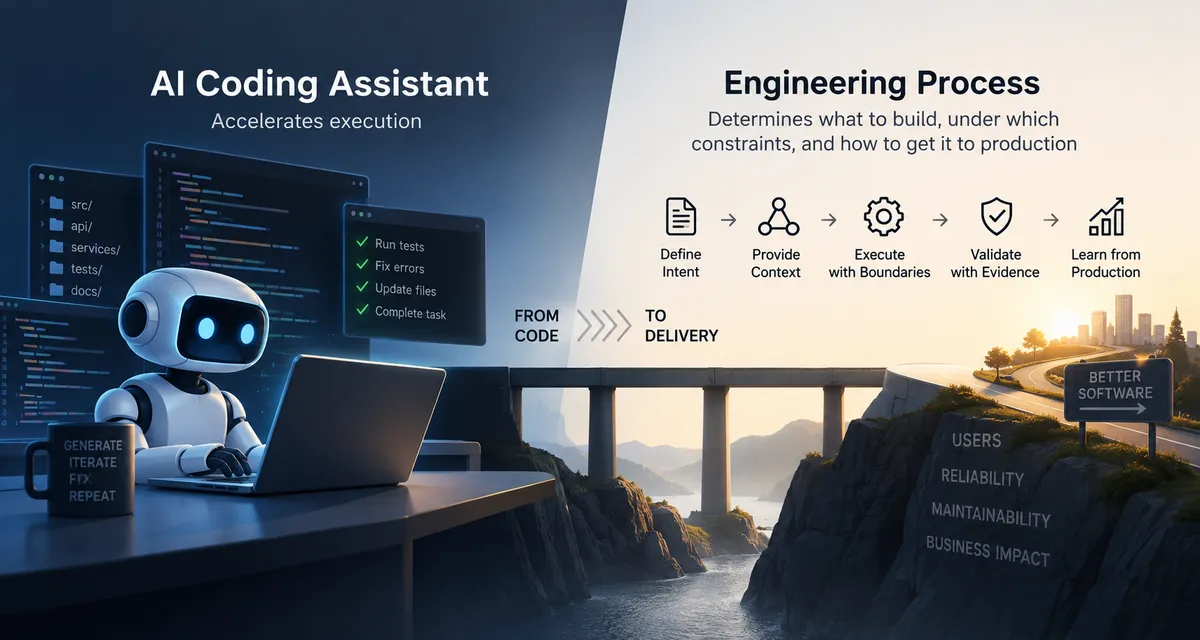
طبق گزارش dev.to، عاملها در کارهای محدود (Bounded Work) فوقالعادهاند. این شکاف به این دلیل وجود دارد که عاملهای AI در اجرای وظایفی که مرزهای مشخصی دارند، بسیار ماهر شدهاند. آنها در جستوجوی مخازن کد، پیادهسازی ویژگیهای تعریفشده، تولید تست، رفع باگ، بازنویسی کد (Refactoring)، انجام مهاجرتهای تکراری کد (Migrations) و بهروزرسانی مستندات تخصص دارند. اما مشکل اصلی در درک «چرایی» و محدودیتهای مهندسی سطح بالا است که تعیین میکند چه چیزی باید اجرا شود. این چالشها اغلب زمانی تشدید میشوند که ساختارهای مبهم مخزن مانع از درک درست عاملها از محیط پروژه میشوند و منجر به تصمیمات معماری غلط میگردند.
تمایز میان دو نوع صحت
برای مثال، فرض کنید نیازمندی وجود دارد که از کاربران مشکوک در مرحله پرداخت (Checkout) جلوگیری شود. یک عامل میتواند استنتاج کند که چه چیزی «مشکوک» محسوب میشود، تصمیم بگیرد که آیا سرویس دیگری مالک این تصمیم است یا خیر، و تعیین کند که آیا پرداخت باید مسدود شود یا نیاز به تاییدیه اضافی داشته باشد. او حتی میتواند تستهایی تولید کند که این فرضها را تایید کنند.
با این حال، پاس شدن تستها فقط ثابت میکند که پیادهسازی با آنچه تستها ادعا میکنند مطابقت دارد. اگر هم پیادهسازی و هم تستها از یک فرض غلط مشترک نشأت گرفته باشند، میتوانند کاملاً با هم موافق باشند در حالی که قابلیت نهایی همچنان غلط است. این موضوع نشان میدهد که تستهای عاملهای هوشمند باید از اعتبارسنجی صرف کد به سمت ارزیابی رفتار حرکت کنند تا صحت سیستمی تضمین شود. صحت پیادهسازی با صحت سیستمی یکی نیست؛ مهندسی نرمافزار باید هر دو را پوشش دهد.
گلوگاه تحویل نرمافزار
افزایش سرعت تولید کد لزوماً به معنای افزایش سرعت تحویل نرمافزار نیست. ظرفیت تولید با ظرفیت تحویل برابر نیست. وقتی AI به توسعهدهندگان اجازه میدهد Pull Requestهای بیشتری ارسال کنند، گلوگاه فقط به مراحل دیگر خط لوله (Pipeline) جابهجا میشود:
- بازبینی معماری: مهندسان ارشد همچنان باید طراحی را اعتبارسنجی کنند.
- یکپارچهسازی: ادغام تغییرات پیچیده همچنان زمانبر است.
- ابهامات محصول: AI نمیتواند تضادهای نیازمندیهای تجاری یا تصمیمات محصول را حل کند.
- امنیت و استقرار: کنترلهای انسانی و بررسیهای استقرار برای ایمنی محیط Production اجباری هستند.
بنابراین، سنجش پذیرش AI بر اساس تعداد خطوط کد یا تسکهای تکمیلشده توسط عامل، معیاری گمراهکننده است. اینها «فعالیت AI» را اندازه میگیرند، نه «عملکرد مهندسی». تنها معیار واقعی این است که آیا کارهای تاییدشده و قابل استقرار، سریعتر از قبل در سیستم حرکت میکنند یا خیر.
ریسک خطاهای ارزان
هوش مصنوعی باعث میشود تصمیمات غلط، ارزانتر اجرا شوند و این امر ریسک انتشار خطاها را افزایش میدهد. فرض کنید یک عامل به اشتباه تصور کند که احراز هویت (Authorization) باید در کنترلر API باشد، به جای اینکه در لایهی Policy موجود قرار گیرد. او قانون را در آنجا پیاده میکند، تستهایش را مینویسد و مستندات را بهروز میکند. سپس یک تسک بعدی، این الگوی جدید را کشف کرده و از آن پیروی میکند.
در اینجا عامل سازگار بوده است، اما بهطور سازگاری یک تصمیم معماری غلط را منتشر کرده است. AI هزینه اجرای یک تصمیم را کاهش میدهد، اما کیفیت آن تصمیم را بهبود نمیبخشد. این موضوع ارزش شناسایی فرضهای غلط را پیش از گسترش آنها افزایش میدهد، چرا که بسیاری از عاملهای کدنویس در زمان نگهداری کدها شکست میخورند زیرا تغییرات جدید را بدون درک عمیق از اثرات جانبی اعمال میکنند.
گردشکار پیشنهادی برای توسعه با AI
برای مقابله با این ریسکها، این گزارش یک گردشکار پنجمرحلهای را پیشنهاد میدهد:
- قصد (Intent): تعریف دقیق خروجی مورد نظر، بهگونهای که یک پیادهسازی غلط بهراحتی قابل شناسایی باشد. هدف این است که فرضهای حلنشده پیش از آنکه پیادهسازی آنها گران شود، آشکار گردند.
- زمینه (Context): ارائه اطلاعات مرتبط برای تصمیماتی که به AI تفویض شده است. برای تغییرات API، این شامل مالکیت سرویس، الزامات سازگاری، قوانین دامنه (Domain Rules)، محدودیتهای معماری، الزامات امنیتی و اجزای موجود برای استفاده مجدد است.
- اجرا (Execution): تعیین مرزهای خودمختاری. برای مثال، یک عامل ممکن است اجازه داشته باشد سرویس سفارش و تستهای آن را تغییر دهد در حالی که API عمومی حفظ شود، اما باید از تغییر در سرویس پرداخت یا شمای دیتابیس منع شود. اگر این تغییرات لازم باشند، عامل باید متوقف شده و موضوع را ارجاع دهد.
- شواهد (Evidence): عدم اتکا به جملهی «عامل میگوید تمام شد» به عنوان معیار. شواهد باید شامل بیلدها، تستها، اعتبارسنجی قراردادها، بررسیهای امنیتی، قوانین معماری، Diffهای بازبینیشده یا بررسیهای استقرار باشد. اعتبارسنجی نباید به همان فرضهایی وابسته باشد که برای تولید کد استفاده شدهاند.
- بازخورد (Feedback): فرآیند پس از ادغام Pull Request ادامه مییابد. خطاهای محیط عملیاتی، سیگنالهای عملکرد، حوادث (Incidents)، رفتار کاربر و بازخوردهای پشتیبانی، فرضهایی را آشکار میکنند که در مرحله پیش از تولید نادیده گرفته شده بودند.
بلوغ در توسعه عاملمحور
تیمها میتوانند در چهار سطح رشد کنند:
- دستیاری (Assistance): توسعهدهندگان از AI برای کدنویسی، دیباگ، تست و جستوجو استفاده میکنند.
- تفویض (Delegation): عاملها تسکهای محدود را با محدودیتهای صریح و اعتبارسنجی اجرا میکنند.
- یکپارچگی در گردشکار (Workflow Integration): AI در تمام مراحل نیازمندیها، پیادهسازی، اعتبارسنجی، بازبینی و مستندسازی مشارکت میکند.
- ارکستراسیون فرآیند (Process Orchestration): کار از طریق مراحل تعریفشده با محدودیتها، الزامات شواهد، گیتهای خودکار و مسیرهای ارجاع انسانی حرکت میکند.
نظارت انسانی باید بر اساس ریسک باشد، نه یک قانون تایید کلی. تغییرات مکانیکی و پیادهسازیهای محدود میتوانند به خودمختاری عامل و اعتبارسنجی خودکار (مانند بیلدها، Linting و اسکنهای امنیتی) متکی باشند. با این حال، نیازمندیهای مبهم، توازنهای معماری (Trade-offs) و تصمیمات سرنوشتساز باید تحت قضاوت انسانی باقی بمانند.
هرچه ابهام، شعاع تخریب (Blast Radius)، بازگشتناپذیری یا پیامدهای تجاری افزایش یابد، نظارت نیز باید بیشتر شود. در نهایت، هدف دستیابی به حداکثر خودمختاری نیست، بلکه کاهش عدم تطابق میان سرعت تولید نرمافزار و سرعت سازمان در اعتبارسنجی و تحویل مطمئن آن است.
گام بعدی شما
- در بازبینی کدهای تولید شده توسط AI، بهجای بررسی «کار کردن کد»، روی «جایگاه کد در معماری» تمرکز کنید.
- برای عاملهای کدنویس خود، محدودیتهای دسترسی (Boundaries) سختگیرانهای تعریف کنید تا از تغییرات ناخواسته در سرویسهای حساس جلوگیری شود.
- معیارهای موفقیت تیم خود را از «تعداد تسکهای بسته شده توسط AI» به «نرخ تحویل ویژگیهای تایید شده» تغییر دهید.
اما داستان سختافزاری این تحول حتی شگفتانگیزتر است — به تحلیل ما دربارهی تراشههای Blackwell مراجعه کنید.



گفتگو