اگر امروز برای تولید ویدیوهای هوش مصنوعی زمان میگذارید، احتمالاً ساعتها از بهرهوری شما در حفرههای «هزینههای کور» و پراکندگی ابزارها گم میشود. در حالی که اکثر کاربران روی این موضوع وسواس دارند که یک کلیپ در چند ثانیه رندر شود، هزینه واقعی در کل چرخه است: تعداد دفعات تلاش ضربدر مجموع زمان انتظار، بازبینی و جابهجایی بین نرمافزارها.
این واقعیت زمانی آشکار میشود که سازندگان از مرحله آزمایشهای ساده به سمت تولید داراییهای استاندارد صنعتی حرکت میکنند. برای کسانی که ویدیوهای تبلیغاتی برای فروشندگان کوچک یا قابلیتهایی مثل «تبدیل عکس به انیمیشن» در اپلیکیشنهای اجتماعی میسازند، گلوگاه اصلی سرعت واحد پردازش گرافیکی (GPU) — که مثل موتور یک ماشین است و سرعت پردازش داده را تعیین میکند — نیست، بلکه اصطکاک در فرآیند خلاقانه است. طبق گزارشی که در ۲۱ سپتامبر ۲۰۲۶ در dev.to منتشر شد، اتلاف وقت واقعی در «مسیرهای انحرافی» بین ایده و رندر نهایی رخ میدهد.
همانطور که در تحلیلهای قبلی ما دربارهی بهینهسازی گردشکار در مدلهای مولد اشاره کردیم، ابزارهایی که کاربر را مجبور به خروج از محیط کاری میکنند، عملاً سرعت مدل را خنثی میکنند. در واقع، مدیریت هوشمندانه این مسیرها میتواند مشابه برخی گردشکارهای بهینهشده در برنامهنویسی باشد که زمان قابلتوجهی را برای متخصصان بازمیگرداند.
چهار عامل تعیینکننده در زمان تولید
همه ویدیوهای هوش مصنوعی یکسان ساخته نمیشوند. هر عددی که در اینترنت درباره سرعت میبینید صرفاً یک حدس است، زیرا زمان انتظار برای هر کلیپ به چهار متغیر اصلی بستگی دارد:
- مدل: معماریهای مختلف، توازن متفاوتی بین سرعت و کیفیت بصری ایجاد میکنند.
- مشخصات کلیپ: مدتزمان بیشتر و رزولوشن بالاتر به معنای محاسبات بیشتر در هر بار تولید است.
- تنظیمات کیفیت: اجرای یک نسخه پیشنویس (Draft) با نسخه نهایی متفاوت است؛ پیشنویسها بهشدت سریعتر هستند.
- صف انتظار: بار سرور در لحظه ارسال، حتی برای تنظیمات یکسان، باعث نوسانات پیشبینیناپذیر میشود.
به همین دلیل، تنها پاسخ صادقانه به سؤال «چقدر زمان میبرد؟»، اندازهگیری دقیق روی پشتهی ابزارهای (Stack) شخصی شماست.
هزینههای پنهان در تولید
کاهش چند ثانیه از زمان رندر بیفایده است اگر بقیه خط لوله (Pipeline) خراب باشد. بیشترین اتلاف وقت در «چرخه» رخ میدهد، نه در خودِ تولید. رایجترین نقاط اتلاف وقت عبارتاند از:
- تلاشهای تلفشده: زمانی که بابت نسبت ابعاد اشتباه، عکسهای ورودی بیکیفیت یا انتخاب مدلی که توانایی اجرای آن نمای خاص را ندارد، از دست میرود.
- اصطکاک جابهجایی: چرخه ویرایش در یک ابزار، بزرگنمایی (Upscaling) — که مثل زوم کردن روی یک عکس تار برای شفاف کردن آن است — در ابزاری دیگر و متحرکسازی در ابزار سوم. هر جابهجایی مستلزم دانلود، تغییر نام و آپلود مجدد فایلهاست.
- هزینهکرد کور: تردیدی که در هر بار تلاش مجدد ایجاد میشود، زیرا هزینه اعتبار (Credit) تا پایان عملیات مشخص نمیشود.
- فقدان سوابق: ناتوانی در تشخیص اینکه کدام مدل یا تنظیمات برای نماهای خاص سریعتر یا مؤثرتر بوده است.
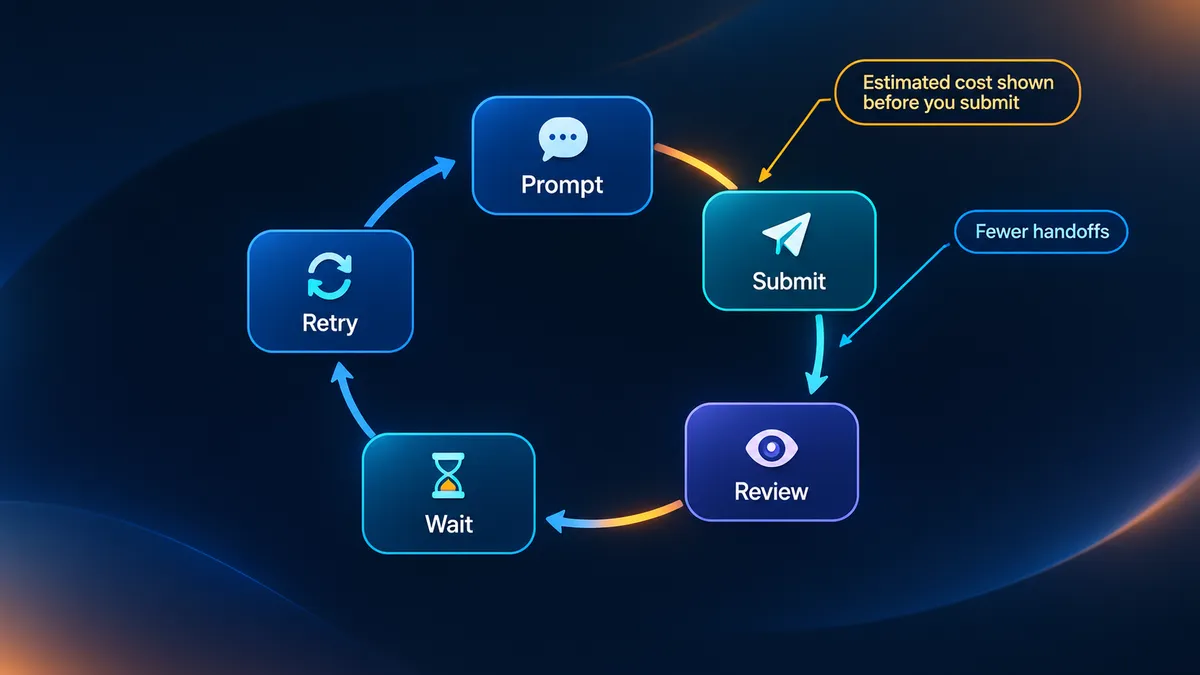
بهینهسازی چرخه با VOKOO
برای مقابله با این ناکارآمدیها، نویسنده پلتفرم VOKOO را آزمایش کرد؛ محیطی چندمدلی که برای به حداقل رساندن جابهجایی بین ابزارها طراحی شده است. این پلتفرم با شعار «بیشتر بساز، کمتر جابهشو»، سعی میکند با ادغام چندین مرحله در یک فضای کاری، چرخه را کوتاه کند.
در این گردشکار، کاربر بهجای پریدن بین تبهای مختلف مرورگر، یک تصویر ثابت تولید کرده و مستقیماً آن را به بخش متحرکسازی میبرد. این چرخه تبدیل تصویر به ویدیو (Image-to-Video) نیاز به آپلود مجدد داراییها را حذف میکند و سریعترین راه برای متحرک کردن یک عکس است. علاوه بر این، عامل (Agent) — شبیه به یک دستیار هوشمند که میداند کدام ابزار را در چه زمانی اجرا کند — به کاربران اجازه میدهد بدون بازسازی کل گردشکار، مدلهای مختلف را امتحان کنند. کاربران میتوانند یک پرامپت واحد را در مدلهای مختلف اجرا کرده و نتایج را با زمان واقعی هر کدام مقایسه کنند.
ویژگی حیاتی دیگر، پیشنمایش هزینه است. با انتخاب کیفیت و مشخصات تولید در هر مرحله و مشاهده هزینه تخمینی پیش از ارسال، سازندگان میتوانند ابتدا پیشنویسهای کمکیفیت بسازند و فقط نسخه نهایی را با کیفیت کامل رندر کنند. این کار باعث کاهش اعتبارهای تلفشده و زمان تنظیمات میشود و در نهایت منجر به خروجی خلاقانه بیشتری میگردد.
اندازهگیری پشته ابزارهای شخصی
از آنجا که پشته ابزارهای هر کاربر متفاوت است، تنها راه صادقانه برای سنجش عملکرد، ثبت شخصی دادههاست. نویسنده استفاده از دو اسکریپت ساده را برای ردیابی میانگین انتظار هر مدل و زمان کل هر نما پیشنهاد میکند.
یک اسکریپت Bash به نام vtimer.sh زمان شروع و پایان هر اجرا را ثبت میکند. این اسکریپت با یک ساختار دستوری ساده عمل میکند: برای شروع از دستور ./vtimer.sh start <shot> <model> <spec> و برای پایان از دستور ./vtimer.sh stop استفاده میشود. این ابزار تمام دادهها را در یک فایل به نام runs.csv ذخیره میکند.
سپس یک اسکریپت پایتون (summarize.py) میانگین انتظار هر مدل/مشخصات و زمان کل هر نما را محاسبه میکند. این دادهها یک تمایز حیاتی را آشکار میکنند: میانگین انتظار پاسخ میدهد که مدل چقدر سریع است، اما زمان کل هر نما (با احتساب تمام تلاشهای ناموفق) پیشبینی میکند که بعدازظهر شما واقعاً چگونه سپری میشود و زمانتان کجا گم میشود.
کاهش زمان و صورتحساب
برای به حداکثر رساندن بهرهوری، هدف باید انجام «ارزانترین تلاش ممکن» باشد؛ یعنی تلاشی که اصلاً مجبور به انجامش نباشید. این هدف از طریق روشهای زیر محقق میشود:
- تثبیت فریم اول: کنترل تصویر شروع برای جلوگیری از تکرار کل فرآیند از ابتدا.
- جداسازی متغیرها: در هر اجرا فقط یک متغیر را تغییر دهید تا رویکرد علمی حفظ شود و بدانید چه چیزی باعث تغییر نتیجه شده است.
- نگهداری گزارش: استفاده از دادههای زمانی برای توقف تکرار آزمایشهای شکستخورده.
- بهبود پرامپتها: استفاده از یک مدل زبانی بزرگ (LLM) — مثل کتابخانهداری که میلیاردها صفحه را خوانده و حالا با همان لحن جواب میدهد — برای پیشنویس کردن پرامپتها پیش از ارسال نهایی. برای کسانی که به یک درگاه API سازگار با OpenAI و مقرونبهصرفه نیاز دارند که مدلهای متعددی را پشتیبانی کند، RouteAI تنظیمات سادهای را برای اصلاح پرامپتها پیش از ارسال به تولیدکننده ویدیو فراهم میکند.
تحلیل تحریریه
این تغییر دیدگاه، تولید ویدیو با هوش مصنوعی را از یک «ذهنیت قرعهکشی» به یک «ذهنیت مهندسی» تبدیل میکند. برای یک سازنده معمولی، نکته کلیدی این است که یکپارچهسازی ابزارها بسیار ارزشمندتر از افزایش ۱۰ درصدی در سرعت خام تولید است. وقتی شما «اصطکاک جابهجایی» — یعنی انتقال دستی فایلها بین یک تولیدکننده تصویر، یک تولیدکننده ویدیو و یک ابزار بزرگنمایی — را حذف میکنید، پراکنده ترین بخشهای روز خود را پس میگیرید.
برای صنعت گستردهتر هوش مصنوعی، این موضوع نشاندهنده تقاضای فزاینده برای «فضاهای کاری» (Workspaces) به جای «ابزارها» (Tools) است. ارزش دیگر در خودِ مدل نیست، بلکه در سازماندهی چندین مدل در یک محیط واحد و با هزینهای شفاف است. برنده در فضای ویدیوهای هوش مصنوعی لزوماً کسی نخواهد بود که سریعترین مدل را دارد، بلکه کسی است که کوتاهترین چرخه تولید را ایجاد کند.
اگر میخواهید خروجی خود را بهینه کنید، امروز یک تست ۲۰ دقیقهای انجام دهید. اسکریپتها را ذخیره کنید، یک نما را روی دو مدل مختلف اجرا کنید و میانگین زمان انتظار را مقایسه کنید. اگر به دنبال یک تولیدکننده ویدیو هستید که فرآیند ساخت را ساده نگه دارد و در عین حال فضای کافی برای کاوش فراهم کند، VOKOO را در آدرس https://vokoo.ai امتحان کنید.
گام بعدی شما
- یک تست ۲۰ دقیقهای انجام دهید: دو مدل مختلف را برای یک نمای یکسان امتحان کنید و زمان کل (نه فقط رندر) را مقایسه کنید.
- اسکریپتهای ثبت زمان را در گردشکار خود بگنجانید تا متوجه شوید کدام مدل در عمل (نه در بنچمارک) برای شما سریعتر است.
- از مدلهای زبانی برای پالایش پرامپتها استفاده کنید تا تعداد دفعات رندرهای ناموفق کاهش یابد.
اما داستان سختافزاری این تحول حتی شگفتانگیزتر است — به تحلیل ما دربارهی تراشههای Blackwell مراجعه کنید.



گفتگو