
اگر امروز یک عامل هوشمند را برای تحلیل دادههای مالی شرکتتان به کار بگیرید، احتمالاً با نتایجی مواجه میشوید که از نظر فنی درست اما از نظر تجاری کاملاً غلط هستند. مشکل اینجاست که دادههای شما برای ماشین خواندنیاند، اما برای هوش مصنوعی «فهمشدنی» نیستند. در حالی که یک طرحواره (Schema) پایگاه داده به هوش مصنوعی میگوید چه چیزهایی وجود دارند، اما نمیتواند توضیح دهد که دادهها در واقع چه معنایی دارند، چگونه باید به هم متصل شوند یا در چه زمانی باید از آنها اجتناب کرد.
برای دههها، پایگاههای داده سازمانی اساساً برای توسعهدهندگان، مهندسان داده و تحلیلگران طراحی شدهاند. این طراحی به این دلیل کار میکرد که انسانها بستر معنایی (Context) گمشده را تأمین میکردند. یک تحلیلگر خبره میداند که ستون invoice_amount با درآمد شناسشده (Recognized Revenue) یکی نیست. یک مهندس داده میداند که دو جدول نباید مستقیماً به هم متصل (Join) شوند، حتی اگر شناسههای آنها سازگار به نظر برسند. یک تیم مالی میداند که created_at یک برچسب زمانی عملیاتی است، در حالی که گزارشهای مالی باید از settlement_date استفاده کنند. هیچکدام از این دانشها برای اینکه انسانها بهطور مؤثر کار کنند، نیازی به وجود داشتن در طرحواره فیزیکی نداشت.
به نقل از راهنمای فنی منتشر شده در dev.to در ۲۴ اوت ۲۰۲۶، تکیه بر شهود انسانی، دلیل اصلی شکست عاملهای داده در محیطهای عملیاتی است. عاملهای هوشمند این فرض را تغییر میدهند. اگر قرار است یک عامل مستقیماً دادههای سازمانی را استعلام کند، مدل داده باید بسیار بیشتر از انواع ستونهای جدول را منتقل کند.
بسیاری از پیادهسازیهای فعلی هوش مصنوعی بر بازیابی ساده طرحواره یا جاسازیها (Embeddings) تکیه دارند. با این حال، شکاف میان یک نام ستون فنی و یک معیار تجاری، جایی است که اکثر خطاها رخ میدهند. یک هوش مصنوعی ممکن است ستونی به نام total_amount را ببیند و فرض کند که نشاندهنده درآمد است، بدون اینکه بداند این مقدار شامل مالیات است یا سفارشات لغو شده را در بر میگیرد. پرسش مهندسی واقعی این است: یک سیستم هوش مصنوعی پیش از آنکه دادههای سازمانی بهطور قابلاطمینانی قابل استفاده شوند، به چه اطلاعاتی نیاز دارد؟ این چالشها بخشی از مسائل گستردهتری است که در ۱۵ قانون مهندسی برای تبدیل عاملهای هوش مصنوعی به ابزارهای قابلاعتماد مورد بررسی قرار گرفته است تا دقت عملیاتی این سیستمها افزایش یابد.
چارچوب دادههای خواندنی برای AI
برای پر کردن این شکاف، مدل پیشنهادی «دادههای خواندنی برای AI» را مجموعهای از «معنا + ساختار + روابط + قوانین استفاده + اعتماد» تعریف میکند. این رویکرد فراتر از متادیتای ساده است که اغلب اطلاعاتی ارائه میدهند که از نظر فنی دقیق اما از نظر تحلیلی بیفایده هستند.
یک طرحواره استاندارد برای جدول sales_order را در نظر بگیرید که شامل order_id (BIGINT)، customer_id (BIGINT)، total_amount (DECIMAL)، created_at (TIMESTAMP) و status (VARCHAR) است. یک مدل میتواند این را تجزیه کند و بفهمد که total_amount عددی است. اما همچنان نمیداند که آیا سفارشات لغو شده گنجانده شدهاند، آیا این مبلغ ارزش سفارش است یا درآمد شناسشده، یا اینکه customer_id چگونه در سیستمهای CRM و ERP نگاشت میشود.
افزودن توصیفات — مانند برچسب زدن به total_amount به عنوان «مبلغ کل سفارش فروش» — متادیتای مفیدی است، اما مشکل استدلال را حل نمیکند. یک توصیف دقیق فنی همچنان نمیتواند به مدل بگوید که چه زمانی این ستون برای یک پرسش تجاری خاص معتبر است.
معنا باید صریح باشد. فرض کنید یک انبار داده شامل چهار فیلد مختلف است: sales_order.total_amount ، invoice.invoice_amount ، finance_revenue.recognized_amount و payment.received_amount. هر چهار مورد ممکن است از طریق شباهت برداری برای کلمه «درآمد» بازیابی شوند. برای حل این مشکل، سیستم باید یک «شیء معیار حاکمیتی» (Governed Metric Object) را بازیابی کند:
- شناسه معیار (Metric ID): revenue
- نام: Revenue
- نسخه: 2.1
- تعریف: اصطلاح تجاری «درآمد شناسشده»
- تجمیع (Aggregation): SUM
- منبع: جدول
finance_revenue، ستونrecognized_amount - زمان: فیلد
recognition_date
این تغییر، مسئله را از «مدل باید کدام فیلد شبیه به درآمد را انتخاب کند؟» به «تعریف حاکمیتی درآمد را بازیابی کن» تبدیل میکند.
روابط به عنوان بستر درجه اول
روابط نیز به بستر درجه اول نیاز دارند. حتی تعاریف معنایی کامل برای تحلیلهای چندجدولی کافی نیستند. اگر کاربری بپرسد «کدام مشتریان صورتحسابهای پرداختنشده دارند؟»، سیستم ممکن است نیاز داشته باشد مسیری را از مشتری $ \rightarrow $ سفارش $ \rightarrow $ صورتحساب $ \rightarrow $ پرداخت طی کند.
طرحوارههای واقعی سازمانی اغلب فاقد کلیدهای خارجی کامل هستند. یک رابطه ممکن است صرفاً به این دلیل وجود داشته باشد که order.customer_id و customer.customer_id مقادیر مشترکی دارند. این چارچوب یک خط لوله کشف پیشنهاد میکند که در آن روابط از حالتهای مختلف عبور میکنند: کشف $ \rightarrow $ کاندید $ \rightarrow $ اعتبارسنجی $ \rightarrow $ اعتماد.
یکی از مکانیزمهای خاص برای کشف این پیوندها، «نسبت شمول» (Inclusion Ratio) است که به صورت زیر محاسبه میشود:
Inclusion(A → B) = |distinct(A) ∩ distinct(B)| / |distinct(A)|
در اینجا A برابر با order.customer_id و B برابر با customer.customer_id است. اگر نسبت شمول بالا باشد و B دارای منحصربهفرد بودن (Uniqueness) بالایی باشد، سیستم شواهدی از یک رابطه مرجع دارد. کشف رابطه، ترکیبی از محدودیتهای پایگاه داده، نام ستونها، شمول مقادیر، منحصربهفرد بودن و اعتبارسنجی تجاری است. در زمان استعلام، هوش مصنوعی باید این روابط مورد اعتماد را ترجیح دهد به جای اینکه Joinها را از ابتدا بازسازی کند.
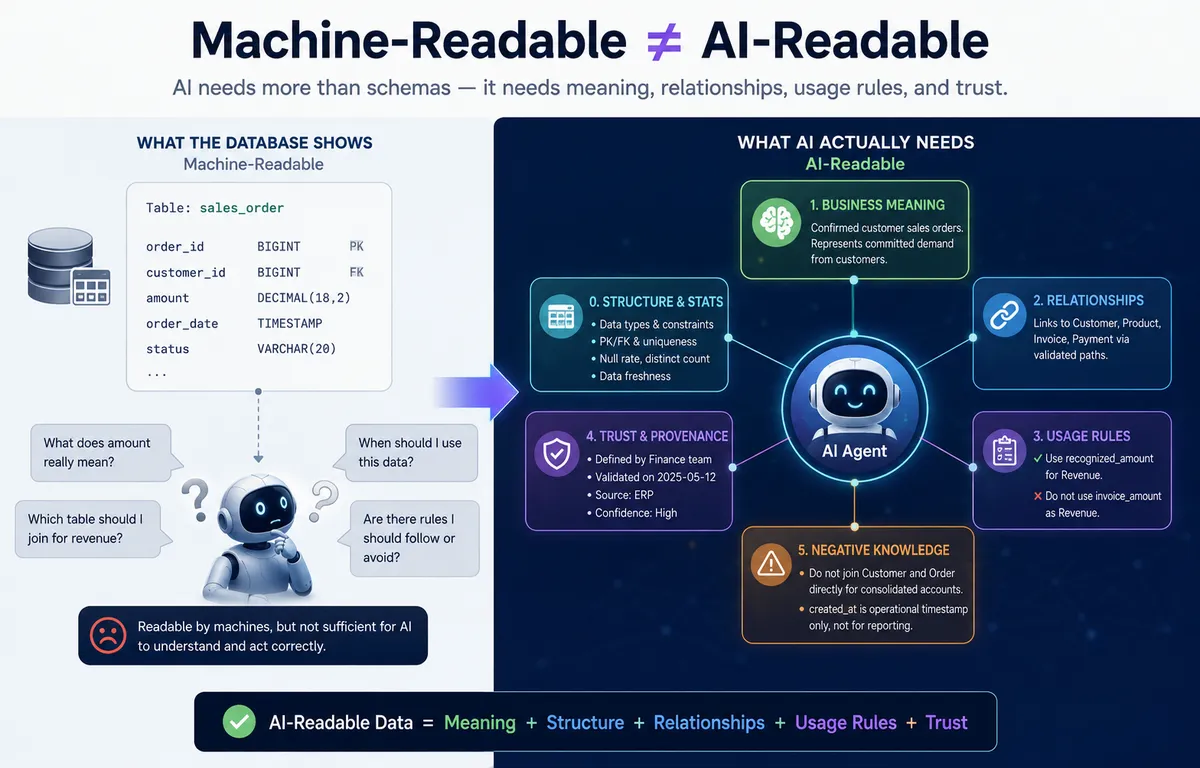
قدرت دانش منفی
شاید حیاتیترین تغییر، معرفی «دانش منفی» باشد. اکثر سیستمهای معنایی در نمایش دانش مثبت خوب هستند (مثلاً «درآمد از recognized_amount استفاده میکند»). با این حال، سیستمهای در سطح تولید باید صراحتاً به هوش مصنوعی بگویند از چه چیزی استفاده نکند.
انسانها مدام از این دانش استفاده میکنند و جملاتی میگویند مانند «از آن جدول برای امور مالی استفاده نکن» یا «آن فیلد شبیه customer_id است، اما در واقع account_id است». برای هوش مصنوعی، این باید ساختاریافته باشد. برای مثال، یک شیء فیلد باید مشخص کند:
- معتبر برای (Valid For): order_value, sales_volume
- نامعتبر برای (Invalid For): recognized_revenue, cash_collection
این کار مانع از آن میشود که هوش مصنوعی یک تطبیق برداری با شباهت بالا را انتخاب کند که از نظر تجاری نادرست است. تصور کنید یک جستجوی برداری برای «درآمد مشتری» نتایج زیر را برگرداند: sales_order.total_amount (امتیاز ۰.۹۱)، invoice.invoice_amount (امتیاز ۰.۸۹) و finance_revenue.recognized_amount (امتیاز ۰.۸۷). یک خط لوله ساده، بالاترین امتیاز را انتخاب میکند. اما اگر بستر حاکمیتی، sales_order.total_amount را به عنوان invalid_for: recognized_revenue علامتگذاری کرده باشد، سیستم میتواند آن را جریمه یا حذف کند.
این امر منطق بازیابی را از شباهت معنایی ساده به یک فرمول وزنی تغییر میدهد:
score = candidate.semantic_similarity + AUTHORITY_BONUS (if authoritative) - INVALID_USAGE_PENALTY (if invalid)
بازیابی به ترکیبی از شباهت + اعتبار تجاری + اعتماد + محدودیتهای استفاده تبدیل میشود.
قوانین استفاده و سیگنالهای اعتماد
قوانین استفاده باید به جای متن آزاد، ماشینخوان باشند. یک یادداشت قابل خواندن برای انسان که میگوید «این جدول عموماً برای گزارش سفارشات استفاده میشود و معمولاً نباید برای گزارش درآمد مالی به کار رود» بسیار کمتر از قوانین ساختاریافته مؤثر است:
- جدول:
sales_order - معتبر برای: order_analysis, sales_pipeline
- نامعتبر برای: recognized_revenue, financial_close
- فیلد زمانی ترجیحی:
created_at(برای order_analysis) - محدودیتها: exclude_cancelled_orders
علاوه بر این، سیگنالهای اعتماد تداخلات بستر را حل میکنند. سیستمهای سازمانی اغلب نسخههای متعددی از یک معیار (مثلاً درآمد v1.8، v2.0، v2.1) یا چندین مسیر کاندید (مشتری $ \rightarrow $ سفارش در مقابل مشتری $ \rightarrow $ حساب $ \rightarrow $ سفارش) دارند. یک بستر خواندنی برای AI به سیگنالهایی برای انتخاب گزینه صحیح نیاز دارد:
- وضعیت معیار: active
- مالک: finance
- تاریخ اجرا: 2026-01-01
- اعتبارسنج شده: true
- اطمینان به رابطه: 0.97 (تأیید شده توسط data_governance)
پیادهسازی لایه اشیاء داده
به جای گنجاندن این قوانین در پرامپت سیستمی مدل — که دانش را به یک عامل خاص گره میزند — این چارچوب یک لایه داده مستقل از مدل را پیشنهاد میکند. قرار دادن قوانینی مانند «اگر کاربر درآمد را خواست، از جدول X استفاده کن» در پرامپت در ابتدا جواب میدهد، اما دانش با یک پیادهسازی خاص جفت میشود.
یک معماری بهتر، دانش دادههای سازمانی را خارج از مدل نگه میدارد: عامل AI $ \rightarrow $ حلکننده بستر (Context Resolver) $ \rightarrow $ لایه دادههای خواندنی $ \rightarrow $ دادههای سازمانی. این امر اجازه میدهد عاملهای مختلف (فروش، مالی، تحلیل، عملیات) از همان دانش استفاده کنند. مدل میتواند تغییر کند بدون اینکه درک سازمان از دادهها نیاز به بازسازی داشته باشد.
یک شیء داده خواندنی برای AI برای یک فیلد واحد شامل موارد زیر خواهد بود:
- معنا: اصطلاح تجاری (مثلاً ارزش سفارش) و توصیف.
- ساختار: قابلیت تهی بودن (Nullability) و نسبت مقادیر متمایز (مثلاً ۰.۸۴).
- روابط: اهداف مورد اعتماد (مثلاً
customer.customer_id) و وضعیت. - استفاده: موارد استفاده صریح
valid_forوinvalid_for. - اعتماد: مالک (مثلاً عملیات فروش)، وضعیت و پرچم اعتبارسنجی.
این معماری به یک «حلکننده بستر» اجازه میدهد تا یک نمایش فشرده و آماده برای دستورالعمل برای LLM بسازد. وقتی کاربر «درآمد شناسشده به تفکیک مشتری برای سه ماهه گذشته» را میخواهد، حلکننده معیار (Revenue v2.1)، بُعد (Customer)، رابطه مورد اعتماد، فیلد زمانی (recognition_date) و کاندیدهای حذف شده (sales_order.total_amount) را شناسایی میکند. LLM دیگر نیازی به استنتاج مدل از یک طرحواره خام ندارد.
فراتر از RAG استاندارد
این چیزی بیشتر از یک خط لوله RAG استاندارد است. یک خط لوله استاندارد چنین است: پرسش $ \rightarrow $ جاسازی $ \rightarrow $ بازیابی بستر $ \rightarrow $ LLM. یک لایه دادههای خواندنی برای AI گامهای اضافی حیاتی را معرفی میکند:
- حل مفاهیم تجاری
- بازیابی اشیاء داده مرتبط
- اعمال محدودیتهای استفاده
- ترجیح تعاریف مورد اعتماد
- حل روابط
- ساخت بستر استعلام
- LLM
هدف صرفاً یافتن بستر نیست، بلکه یافتن بستری است که برای آن وظیفه تحلیلی خاص معتبر باشد.
چرخه حیات و معماری
بستر خواندنی برای AI نمیتواند ایستا باشد. با تغییر طرحوارهها، معیارها و قوانین استفاده، سیستم به یک چرخه حیات نیاز دارد: کشف $ \rightarrow $ اعتبارسنجی $ \rightarrow $ انتشار $ \rightarrow $ نظارت $ \rightarrow $ تشخیص تغییر $ \rightarrow $ بهروزرسانی. اگر Revenue v2.1 به v2.2 تبدیل شود، نسخه قدیمی باید حفظ شود تا استعلامات تاریخی قابل بازتولید باشند.
یک معماری کاربردی، دادههای خام سازمانی را از بستری که AI میتواند استفاده کند از طریق یک خط لوله جدا میکند: استخراج متادیتا $ \rightarrow $ کشف رابطه $ \rightarrow $ حاکمیت معنایی/معیار $ \rightarrow $ قوانین استفاده و دانش منفی $ \rightarrow $ اشیاء داده خواندنی برای AI $ \rightarrow $ حلکننده بستر $ \rightarrow $ عامل AI.
اندازهگیری آمادگی AI
برای حرکت از موفقیتهای اتفاقی به دقت مهندسی، این راهنما پنج معیار کلیدی برای تیمهای داده پیشنهاد میکند:
- پوشش معنایی (Semantic Coverage): درصد جداول/فیلدهای مهمی که به مفاهیم تجاری نگاشت شدهاند.
- پوشش روابط (Relationship Coverage): درصد مسیرهای چندجدولی پرکاربرد که به عنوان روابط اعتبارسنج شده نمایش داده شدهاند.
- پوشش قوانین استفاده (Usage Rule Coverage): درصد اشیاء داده با ارزش بالا که دارای استفادههای معتبر/نامعتبر صریح هستند.
- نرخ حل بستر مورد اعتماد (Trusted Context Resolution Rate): درصد استعلاماتی که در آنها معیار + منابع + روابط بدون استنتاج آزاد LLM حل شدهاند.
- نرخ برخورد با محدودیت منفی (Negative Constraint Hit Rate): چند بار کاندیدهای نامعتبر به دلیل محدودیتهای صریح استفاده حذف شدهاند.
این رویکرد آمادگی دادهها را بازتعریف میکند. آمادگی سنتی میپرسید آیا دادهها در دسترس، پاک، یکپارچه و مستند هستند. هوش مصنوعی یک الزام قویتر اضافه میکند: آیا یک AI میتواند تعیین کند که دادهها چه معنایی دارند، چگونه متصل میشوند، چه زمانی معتبرند، چه زمانی نامعتبرند و چرا باید به آنها اعتماد کرد؟
این تغییر نشان میدهد که تفاوت بین یک دموی جذاب و یک عامل عملیاتی، داشتن یک LLM بهتر نیست، بلکه رسمی کردن دانشی است که انسانها سالها در ذهن خود پنهان کردهاند. برای پیادهسازی این موضوع، مهندسان داده باید با بررسی رایجترین استعلامات «اشتباه» AI خود شروع کنند تا نقاطی را که دانش منفی در آنها مفقود است، شناسایی کنند.
گام بعدی شما
- لیست رایجترین استعلامات غلط عاملهای AI خود را استخراج کنید تا نقاط فقدان «دانش منفی» بیابید.
- برای معیارهای کلیدی سازمان، «اشیاء معیار حاکمیتی» (Governed Metric Objects) تعریف کنید و آنها را از متادیتای ساده جدا کنید.
- یک لایه Context Resolver بین مدل و پایگاهداده قرار دهید تا منطق تجاری از پرامپتها خارج شود.
اما داستان سختافزاری این تحول حتی شگفتانگیزتر است — به تحلیل ما دربارهی تراشههای Blackwell مراجعه کنید.



گفتگو