
تصور کنید یک دستیار هوشمند با اطمینان کامل به مهندسی دستور میدهد سروری را تعمیر کند که یک ماه پیش حذف شده است. این یک نقص ساده نیست، بلکه یک شکاف طراحی است؛ برای حل این مشکل، وینایاک سونتالیا (Vinayak Sonthalia)، دانشجوی سال آخر مهندسی، Lethe را ساخت؛ موتور حافظهای که برای «فراموش کردن هدفمند» طراحی شده است.
به نقل از مستندات پروژه، سونتالیا این سیستم را تنها در یک هفته و برای هکاتون WeMakeDevs × Cognee توسعه داد تا مشکل توهمات ناشی از دادههای قدیمی را حل کند.
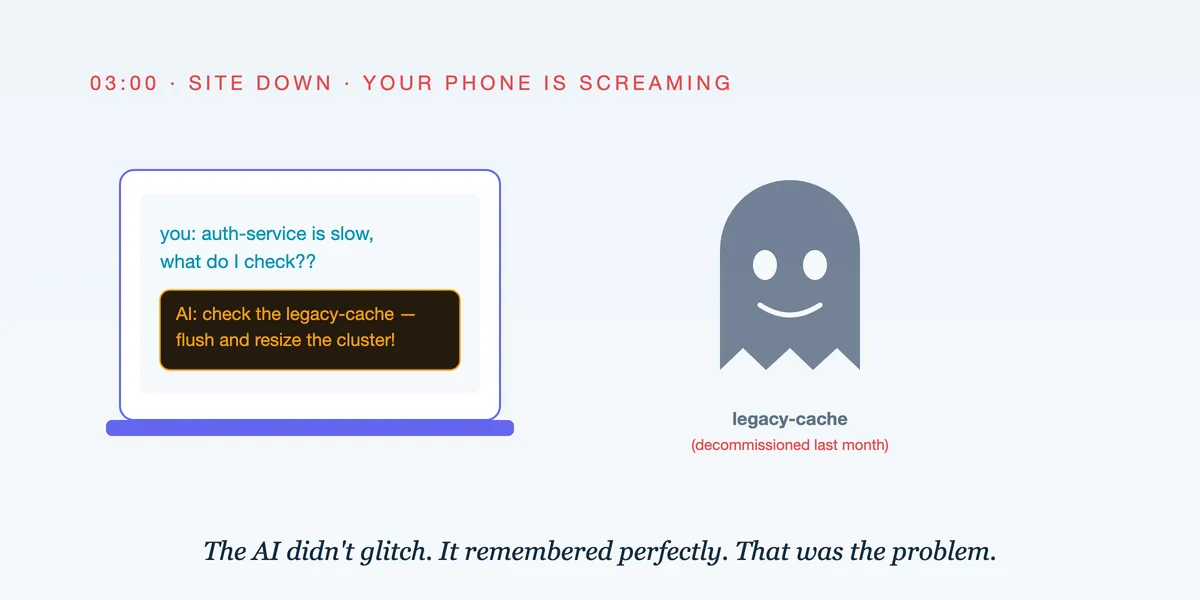
معمای ساعت ۳ صبح
ایده Lethe از یک شکست واقعی در ساخت دستیار مدیریت حوادث شکل گرفت. این ابزار قرار بود دستورالعملهای فنی (Runbooks) را بخواند و هنگام قطعی سرویس، راهنماییهای دقیق ارائه دهد. اما در زمان تست، دستیار به توسعهدهنده دستور داد: «کش قدیمی (legacy-cache) را بررسی، تخلیه و خوشه را تغییر اندازه بده!» در حالی که آن کش یک ماه پیش خاموش شده بود. طبق گزارش توسعهدهنده، هوش مصنوعی دچار نقص فنی نشده بود؛ بلکه دقیقاً همان کاری را میکرد که برایش ساخته بود: «به خاطر آوردن». مشکل این بود که مدل چیزی را به خاطر سپرد که دیگر حقیقت نداشت.
اکثر معماریهای فعلی حافظه در هوش مصنوعی به دنبال گسترش هستند و تصور میکنند هرچه اسناد بیشتر و تاریخچه طولانیتر باشد، عملکرد بهتر میشود. اما در دنیای واقعی، حقایق تاریخ مصرف دارند. سرورها بازنشسته میشوند و راهکارهای فنی سال گذشته، به دلیل تغییرات، دلیل قطعیهای امروز میگردند. یک حافظه بزرگ بدون قابلیت پاکسازی، فقط راههای بیشتری برای «اشتباه کردن با اطمینان» فراهم میکند. این وضعیت شبیه لیست مخاطبین گوشی است؛ اگر فقط شماره اضافه کنید و هرگز شمارهای را پاک نکنید، روزی با شمارهای قدیمی تماس میگیرید و شخصی غریبه پاسخ میدهد.
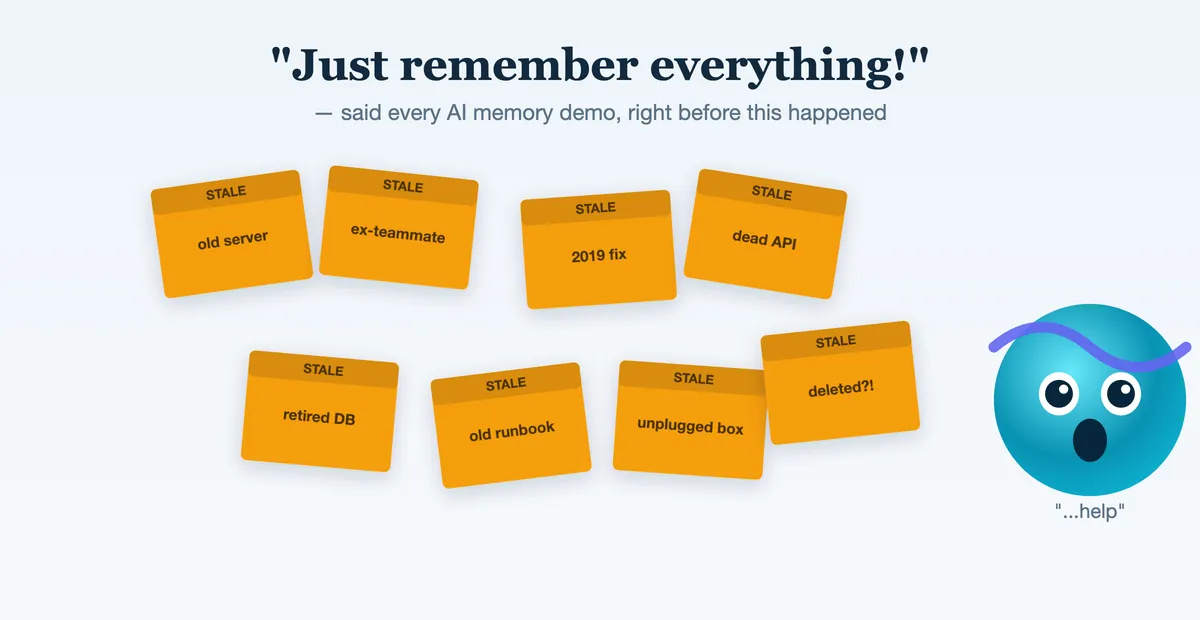
Lethe که نامش را از رودخانه فراموشی در اساطیر یونان گرفته، حافظه را نه یک آرشیو دائمی، بلکه یک «وضعیت پویا» میبیند. همانطور که در تحلیلهای پیشین ما درباره امنیت و مدیریت دادههای مدلهای زبانی اشاره کردیم، چالش اصلی اکنون دیگر «مقدار یادآوری» نیست، بلکه این است که «مدل چطور یاد بگیرد چیزهایی را که دیگر درست نیستند، فراموش کند». این چالش در مدیریت حافظه، یادآور تلاشهای متDif-فاوتی مانند متد تکفایلی Dory برای جلوگیری از گم شدن بافتار (Context) در جلسات چت است که سعی دارد نظم ساختاری را در مواجهه با مدلها برقرار کند.
معماری فنی
این سیستم با استفاده از موتور حافظه بازمتن Cognee ساخته شده و دستورالعملهای فنی را بدون نیاز به برچسب یا طرحواره، به صورت متن ساده پردازش میکند. با یک فراخوانی ساده از تابع cognify()، دو مخزن همزمان ساخته میشود:
- گراف دانش (Knowledge Graph) — شبیه یک نقشه مفهومی که روابط بین اشیا را ترسیم میکند — که توسط Kùzu مدیریت میشود.
- اندیس برداری (Vector Index) — که مثل یک سیستم بایگانی بر اساس شباهت معنایی عمل میکند — و از LanceDB استفاده میکند.
وقتی کاربر سوالی میپرسد، جستوجوی برداری محتوای مرتبط را مییابد، گراف دانش بستر ارتباطی را اضافه میکند و مدل پاسخی شبیه به یک دستورالعمل فنی تولید میکند که هر ادعای آن به منبعش ارجاع داده شده است.
سازوکار فراموشی
وقتی یک سیستم بازنشسته میشود، تابع forget() یک «حذف سخت» (Hard Delete) واقعی اجرا میکند. این یک فیلتر ساده نیست، بلکه حذف کامل موارد زیر است:
- فایلهای خام
- گرهها و یالهای گراف
- بردار معنایی (Embedding) — که مثل یک کارت معرفی عددی برای هر واژه است و میگوید این کلمه «همسایه» چه کلمات دیگری است.
بر اساس مستندات توسعهدهنده، یک پرسوجوی مجدد پس از حذف، اثر این متد را ثابت میکند. قبل از حذف، مدل «کش قدیمی» را پیشنهاد میداد؛ اما پس از دستور forget()، مدل پاسخ جدیدی میدهد (مثلاً بررسی اتصال pool در session-store) و صراحتاً اعتراف میکند که «کش قدیمی» در اسناد موجود نیست، به جای اینکه پاسخی ساختگی ابداع کند.
برای جلوگیری از حذف تصادفی، Lethe از رویکرد سه لایه استفاده میکند:
- حذف سخت: حذف کامل تمام نقاط داده پس از تایید انسانی.
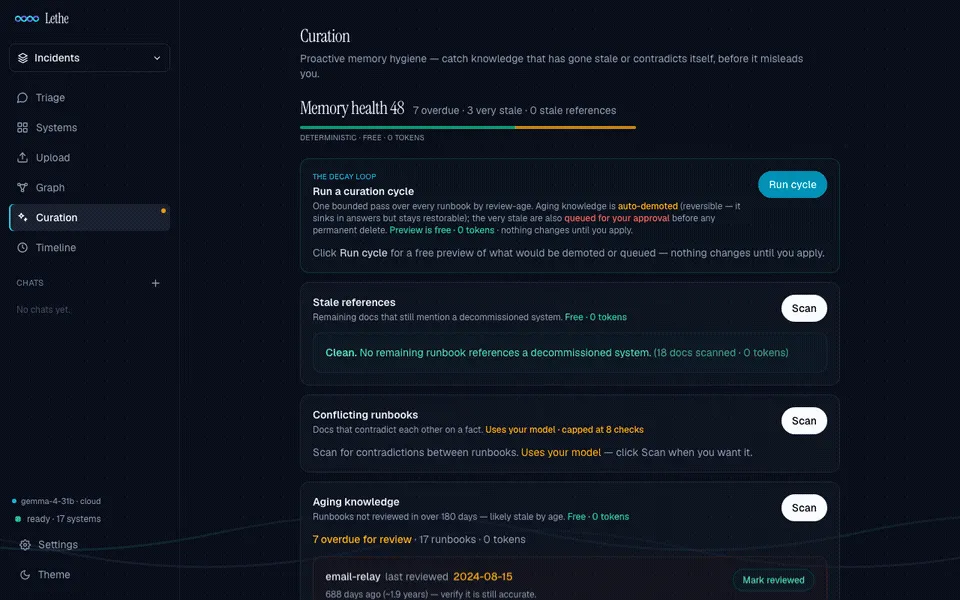
- حلقه پاکسازی (Curation Loop): مکانیزمی که سلامت حافظه را میسنجد و وزن اسناد قدیمی را به صورت بازگشتپذیر کاهش میدهد.
- حضور انسان در چرخه (Human-in-the-loop): الزام به اینکه هیچ دادهای بدون تایید یک شخص بهطور دائمی پاک نشود.
محکها و «دموی تسخیرشده»
سونتالیا در جریان تست، Lethe را در برابر روشهای استاندارد تولید بازیابیافزا (RAG) — که مثل دانشآموزی است که قبل از جواب دادن، اول کتاب درسی را باز میکند و از آن نقل میآورد — قرار داد. او متوجه شد اولین محکش اشتباه بود چون فقط نبودِ کلمه فراموششده را میسنجید. در نسخه دوم، یک «داور کور» از خانوادهای متفاوت از مدلها، صحت کلی پاسخ را ارزیابی کرد. در حالی که Lethe در استدلالهای چندمرحلهای با RAG برابر بود، اما در قابلیت «فراموش کردن موثر»، برتری قاطعی یافت که ساختارهای استاندارد RAG اساساً قادر به تکرار آن نیستند.
به نظر میرسد دقت در مدیریت خروجیهای مدل، مشابه پروژه Loupe در شناسایی باگهای خاموشی است که در کدهای تولید شده توسط AI وجود دارند و نشان میدهد که تکیه محض بر پاسخهای مدل بدون لایههای نظارتی، مخاطرهآمیز است.
او همچنین با یک باگ عجیب مواجه شد که دموی او گاهی بهجای جمله کامل، فقط یک کلمه («legacy-cache») برمیگرداند. بررسیها نشان داد خطی در پرامپت پیشفرض وجود دارد: «تا حد ممکن کوتاه پاسخ بده». این دستور باعث شده بود مدل پاسخهای پیچیده را به یک کلمه کاهش دهد. یک پرامپت سفارشی ساده، سه باگ مجزا را همزمان حل کرد و ثابت کرد که دستور نهایی، قدرتمندترین اهرم در خط لوله مدل زبانی بزرگ (LLM) است.
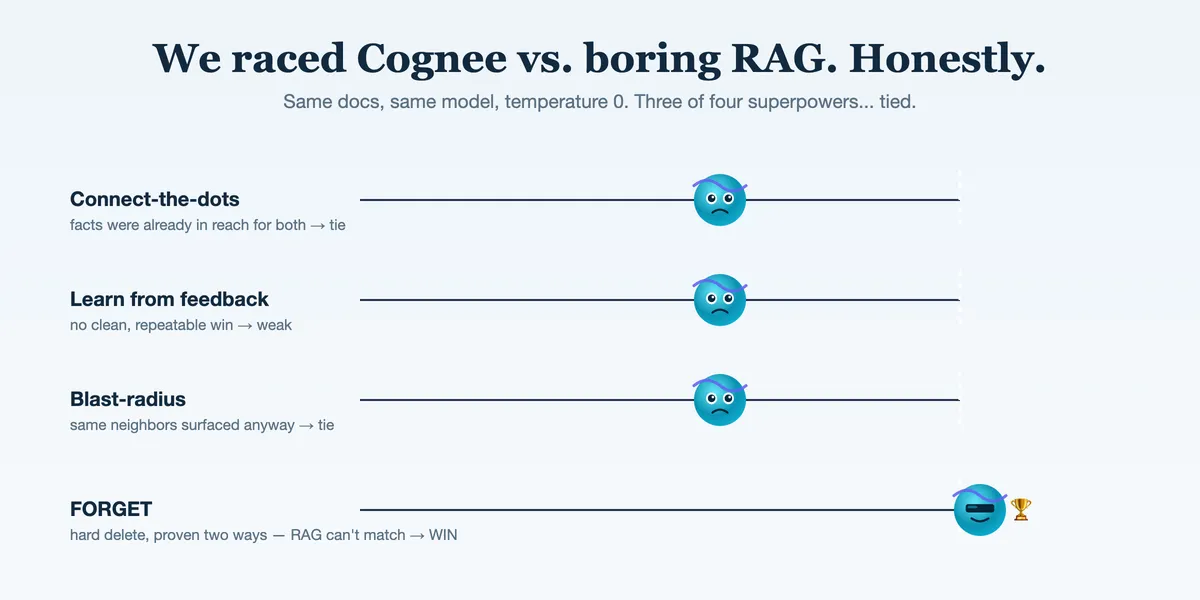
این تغییر رویکرد نشان میدهد مرز بعدی برای عاملهای قابلاعتماد، نه اندازه پنجره متنی (Context Window) — که مثل میز کاری است که جا برای چند ورق دارد، نه کل کتابخانه — بلکه دقت «کلید حذف» است. اگر مستندات فنی شما بهسرعت تغییر میکنند، اولویت باید از «چقدر میتواند به یاد آورد» به «چقدر سریع میتواند چیزهای غلط را فراموش کند» تغییر کند.
گام بعدی شما
- اگر از RAG برای مستندات شرکتی استفاده میکنید، استراتژی حذف دادههای منسوخ را به جای بهروزرسانی ساده بررسی کنید.
- پیادهسازی زنده پروژه را در vinayaksonthalia-lethe.hf.space تست کنید.
- دمو ۲ دقیقهای پروژه را در youtu.be/3840gxTZWxY مشاهده نمایید.
اما داستان سختافزاری این تحول حتی شگفتانگیزتر است؛ به تحلیل ما درباره تأثیر حافظههای سریع بر استنتاج مدلها مراجعه کنید.



گفتگو