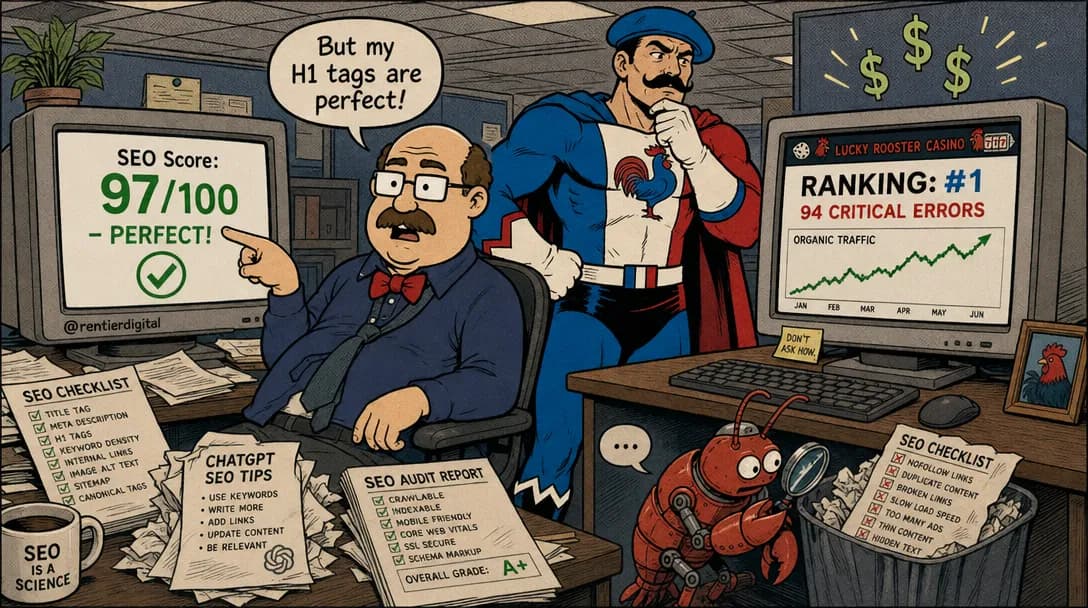
تصور کنید سایتی با ۹۴ خطای فنی بحرانی، همچنان برای گرانترین کلمات کلیدی اینترنت در رتبه ۱ گوگل باشد. این واقعیت، شکاف ساختاری عجیبی را در نحوه آموزش بهینهسازی موتورهای جستوجو (SEO) توسط ChatGPT، Claude و Perplexity فاش میکند.
در یک تجمع اخیر توسعهدهندگان، برنامهنویسی با افتخار میگفت سئوی سایتش «تمام شده است» چون تمام تگهای H1 و H2 او توسط هوش مصنوعی بهینه شده و امتیاز ابزارهای تحلیل او ۹۷ است. اما سایت رتبه ۱ برای همان کلمه کلیدی اصلی او، از سال ۲۰۲۲ در آن جایگاه بود؛ در حالی که تمام خطاهای بحرانی را داشت که ابزار آن برنامهنویس هشدار میداد: تگهای H1 تکراری، تصاویری بدون متن جایگزین (alt text) و سرعت بارگذاریای که حتی برای استانداردهای نصب وردپرس در سال ۲۰۰۹ هم شرمآور بود. با این حال، این سایت تکان نخورده بود و جایگاهش را حفظ کرده بود.
اکثر توصیههای مبتنی بر هوش مصنوعی بر بهداشت فنی تمرکز دارند؛ مواردی مثل تگهای H1، متن جایگزین تصاویر و سرعت بارگذاری صفحات. اینها در حقیقت «جزوه مدرس» سئو هستند. اما طبق گزارشی که در ۲۱ ژوئن ۲۰۲۶ در وبسایت dev.to منتشر شد، موفقترین سایتها در حوزههای محدودشده (Restricted Verticals)، اغلب این چکلیستها را بهطور کامل نادیده میگیرند و در عین حال سالانه دهها میلیون دلار درآمد کسب میکنند.
همانطور که در تحلیلهای پیشین ما درباره نحوه بهینهسازی توسعهدهندگان برای هزینه و بهرهوری — مانند یافتن جایگزینهایی برای OpenRouter جهت کاهش مخارج — اشاره کردیم، کسبوکارها اکنون میفهمند که انطباق فنی با قوانین، به معنای دیده شدن ارگانیک نیست. در دنیای کلمات کلیدی با قصد خرید بالا (High-intent)، امتیاز کامل در ابزارهای تحلیل، اغلب یک «عدد نمایشی» (Vanity Metric) است که ارتباط ضعیفی با جایگاه واقعی در نتایج جستوجو دارد.
توهم چکلیست
ابزارهایی مثل Ahrefs و Semrush امتیازی را بر اساس یک چکلیست منتشرشده میدهند. سایتی که امتیاز ۸۹ از ۱۰۰ میگیرد و در رتبه ۱۴ گیر کرده است، کاملاً با قوانین منطبق است، اما فاقد مکانیسمهای اعتباری است که تعیین میکند چرا یک نتیجه خاص در رتبه ۱ قرار میگیرد و دیگران را شکست میدهد.
این وضعیت را با حوزههای «ممنوعه» یا محدود مثل شرطبندی (Gambling)، صرافیهای ارز دیجیتال و امور مالی پرریسک مقایسه کنید. این سایتها اغلب امتیاز تحلیل Semrush بین ۴۰ تا ۶۰ درصد دارند. اگر سئو یک بازی نقشآفرینی (RPG) بود، برگه مشخصات شخصیت این سایتها یک فاجعه بود: بدون زره، تجهیزات شکسته و ۱۲ اثر منفی (Debuff) فعال. با این حال، آنها هر ماه مرحله آخر (Raid) را با موفقیت میگذراندند. آنها بهطور گسترده دچار این خطاها هستند:
- تگهای عنوان (Title tags) تکراری در صدها صفحه
- نبود دادههای ساختاریافته (Structured Data)
- شاخصهای حیاتی وب (Core Web Vitals) خلاقانه اما ضعیف
- تکرار تگ H1 در بیش از ۸۰ صفحه بدون هیچ نگرانی یا شرمی

با وجود این شکستها، آنها ۵ تا ۱۰ سال جایگاه برتر خود را حفظ کردهاند. این سازمانها قوانین را نمیدانند یا نسبت به آنها نادان نیستند؛ بلکه تیمهای سئوی تماموقت دارند که همان ابزارها را اجرا میکنند و همان گزارشها را میبینند. آنها یک شرطبندی حسابشده و آگاهانه انجام دادهاند: اینکه رابطه بین امتیاز ابزار تحلیل و رتبهبندی، بسیار ضعیفتر از آن چیزی است که دفترچههای راهنما پیشنهاد میکنند. آنها ۱۰ سال دادههای درآمدی دارند که این شرطبندی را پشتیبانی میکند.
چرا سایتهای «ممنوعه» پیروز میشوند؟
سایتهای بخشهای محدودشده نمیتوانند از Google Ads یا پلتفرمهای تبلیغاتی جریان اصلی استفاده کنند. وقتی مدلهای زبانی بزرگ (LLM) از ذکر نام آنها خودداری میکنند و ریش-اسنیپتها (Rich Snippets) برایشان غیرقابل دسترس است، تنها یک راه باقی میماند: رشد ارگانیک خالص و اجتنابناپذیر. این جادو نیست؛ نتیجه ۸ سال تلاش سخت برای کسب اعتبار ارگانیک است، بدون اینکه بتوانند با پرداخت پول، «درِ رئیس» را باز کنند و میانبر بزنند.
این محدودیت باعث شد آنها یک آموزش شتابیافته در مورد آنچه گوگل واقعاً پاداش میدهد، تجربه کنند:
- بکلینکهای واقعی: لینکهایی که از سایتهای واقعی با ترافیک واقعی ساخته شدهاند. تیمهای تحریریه این لینکها را قرار میدهند چون رابطه بین دو سایت منطقی است، نه به این دلیل که لینکها از یک دایرکتوری خریداری شدهاند که آخرین بار در دوران ریاست جمهوری اوباما توسط گوگلبات دیده شده است.
- اعتبار موضوعی (Topical Authority): اعتباری که طی سالها جمع شده است، زیرا کانالهای پولی هرگز وجود نداشتند تا بودجهای برای میانبر زدن فراهم کنند.
- سیگنالهای رفتاری: چون کمپینهای ریتارگتینگ نمیتوانند تجربه کاربری بد را جبران کنند، روی حفظ کاربر و تعامل (Engagement) بهطور وسواسگونه کار شده است.
درحالیکه گروهِ «طرفداران چکلیست» مشغول مطالعه جزوههای مدرس هستند، این سایتها یک دهه است که بدون دیدن جزوهها در جلسه امتحان شرکت میکنند. نتایج آنها که با ترافیک ارگانیک و درآمد اندازهگیری میشود — گاهی ۴۰ میلیون دلار در سال — حتی نزدیک به نتایج گروه چکلیستی نیست.
شکست توصیههای هوش مصنوعی در لینکهای داخلی
توصیه استاندارد LLMها برای استراتژی لینکسازی داخلی بسیار کلی و سطحی است: لینکهای بیشتر اضافه کنید، در هر مقاله ۳ تا ۵ لینک بگذارید، از متن لینک (Anchor Text) غنی از کلمه کلیدی استفاده کنید و همهچیز را به هم لینک دهید تا امتیاز لینک داخلی بالا رود. این یک آموزش سطح NPC (شخصیتهای غیرقابل بازی) است.
سایتهای رتبهبالا از یک رویکرد سختگیرانه «سیلوهای موضوعی» (Thematic Silos) استفاده میکنند که در آن هر لینک باید دلیل وجود خود را توجیه کند:
- از ماهواره به ستون: صفحات ماهوارهای (Satellite) باید اعتبار را به سمت بالا و به صفحه ستون (Pillar) هدایت کنند.
- روابط تنگ: صفحه ستون لینکها را به صورت پراکنده به ۲۰ صفحه با ارتباط سست نمیفرستد تا فقط «اعتبار منتقل کند» (Pass Equity). بلکه فقط به ۲ یا ۳ موضوع همسایه که رابطه تنگی دارند و صفحه مقصد دارای ترافیک واقعی است، لینک میدهد.
- تأیید ترافیک: برای لینکسازی متقاطع (که اغلب در اکوسیستمهای خودشان انجام میشود)، تنها فیلتر مهم این است که آیا لینک از صفحهای با ترافیک واقعی و قابلسنجش در Search Console به صفحهای میرود که واقعاً همان موضوع را پوشش میدهد یا خیر.
به عنوان یک نکته حاشیهای، نویسنده مقاله ذکر میکند که کیبورد مکانیکی ۷ سالهاش ماه گذشته بالاخره شکست؛ او اکنون در سومین جایگزین است و دلتنگ مدل قدیمی است. به همین ترتیب، در حالیکه امتیاز تحلیل با لینکهای «بیشتر» بالا میرود، رتبه فقط با لینکهای «بهتر» بالا میرود.
نقاط کور ساختاری در LLMها
مدلهای زبانی نمیتوانند این استراتژیهای سطح بالا را آموزش دهند چون نحوه آموزش آنها همین است. آنها بر اساس نسخههای «پاکسازیشده» از متون عمومی، سخنرانیهای کنفرانسها و پستهای لینکدین استدلال میکنند.
- سوگیری آموزشی: تاکتیکهای واقعی که نتایج SERP را تغییر میدهند، در کانالهای خصوصی اسلک (Slack)، گزارشات تست داخلی متخصصان باسابقه حوزههای محدود و دانش سازمانی نهفته است. LLMها فقط نسخه «روابط عمومی» پاسخها را دارند. این ناتوانی در درک پیچیدگیهای عملیاتی، مشابه نقاط کوری است که داوران LLM در شناسایی نقصهای عاملهای چندمرحلهای دارند و باعث میشود تحلیلهای آنها از واقعیت فاصله بگیرد.
- نبود بستر (Context): یک مدل زبانی به دامنه خاص شما دسترسی ندارد. نمیداند شما در رتبه ۱۱ هستید و فقط یک بکلینک محکم تا صفحه اول فاصله دارید، یا اینکه نرخ پرش (Bounce Rate) شما ۷۴٪ است در حالیکه صفحه رتبه ۱ تنها ۳۸٪ است، یا اینکه Search Console شما ۱۲۰۰ ایمپرشن روزانه برای کلاستر کوئریهایی نشان میدهد که هرگز برای آنها محتوا ننوشتهاید.
- فیلترهای ایمنی: مدلهایی مثل ChatGPT، Claude و Perplexity وقتی درباره صرافیهای کریپتو یا پلتفرمهای شرطبندی سوال شود، با ادب درخواست را رد میکنند و اغلب یادآوریهایی درباره بازی مسئولانه اضافه میکنند.
این یک پارادوکس ایجاد میکند: دقیقاً همان سایتهایی که LLMها برای اجتناب از آنها برنامهریزی شدهاند، باارزشترین دادهها را درباره نحوه کار واقعی گوگل دارند. طبق مطالعهای توسط Ahrefs (جولای ۲۰۲۵)، تایید شد که محتوای تولید شده توسط حالت AI خود گوگل نتوانست به صورت ارگانیک رتبه بگیرد و توسط صفحاتی که در موضوعات مرتبط (حتی با ارتباط سست) اعتبار بیشتری داشتند، شکست خورد؛ زیرا اعتبار بر انطباق فنی غلبه کرد.
سراب GEO و AI
این بدان معنای این است که ترند فعلی «بهینهسازی برای موتورهای زاینده» (GEO)، فایلهای llms.txt و بهینهسازی برای AI Overviews صرفاً یک لایه اضافی است. این ابزارها برای دستههایی هستند که LLMها تمایل به توصیه آنها دارند، اما جایگزینی برای زیربنای ارگانیک نیستند.
سایتهای ممنوعه هیچ استراتژی GEO یا فایل llms.txt ندارند و در بحثهای AEO (بهینهسازی موتور AI) کاملاً غایب هستند. با این حال، آنها رتبههای ارگانیک گرانترین کلمات کلیدی اینترنت را در طول چندین آپدیت بزرگ الگوریتمی کنترل میکنند.
دامنههایی که اکنون در GEO پیروز میشوند، قبل از ظهور GEO، اعتبار دامنه (Domain Authority) قوی و پروفایل بکلینک عمیقی داشتند. فایل llms.txt که این هفته توصیه میشود اضافه کنید، جایگزینی برای جایگاه ارگانیک ضعیف نیست. همانطور که پرامپتهای سیستمی لو رفته نشان میدهند، شکاف بین «کتابچه راهنمای رسمی» و «کتابچه راهنمای واقعی» بسیار عمیقتر از آن است که کارگاههای سئوی AI اذعان کنند.
اگر میخواهید بازی واقعی سئو را یاد بگیرید، نگاه کردن به امتیاز تحلیل را متوقف کنید و سایتهایی را بررسی کنید که توسط هوش مصنوعی «ممنوع» شدهاند. Ahrefs یا Semrush را باز کنید، عبارت «online poker» یا «buy bitcoin» را جستوجو کنید و رتبه ۱ را تحلیل کنید. ۸۰ خطای بحرانی را یادداشت کنید. این سایتها برنامه درسی شما هستند، چه بخواهید و چه نخواهید.
منتظر تغییرات آینده در نحوه مدیریت سیگنالهای «اعتبار» توسط گوگل باشید، زیرا با هجوم محتوای تولید شده توسط AI به وب، این مزایای قدیمی دامنه احتمالاً حتی ارزشمندتر خواهند شد.
منابع
- محتوای حالت AI گوگل در جستوجوی ارگانیک شکست میخورد (پاتریک استوکس، Ahrefs، جولای ۲۰۲۵)
- بهترین ابزارهای سئو AI سال ۲۰۲۶ و ابزارهایی که باید از آنها دوری کنید (behindrankings.com، بهروزرسانی ژوئن ۲۰۲۶)
گام بعدی شما
- تحلیل رقبای رتبه۱ در حوزههای High-Competition را بدون توجه به امتیازات فنی انجام دهید تا الگوی لینکسازی واقعی آنها را کشف کنید.
- تمرکز خود را از «پاکسازی خطاهای فنی» به «ساخت اعتبار موضوعی» و جذب لینکهای ارگانیک از سایتهای با ترافیک واقعی منتقل کنید.
- به جای تکیه بر توصیههای کلی LLM برای لینکسازی، استراتژی سیلوهای موضوعی (Thematic Silos) را پیادهسازی کنید.
اما داستان سختافزاری این تحول حتی شگفتانگیزتر است — به تحلیل ما درباره تراشههای Blackwell مراجعه کنید.


گفتگو