تصور کنید سیستمی ساختهاید که قرار است بهصورت خودکار مشتریان بالقوه را پیدا کرده، آنها را ارزیابی کند و در نهایت در یک نمونه از Twenty CRM ثبت نماید، اما ناگهان متوجه میشوید ۲۰ درصد دادههای شما اشتباه یا تکراری است. اگر تمام مراحل کاری خود را به یک عامل هوش مصنوعی سپردهاید، احتمالاً با کابوسی از خطاهای تصادفی مواجه شدهاید که عیبیابی آنها تقریباً غیرممکن است.
طبق تحلیلی که در ۲۲ جولای ۲۰۲۶ منتشر شد، یک مشاور پیادهسازی حرفهای AI دریافت که استقرار یک عامل (Agent) واحد برای مدیریت کل یک خط لوله تجاری، میتواند منجر به نرخ خطای ۱۰ تا ۲۰ درصدی در دقت دادهها شود. دلیل اصلی این اتفاق، ماهیت غیرقطعی (non-deterministic) این سیستمهاست؛ یعنی یک پرامپت (Prompt) یکسان، هر بار نتایج متفاوتی تولید میکند و همین موضوع، تحلیل شکستها را به بنبست میکشاند، زیرا نمیتوان دقیقاً بازتولید کرد که چرا سیستم در یک لحظه خاص اشتباه کرده است.
در اولین نسخه این سیستم اکتشاف، تمام مراحل خط لوله شناسایی به یک عامل LLM واحد سپرده شد: از جستوجوی وب و حذف دادههای تکراری گرفته تا اعتبارسنجی و درج در پایگاه داده. در نتیجه، ۱۰ تا ۲۰ درصد از مخاطبان یافتشده یا نامرتبط بودند، یا بهصورت تکراری ثبت شده بودند و یا به شکلی نادرست در CRM وارد شده بودند. از آنجا که عامل در هر بار اجرا مسیر و رویکرد متفاوتی را طی میکرد، هر بار با موانع فنی و ابزاری منحصربهفردی برخورد میکرد. این شکست چنان سیستمی و گسترده بود که نویسنده مجبور شد بهصورت دستی در تمام لیست بیش از ۸۰۰ مورد موجود در CRM جستوجو کند تا ارتباط آنها را تأیید و موارد تکراری را حذف نماید. بهوضوح مشخص شد که این راهکار «همه-در-یک» (all-in-one) اصلاً عملی و بادوام نیست.
این چالش، تنش شدیدی را در پذیرش هوش مصنوعی سازمانی نشان میدهد. بسیاری از مدیران اجرایی در حال حاضر موفقیت را با معیارهایی پوچ و قراردادی مثل میزان مصرف توکن (Token) — تکههای کوچکی از متن، شبیه برشهای یک کیک طولانی که مدل تکهتکه میخورد — یا تعداد خطوط کد میسنجند، بهجای اینکه روی کاربرد واقعی و سودآوری تمرکز کنند. همانطور که در بحثهای قبلی ما دربارهی دوره آموزشی LLM به زبان تلوگو (Telugu LLM Course) دیدیم، شکستن موانع زبانی گام حیاتی در دسترسی به AI است، اما معماری فنی همچنان باید استوار باشد تا از فروپاشی عملیاتی جلوگیری شود. استفاده از AI بهعنوان «چکش برای هر میخ»، اغلب منجر به سیستمهای شکنندهای میشود که هزینه پاکسازی دستی آنها از سود اولیه یا مشکل اصلی که قرار بود حل کنند، بیشتر است.
شکاف قطعیت
به نقل از گزارش منتشر شده در cameronmpalmer.medium.com، هسته مشکل این است که LLMها «قطعیت» (Determinism) را فدای «انعطاف» (Flexibility) میکنند. در حالی که کدهای سنتی تکرارپذیر هستند (یعنی ورودی A همیشه خروجی B را میدهد)، LLMها ذاتا متغیرند. نویسنده سه زیان اصلی در گذار از کدنویسی ساده به عاملهای AI را شناسایی کرده است:
- تکرارپذیری: ورودیهای یکسان، خروجیهای یکسان را تضمین نمیکنند. این نوسان، تست و تحلیل خطا را بسیار سختتر از کدهای سنتی میکند، زیرا معیارهای موفقیت در اینجا اغلب ذهنی (subjective) هستند و نمیتوان یک تست واحد برای همه حالتها نوشت.
- سرعت: گردش کارهای مبتنی بر LLM بهطور معمول زمان بسیار بیشتری برای اجرا میگیرند تا اسکریپتهای قطعی و سریع.
- هزینه: هزینههای استنتاج (Inference) — لحظهای که مدل واقعاً جواب تولید میکند، شبیه خودِ آشپزی و نه دوره آموزش آشپز — در مقایسه با اجرای کد محلی که هزینه آن نزدیک به صفر است، سریعاً انباشته میشود و هزینههای عملیاتی را بالا میبرد.
با این حال، LLMها در جایی که کار نیازمند تفسیر زبان طبیعی، ترکیب و سنتز اطلاعات فراوان یا متنوع، و استدلال گامبهگام است (جایی که قوانین فرآیند را نمیتوان پیش از شروع کار بهطور دقیق تعریف کرد)، جایگزینناپذیرند. این نیاز به توازن میان قدرت مدل و کنترل عملیاتی، مشابه رویکردی است که در بهکارگیری مدلهای زبانی کوچک (SLM) برای مدیریت دقیق حریم خصوصی در بانکها مشاهده میکنیم تا ریسکهای عملیاتی کاهش یابد.
چارچوب ارزیابی ششپرسشی
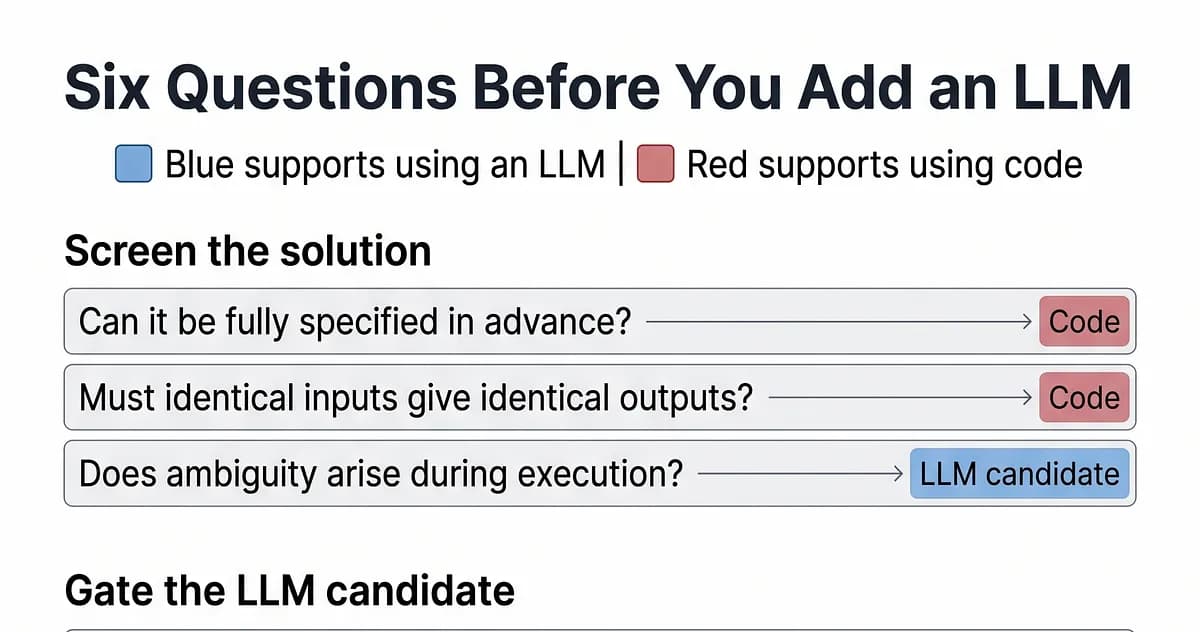
برای جلوگیری از شکستهای رویکرد «اول-هوش مصنوعی» (AI-first)، نویسنده یک فرآیند غربالگری سختگیرانه را پیشنهاد میکند. پیش از افزودن LLM به هر گردش کاری، باید این ۶ پرسش را بپرسید تا متوجه شوید آیا این ابزار مناسب است یا خیر:
۱. آیا گردش کار را میتوان پیش از اجرا بهطور کامل تعریف کرد؟ اگر یک فرآیند را بتوان پیش از شروع بهطور کامل نقشهبرداری کرد، کد قطعی برتر است. برای مثال، یک خط لوله CI/CD نمونه بارز است: کد Push میشود، سپس فرآیندی تحریک میشود که Linting میکند، تستها را اجرا میکند و در نهایت روی محیط توسعه Deploy میکند. این مسیر هر بار دقیقاً به یک شکل اجرا میشود.
۲. آیا ورودیهای یکسان باید حتماً به خروجیهای یکسان منجر شوند؟ سیستمهای پرداخت نمونهای حیاتی هستند. سیستمی که یک فاکتور، حوزه مالیاتی و درخواست تلاش مجدد (retry) یکسان را دوبار دریافت میکند، باید دقیقاً همان مبلغ را محاسبه کند و از شارژ دوباره مشتری جلوگیری کند. LLMها برای چنین کارهایی کاملاً نامناسب هستند.
۳. آیا راهکار نیازمند تفسیر ابهام در حین اجرا است؟ LLMها زمانی میدرخشند که مسیر پیشرو به متغیرهای متغیر وابسته باشد. برای مثال، اگر فایلی در یک پوشه مشخص یافت نشد، LLM میتواند تصمیم بگیرد که گام بعدی جستوجو در کجا باشد. این با ابهامی که میتوان قبل از اجرا حل کرد متفاوت است؛ اگر مشکل را میتوان زودتر حل کرد، از کد ساده استفاده کنید.
۴. آیا نتایج بهطور ارزان اعتبارسنجی میشوند؟ در حالی که «کدهای حسی» (Vibe code) را میتوان 쉽게 با معیارهای صریح تست کرد، اما برخی خروجیها برای تأیید بسیار هزینهبر هستند. تأیید یک تشخیص پزشکی یا توصیه حقوقی نیازمند تخصص ویژه و زمان زیاد است. اگر اعتبارسنجی محدود به زمان باشد (مثلاً پیشبینی اینکه آیا یک استراتژی تجاری موفق میشود یا خیر)، ریسک استفاده از LLM بسیار بالاست.
۵. اگر خروجی غلط باشد چه اتفاق میافتد؟ تمام سیستمها شکست میخورند؛ پرسش اصلی این است که شدت شکست چقدر است. اشتباهی که به مشتری ۱۵ دلار تخفیف میدهد ریسک پایینی دارد، اما تخفیفی ۵۰۰۰ دلاری یک خطای شدید است. ریسکها را میتوان با دور کردن AI از نقطه اثر کاهش داد؛ مثلاً باتی که به یک عامل انسانی مشاوره میدهد، بهجای باتی که مستقیماً تخفیف را اعمال میکند.
۶. آیا LLM بهطور معناداری بهتر از یک جایگزین سادهتر است؟ با استفاده از متد KISS (ساده نگه دار، احمق!)، اگر یک راهکار مبتنی بر کد بتواند ۹۵ درصد از کیفیت را در زمینه نرخ خطا، مداخلات انسانی و هزینه فراهم کند، آن راهکار کدی انتخاب درست است.
بازسازی خط لوله جذب مشتری
اعمال این چارچوب روی مورد Twenty CRM نشان داد که عامل «همه-در-یک» اولیه دارای نقص ساختاری بود. این گردش کار شامل تولید پرسوجو (Query Generation)، اجرای آن از طریق Decodo search (با استفاده از ابزار جستوجوی وب MCP)، حذف تکراریها، اعتبارسنجی و درج در پایگاه داده بود.
تحلیل دقیق خط لوله
- تولید پرسوجو: این مرحله به انعطاف نیاز دارد. LLM باید مشتریان فعلی در CRM را تفسیر کند و پرسوجوهایی بنویسد تا دقیقاً آن شکافهای اطلاعاتی پر شوند. این بخش کاندیدای بسیار قوی برای استفاده از AI است.
- اجرا و درج: اجرای پرسوجوها از طریق Decodo، حذف تکراریها از میان ورودیهای موجود و درج آنها در دیتابیس CRM، کارهایی قطعی (Deterministic) هستند که هیچ ابهامی ندارند. استفاده از LLM در اینجا فقط ریسک را افزایش میدهد بدون اینکه هیچ سودی داشته باشد.
- اعتبارسنجی: نویسنده اشاره کرد که تأیید یک مشتری در پایگاه داده یک عملیات «ارزان» است؛ زیرا خواندن نام، شرکت و عنوان شغلی کمتر از ۱۰ ثانیه زمان میبرد.
- سنجش ریسک: در این مورد خاص، خروجیهای غلط ریسک پایینی دارند. ارسال یک پیام تکراری برای یک مشتری بالقوه، یک مزاحمت کوچک است که قابل اصلاح است، برخلاف خطاهای مالی یا پزشکی.
در حالی که جایگزین سادهتر — یعنی فکر کردن دستی به پرسوجوها و استفاده از یک سیستم اعتبارسنجی مبتنی بر Regex برای تطبیق کلمات کلیدی — ناکارآمد و بیاثر میبود، اما پاسخ این نبود که برای همه چیز از LLM استفاده کنیم، بلکه باید آن را فقط در جایی به کار برد که ابهام وجود دارد.
راهکار معماری ترکیبی
بهینهترین راهکارهای AI بر پایه انتخاب دوتایی بین «کد یا هوش مصنوعی» نیستند، بلکه سیستمهای ترکیبی (Hybrid) هستند. پایدارترین معماری، استفاده از کدهای اعتبارسنجی قطعی و اتوماسیون فرآیند بهعنوان «حفاظها» (Guardrails) در اطراف استدلال انعطافپذیر LLM است.
این رویکرد تضمین میکند که LLM فقط در نقاط ابهام عمل کند. برای مثال، یک LLM ممکن است تصمیم بگیرد کدام مشتری مرتبط است، اما یک اسکریپت قطعی تضمین میکند که ایمیل آن مشتری پیش از ورود به پایگاه داده، فرمت صحیحی داشته باشد. این تفکیک وظایف (Separation of Concerns)، نیاز به مداخلات انسانی گرانقیمت را کاهش داده و هزینه کلی توکنها را پایین میآورد.
برای متخصصان و توسعهدهندگان، این به معنای تغییر تمرکز از «کجا میتوانیم AI را اعمال کنیم؟» به «دقیقاً چه مشکلی را حل میکنیم؟» است. تنها پس از تعریف دقیق مسئله است که ابزار — چه یک LLM، چه یک اسکریپت Regex یا یک پرسوجوی سنتی دیتابیس — بر اساس موازنه بین انطباقپذیری و دقت انتخاب شود. هدف نباید تبدیل شدن به یک شرکت «AI-first» باشد، بلکه هدف باید حل مسائل مبرم با استفاده از مناسبترین ابزار برای آن کار باشد.
گام بعدی شما
- تمام گردش کارهای فعلی خود را با «چارچوب ششپرسشی» بررسی کنید و بخشهای قطعی را از LLM جدا کنید.
- برای لایههای اعتبارسنجی، بهجای Prompting، از Regex یا توابع ساده برنامهنویسی استفاده کنید تا نرخ خطا به صفر برسد.
- هزینه استنتاج خود را تحلیل کنید تا ببینید کجا توکنها صرف کارهای تکراری و غیربهرهور شدهاند.
اما داستان سختافزاری این تحول حتی شگفتانگیزتر است؛ اثر این بهینهسازیها بر کاهش فشار به GPUها را در گزارش بعدی بررسی خواهیم کرد.



گفتگو