اعتماد به اشتباه در یک مدل یادگیری ماشین میتواند بسیار هزینهبرتر از یک خطای ساده باشد. طبق راهنمای کاربردی منتشرشده در dev.to در ۳۰ ژوئن ۲۰۲۶، انتخاب بین توابع زیان در واقع یک تصمیم تجاری درباره این است که کدام حالتهای شکست، بیشترین هزینه را به سازمان تحمیل میکنند.
زمینه پیشبینی
وقتی یادگیری ماشین را شروع میکنید، بسیاری از دانشجویان صرفاً حفظ میکنند که رگرسیون از میانگین مربعات خطا (MSE) و طبقهبندی از Log Loss استفاده میکند. اما تحلیل واقعی و تغییر در درک موضوع زمانی آغاز میشود که بپرسیم چرا طبقهبندی به یک تابع زیان کاملاً متفاوت نیاز دارد.
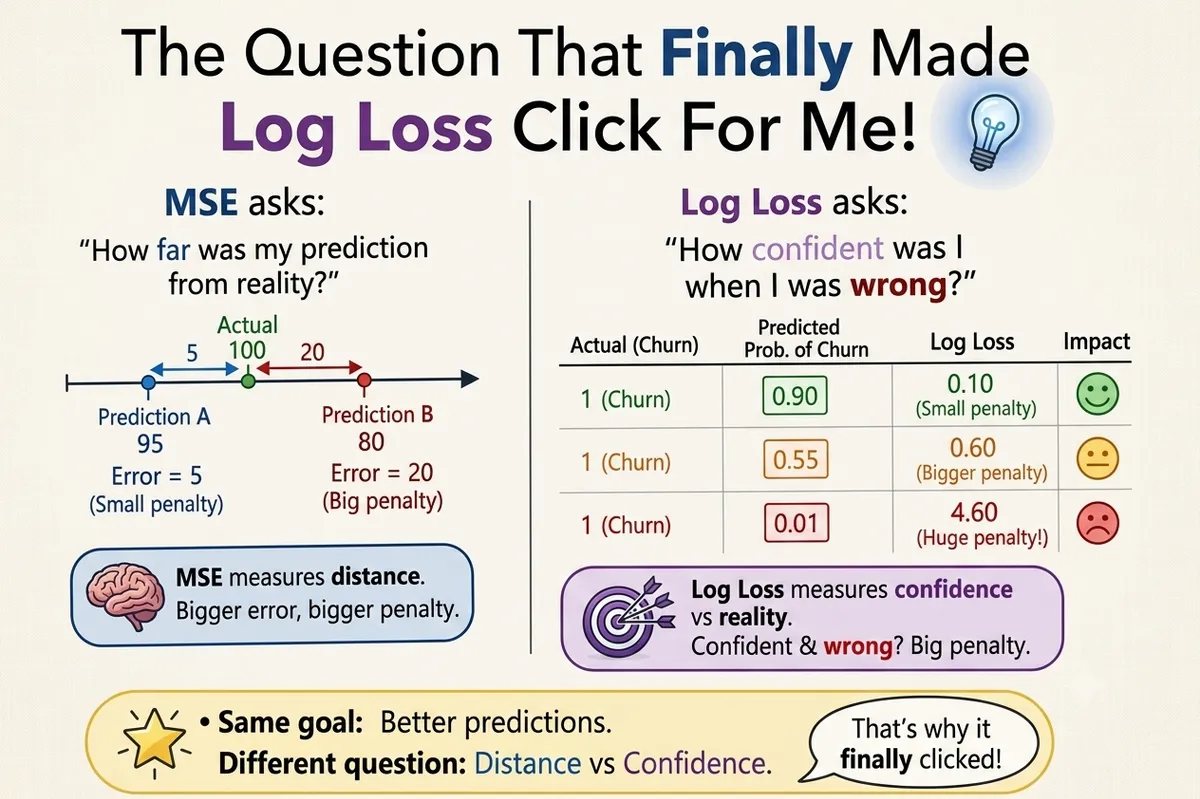
در یک مسئلهی رگرسیون (Regression) — مثل پیشبینی قیمت خانه که شبیه حدس زدن مبلغ یک کالا در بازار است — معیار MSE استاندارد است. MSE یک سؤال ساده میپرسد: پیشبینی شما چقدر با واقعیت فاصله داشت؟ اگر خانهای واقعاً ۱۰۰ لک (Lakh) ارزش داشته باشد، پیشبینی ۹۵ لک کمی خطا دارد، اما پیشبینی ۸۰ لک بسیار غلطتر است. هرچه فاصله پیشبینی از واقعیت بیشتر شود، جریمه سنگینتر میشود. این رویکرد در پیشبینیهای مقیاس بزرگ کاربرد دارد، مشابه آنچه در پژوهشهای مدلهای بنیادی برای پیشبینی تقاضا دیدهایم که تخصص در داده را با مدلهای پیشرفته جایگزین میکند.
اما طبقهبندی (Classification) چالش متفاوتی دارد؛ چون هیچ فاصله فیزیکی یا عددی بین «ریزش مشتری» (۱) و «عدم ریزش» (۰) وجود ندارد. یک تصور غلط رایج در میان تازهکارها این است که مدل باید صرفاً برای درست گفتن پاداش بگیرد و برای اشتباه، جریمه شود.
ظرافتهای اعتماد
با این حال، دو مدل میتوانند به دلایل بسیار متفاوتی درست پیشبینی کنند. تصور کنید مشتریی واقعاً ریزش کرده است:
- مدل الف: احتمال ریزش را ۵۱٪ پیشبینی میکند. این مدل درست گفته است، اما به سختی و با تردید زیاد.
- مدل ب: احتمال ریزش را ۹۹٪ پیشبینی میکند. این مدل هم درست گفته است، اما با اعتماد به نفس بالا.
هر دو مدل جواب درست را دادند، اما لایق پاداش یکسانی نیستند. مدل ب اعتماد بسیار بیشتری نشان داده و به همین دلیل برای دقتش باید اعتبار بیشتری بگیرد.
جزئیات سازوکارهای Log Loss
اینجاست که نقش اصلی Log Loss وارد عمل میشود. این تابع به جای پرسیدن «آیا پیشبینی درست بود؟»، میپرسد «مدل هنگام پیشبینی چقدر اعتماد داشت؟». این سازوکار، یک شیب جریمه تند بر اساس احتمال تخصیصشده ایجاد میکند:
- مطمئن و درست: احتمال ۰.۹۰ برای نتیجه مثبت، زیان کوچکی (حدود ۰.۱۰) ایجاد میکند. در این حالت مدل بسیار کم جریمه میشود.
- نامطمئن اما درست: احتمال ۰.۵۵ برای نتیجه مثبت، زیان بیشتری (حدود ۰.۶۰) دارد. مدل درست گفته است، اما مردد بوده است.
- مطمئن و غلط: احتمال ۰.۰۱ در حالی که نتیجه واقعاً مثبت است، جریمهای عظیم (حدود ۴.۶۰) ایجاد میکند. این زمانی رخ میدهد که مدل شدیداً باور داشته باشد نتیجه رخ نمیکند.
در محیطهای تولیدی با ریسک بالا، این تفاوت حیاتی است. یک سیستم تشخیص کلاهبرداری را در نظر بگیرید: مدلی که ۹۹.۹٪ مطمئن است یک تراکنش کلاهبرداری «سالم» است، خسارت مالی بسیار بیشتری نسبت به مدلی میزند که اعتراف میکند فقط ۵۵٪ مطمئن است. در این سامانهها، «اعتماد به اشتباه» یا بیشازحد مطمئن بودن، گران تمام میشود. این چالش شباهت زیادی به پدیده توهمات منطقی در مدلهای زبانی دارد، جایی که مدلها ممکن است با اطمینان دلیل اشتباهی را برای تصمیم خود ارائه دهند.
Log Loss در واقع به مدلها میآموزد که «با اطمینان غلط گفتن»، بدترین نتیجه ممکن است. این دقیقاً شبیه روانشناسی انسان است؛ ما کسی را که ۱۰۰٪ مطمئن بود یک پروژه موفق میشود و در نهایت شکست سخت خورد، بسیار شدیدتر از کسی قضاوت میکنیم که احتمال شکست را ۵۵٪ میدانست.
در نهایت، انتخاب یک تابع زیان (Loss Function) در واقع کدگذاری یک باور درباره ریسک است. MSE این فرض را دارد که خطاهای بزرگ در مقدار، هزینهبر هستند. Log Loss این فرض را دارد که اعتماد نابهجا، هزینهبر است.
توسعهدهندگان میتوانند با نگاه به این فرمولها به عنوان منطق کسبوکار، و نه صرفاً ریاضیات انتزاعی، رفتار یادگیری مدل خود را با هزینههای واقعی شکست در جهان واقعی همراستا کنند. برای تسلط بر ارزیابی مدل، باید حالتهای شکست خاص کسبوکار خود را تحلیل کنید. از خود بپرسید: آیا یک انحراف کوچک در مقدار خطرناکتر است، یا یک حدس غلط با اعتماد به نفس بالا هزینهبرتر است؟
گام بعدی شما
- تحلیل کنید که در پروژه فعلی خود، کدام حالت شکست (خطای کوچک در مقدار یا اعتماد به اشتباه) هزینه مالی یا عملیاتی بیشتری دارد.
- اگر از مدلهای طبقهبندی استفاده میکنید، علاوه بر Accuracy، مقدار Log Loss را در مجموعه آزمون بررسی کنید تا میزان کالیبراسیون اعتماد مدل را بسنجید.
- بررسی کنید آیا نیاز است برای کاهش جریمههای شدید، از تکنیکهای کالیبراسیون احتمالات (Probability Calibration) استفاده کنید یا خیر.
اما تأثیر این توابع بر سرعت آموزش مدلها حتی پیچیدهتر است — به تحلیل ما دربارهی بهینهسازها و نرخ یادگیری مراجعه کنید.



گفتگو