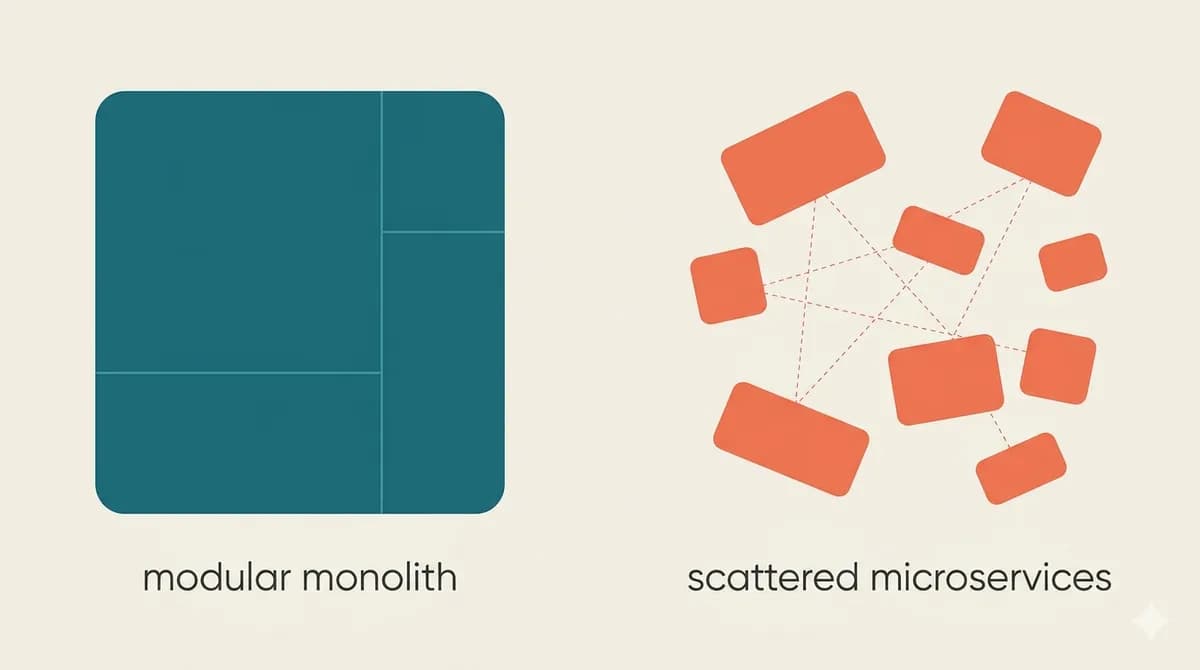
تصور کنید برنامهنویسی هستید که هر تغییر کوچک در بخش پرداخت، بهطور اتفاقی موتور اعلانهای سیستم را از کار میاندازد. این کابوس معماری، اکنون با ورود هوش مصنوعی به مرحلهای خطرناکتر رسیده است؛ چراکه مدلها برای بهینهکردن سریعترین مسیر به جواب، مرزهای منطقی کد شما را تخریب میکنند.
به گزارش راهنمای فنی مفصلی که در ۱۱ ژوئیه ۲۰۲۶ در وبسایت dev.to منتشر شد، صنعت نرمافزار اکنون دچار یک «خمارگی» (Hangover) پس از دوران تب میکروسرویسها شده است. برای درک این وضعیت، چشمانداز معماری سال ۲۰۱۸ را در نظر بگیرید: در آن زمان، اگر قصد داشتید پروژهای جدید را بدون خوشهی Kubernetes، یک سرویس مش (Service Mesh) و دهها میکروسرویس پیشنهاد دهید، احتمالاً در جلسه بررسی معماری مورد خندهی همکارانتان قرار میگرفتید. اما امروز، شروع یک پروژه با یک خوشهی عظیم کوبرنتیز و دوجین میکروسرویس، در بسیاری از موارد به جای نشانهی بلوغ فنی، یک اشتباه استراتژیک تلقی میشود.
به ما وعده داده شده بود که استقرارها مستقل خواهند بود، مقیاسپذیری بینهایت خواهیم داشت و آیندهای بدون بدهی فنی در انتظار ماست؛ آیندهای با سرویسهای کوچک و تمیز که هر کدام سرشان در لاک خودشان است. اما واقعیت امروز متفاوت است. بسیاری از تیمها میبینند که غرق در داشبوردهای ردیابی توزیعشده (Distributed Tracing) شدهاند تا صرفاً بفهمند چرا یک درخواست ساده ۴ ثانیه طول میکشد. آنها مجبورند برای ردیابی یک باگ، بین پنج مخزن کد (Repository) مختلف، سه چرخه On-call و یک رشتهگفتگوی بسیار گیجکننده در Slack جستوجو کنند. طنز تلخ ماجرا این است که بسیاری از این سیستمهای پیچیده، تنها برای چند هزار کاربر خدمات میدهند، نه میلیونها کاربری که معماری آنها بر اساس آن طراحی شده بود.
همانطور که در تحلیل قبلی ما دربارهی بدهی فنی هوش مصنوعی اشاره کردیم، این پیچیدگیها فقط سرعت انسان را نمیگیرد، بلکه کاربرد دستیاران کدنویسی را بهطور فعال مختل میکند. این چالش دقیقاً همان جایی است که سرعت بالای تولید کد توسط هوش مصنوعی با کندی فرآیندهای استقرار در محیط واقعی برخورد میکند و بهرهوری کلی تیم را کاهش میدهد. مشکل از نبود هوش در مدل نیست، بلکه محدودیتهای معماری کدی است که مدل لمس میکند. هوش مصنوعی به یکپارچگی معماری فکر نمیکند؛ او فقط میخواهد تغییرات فعلی (Diff) را «سبز» کند و تستها را پاس دهد. این موضوع شکاف خطرناکی بین آنچه کد انجام میدهد و آنچه سیستم باید باشد، ایجاد میکند.
تضاد هوش مصنوعی: زمینه در برابر دسترسی
طبق این مستندات، دستیاران هوش مصنوعی بسته به نوع معماری، به دو شکل متمایز شکست میخورند. در یک محیط گسترده از میکروسرویسها، مدلها دچار مشکل میشوند زیرا نمیتوانند قراردادها، صفها و مرزهای شبکهی دوجین سرویس مختلف را بهطور همزمان در یک پنجرهٔ زمینه (Context Window) — مثل میز کاری که جا برای چند ورق دارد، نه برای کل کتابخانه — نگه دارند. این محدودیت باعث میشود هوش مصنوعی شروع به حدس زدن کند. برای مثال، مدل با اطمینان نام یک فیلد را تغییر میدهد، بدون آنکه متوجه شود سه سرویس دیگر به آن وابسته هستند، یا صرفاً یک قرارداد (Contract) را بهطور کامل نادیده میگیرد چون نمیتوانست مرز مربوط به آن را در پنجرهی زمینهاش «ببیند».
در مقابل، در یک مونولیت سنتی و بههمپیچیده یا همان «گلولهی بزرگ گل و لای» (Big Ball of Mud) — از آن دست سیستمهایی که در آن لمس منطق پرداخت بهطور نامعلومی موتور اعلانها را میشکند — هوش مصنوعی دسترسی بیش از حد دارد. چون مرزهای فیزیکی وجود ندارد، مدل برای انجام یک تغییر ساده، به پوشههایی دسترسی پیدا میکند که هیچ ارتباطی با هم ندارند. اگر از او بخواهید «یک فیلد تخفیف اضافه کند»، ممکن است برای اینکه سریعترین راه برای پاس کردن تست را پیدا کند، یک کلید خارجی (Foreign Key) از جدول سفارشات را مستقیماً به جدول کاربران اضافه کند.
در واقع مدل برای «تغییر سبز» (Green Diff) بهینه میکند، نه برای سلامت و یکپارچگی معماری؛ و این یعنی تولید سریعترین نوع بدهی فنی که بازگشت از آن در آینده بسیار هزینهبر است. این روند منجر به آن شده است که گلوگاه توسعه از مرحلهی ساخت کد به مرحلهی کشف و درک پیچیدگیها منتقل شود، چرا که حجم کد تولید شده سریعتر از توان تحلیل معماران رشد میکند. هوش مصنوعی اساساً ابزاری است که کوتاهترین مسیر به یک نتیجهی Working را بهینه میکند، که متأسفانه اغلب مخربترین مسیر برای یک پروژهی بلندمدت است.

راهکار: مونولیت ماژولار
چارهی این وضعیت، استفاده از یک «مونولیت ماژولار» (Modular Monolith) است که با ساختار معماری پاک (Clean Architecture) پیاده شده باشد. این رویکرد، مرزهای فیزیکی واقعی را درون یک کدبیس واحد تحمیل میکند. این مدل سادگی عملیاتی مونولیت را در امروز فراهم میکند — یعنی فعلاً نیازی به خطوط لولۀ استقرار پیچیده، سرویس دیسکوری (Service Discovery) و مدیریت شکستهای شبکه نیست — اما در عین حال یک محیط محصور و ایمن (Sandbox) ایجاد میکند تا هوش مصنوعی بتواند در آن بهدرستی عمل کند.
با طراحی سیستمی که از همان ابتدا برای «از هم پاشیدن» و جداسازی طراحی شده است، شما مسیری کوتاهتر برای تبدیل یک بخش به یک سرویس مجزا (در صورت نیاز در آینده) ایجاد میکنید. شما در واقع انتخاب میکنید که هزینهی سازمانیِ ایجاد مرزهای واقعی را امروز بپردازید، در حالی که هزینهی عملیاتی میکروسرویسها را تا زمانی که دلیل فنی اثباتشدهای برای پرداخت آن داشته باشید، به تعویق میاندازید.
پایگاهداده؛ معماری واقعی
رایجترین شکست در ماژولارسازی، رعایت مرزها در ساختار پوشهها و نادیده گرفتن آنها در طرح (Schema) پایگاهداده است. شما میتوانید در کانسلوئنس (Confluence) تمیزترین نمودار ماژولار را رسم کنید، با جعبههای مجزا برای «سفارشات»، «موجودی» و «صورتحساب» و فلشهایی که در جهت درست قرار دارند، اما اگر پایگاهداده با این نمودار موافق نباشد، همهی آنها دروغ هستند.
وقتی یک Repository در ماژول «سفارشات» برای سرعت بیشتر، مستقیماً به جدول inventory_items دسترسی پیدا میکند چون نوشتن یک JOIN سریعتر از فراخوانی رابط (Interface) یک ماژول دیگر بود، آن مرز دیگر یک دروغ است. وقتی این اتفاق در دهها تیکت تکرار شود، در نهایت شما جدولی مثل users دارید که ۱۵ ماژول نامرتبط مستقیماً روی آن مینویسند و از آن میخوانند. این در واقع همان «وضعیت تغییرپذیر مشترک» (Shared Mutable State) است که فقط مراحلش طولانیتر شده و باعث میشود ساختار پوشههای شما بیمعنی شود.
- آزمون طرح (The Schema Test): برای بررسی واقعی بودن معماری، به جای نام پوشهها، به کلیدهای خارجی (Foreign Keys) نگاه کنید. طرح پایگاهداده صادقانهترین مستند سیستم شماست؛ چون برخلاف نمودارها، دروغ نمیگوید.
- تلهی مهاجرت (The Migration Trap): گرههای کدنویسی معمولاً در چند روز قابل رفع هستند. اما باز کردن گرههای سالیانِ JOINهای بین-دامنهای و جداول مشترک — یعنی فهمیدن اینکه واقعاً چه کسی مالک یک قطعه داده است، مهاجرت دادن آن و بازنویسی تکتک کوئریها — همان چیزی است که یک استخراج دو هفتهای میکروسرویس را به یک «راهپیمایی مرگ شش ماهه» تبدیل میکند.

پیادهسازی بسترهای محدوده (Bounded Contexts)
بر اساس متدولوژی طراحی دامنه-محور (Domain-Driven Design)، این راهنما «بسترهای محدوده» یا Bounded Contexts را به عنوان واحد واقعی ماژولار بودن معرفی میکند. یک بستر محدوده (مانند سفارشات، صورتحساب یا موجودی) صرفاً یک لایه یا یک پوشه نیست. بلکه برشی از دامنهی شماست که مالک دادههای خودش است و هر چیز دیگری را فقط از طریق یک رابط (Interface) صریح اکسپوز میکند: این رابط میتواند یک فراخوانی متد، یک رویداد منتشر شده (Published Event) یا یک قرارداد تعریف شده باشد. هیچ روش دیگری برای دسترسی مجاز نیست.
قوانین طلایی بسترهای محدوده:
- ممنوعیت دسترسی مستقیم به جدول: هیچ ماژولی هرگز نباید به جداول ماژول دیگر دسترسی داشته باشد. این یک قانون سختگیرانه است: نه مدلهای ORM مشترک، نه JOINهای «سریع» و نه Viewهایی که مخفیانه دو اسکیما را به هم وصل میکنند.
- ارتباط از طریق پورتها: اگر ماژول سفارشات به سطح موجودی نیاز دارد، باید از طریق کد (یک پورت عمومی) بپرسد، نه از طریق SQL. برای مثال، از یک
InventoryQueryPortاختصاصی استفاده کنید که یک دیتا-کلاس یخزده (Frozen Dataclass) مانندStockLevel(شامل sku و available_quantity) را برگرداند. - معکوسسازی وابستگی (Dependency Inversion): سایر ماژولها به پورت وابسته هستند، نه به جزئیات داخلی. مورد کاربرد
PlaceOrderUseCaseحتی نباید بداند که موجودی از Postgres استفاده میکند؛ او فقط رابط (Interface) را میشناسد.

معماری پاک در سطح ماژول
در هر ماژول، فلش وابستگی باید همیشه به سمت داخل باشد. این اصل مرکزی معماری پاک است: قوانین کسبوکار در مرکز قرار دارند و هیچ شناختی از زیرساختهای پیرامون خود ندارند.
- هسته (Domain): منطق خالص کسبوکار اینجا قرار دارد. موجودیتهایی (Entities) مانند کلاس
Orderبا متدconfirm()که قوانینی مثل «نمیتوان سفارشی با مقدار صفر را تأیید کرد» را مدیریت میکنند. این فایلها هیچ Importی از FastAPI، SQLAlchemy یا هر فریمورکی که بداند دیتابیس یا درخواست HTTP چیست، ندارند. - لایهی کاربرد (Application): این لایه پورتها (انتزاعها) را تعریف میکند. یک مورد کاربرد (Use Case) به انتزاعی از ذخیرهسازی وابسته است (مثلاً یک ABC برای
OrderRepositoryبا متدsave())، نه به یک پیادهسازی concrete از دیتابیس. - لایهی زیرساخت (Infrastructure): پیادهسازیهای واقعی، مانند
PostgresOrderRepositoryکه ازpsycopg2برای اجرای دستوراتINSERT INTO ordersاستفاده میکند، در بیرونیترین لبه قرار دارند. آنها به سمت داخل به پورت وابسته هستند، اما هسته هرگز این فایل را Import نمیکند.

این تفکیک به این معناست که جایگزینی Postgres با DynamoDB یا جایگزینی FastAPI با Flask نیازی به هیچ تغییری در منطق کسبوکار ندارد. وقتی در نهایت زمان استخراج یک ماژول به یک سرویس مجزا برسد، شما منطق کسبوکار را بازنویسی نمیکنید؛ بلکه صرفلاً یک آداپتور (Adapter) را بازنویسی میکنید.
مهندسی برای بهرهوری هوش مصنوعی
هوش مصنوعی در یک بستر محدوده شکوفا میشود. چون «شعاع تخریب» (Blast Radius) محدود به چند فایل با قراردادهای روشن است، مدل میتواند بهسرعت موارد کاربرد جدید، پیادهسازیهای Repository یا تستهای مربوط به PlaceOrderUseCase را تولید کند. اشتباهات در این محیط کوچک و تعریف شده، ارزان و بهراحclosest شناسایی میشوند.
اما در سطح بین-ماژولی، هوش مصنوعی معمار بسیار بدی است. بدون محدودیتهای فیزیکی، اگر از او بخواهید «تاریخچه سفارشات را با امتیازات وفاداری نمایش دهد»، احتمالاً یک SQL JOIN مستقیم بین جداول orders و loyalty_points میزند. او بیدقت نیست؛ بلکه در حال بهینهسازی برای کوتاهترین مسیر به یک نتیجهی کارآمد است و در واقع با یک Commit، مرز معماری شما را پاک میکند.
برای جلوگیری از این اتفاق و تبدیل اجرای قوانین از حالت «آرمانی» به «واقعی»، راهنما پیشنهاد میکند:
- بازبینی واردات (Import Linting): استفاده از ابزارهایی مثل import-linter در پایتون یا dependency-cruiser در JS/TS تا در لحظهای که
orders/سعی کند چیزی ازinventory/internal/وارد کند، Build شکست بخورد. - CI به عنوان مرز: به فایل README یا ویکی اعتماد نکنید. خط لولۀ CI باید مرز واقعی باشد؛ اگر تنها چیزی که جلوی یک Import بین-ماژولی را میگیرد یک جمله در ویکی است، فرض کنید که آن مرز حتماً شکسته خواهد شد.
- درونهای کدر (Opaque Internals): اطمینان حاصل کنید که جزئیات داخلی یک ماژول در بیرون از پکیج خودش اکسپوز نمیشود. اگر پورت تنها شیء قابل Import است، دستیار هوش مصنوعی نمیتواند بهطور تصادفی به منطق داخلی دست دسترسی پیدا کند، چون اصلاً چیزی برای دسترسی وجود ندارد.

بازده استراتژیک
با به تعویق انداختن هزینههای عملیاتی سرویس دیسکوری و مدیریت شکستهای شبکه، تیمها میتوانند تمام تمرکز خود را روی تناسب محصول با بازار (Product-Market Fit) بگذارند. وقتی یک ماژول — مثلاً سفارشات — در نهایت نیاز به مقیاسپذیری مستقل داشته باشد یا بخواهد به تیم مجزایی منتقل شود، این انتقال بیدرز خواهد بود.
فرآیند تبدیل:
۱. قبل: متد PlaceOrderUseCase یک شیء پایتونی داخلی را صدا میزند که InventoryQueryPort را پیاده کرده است. این فراخوانی سریع و محلی است.
۲. بعد: متد PlaceOrderUseCase دقیقاً همانطور که بود باقی میماند. تنها تغییر این است که پیادهسازی آن پورت، با یک کلاینت HTTP/gRPC جایگزین میشود که یک سرویس دوردست را صدا میزند.
این رویکرد مشکلات تراکنشهای توزیعشده یا شکستهای شبکه را حذف نمیکند؛ بلکه صرفاً آنها را به زمانی موکول میکند که شما واقعاً نیاز به حل آنها داشته باشید، به جای اینکه در روز اول بهطور گمانهزن (Speculatively) آنها را حل کنید.
گام بعدی شما
یک مونولیت ماژولار واقعی با یک نمودار زیبا از جعبهها و فلشها تعریف نمیشود، بلکه با یک طرح دیتابیس، کدبیس و خط لولۀ CI تعریف میشود که همگی بر سر مرزها توافق دارند و آنها را به یک شکل اجرا میکنند؛ چه درخواست بعدی (Pull Request) از طرف یک انسان بیاید و چه از طرف یک مدل هوش مصنوعی.
دستیاران هوش مصنوعی این اثر را چند برابر میکنند: اگر یکی را به کدبیسی با مرزهای واقعی نقطه کنید، تمام روز کدهای سریع، محصور و یکبارمصرف مینویسد. اما اگر آن را به کدبیسی بدون مرز نقطه کنید، با همان اطمینان، میانبرهای بین-دامنهای میزند. این معماری است که تصمیم میگیرد چه نتیجهای بگیرید.
این موضوع، برادر معماریِ «بدهی فنی هوش مصنوعی» است: شما یک بار بهصورت ساختاری آن را پرداخت میکنید، به جای اینکه برای همیشه در هر Review کد، تکتک با آن بجنگید. برای اعمال این موضوع از امروز، با ممیزی کلیدهای خارجی دیتابیس خود شروع کنید تا ببینید مرزهای واقعی سیستم شما در حال حاضر کجا هستند، فارغ از اینکه ساختار پوشههای شما چه ادعایی میکند.
اما داستان سختافزاری این تحول حتی شگفتانگیزتر است — به تحلیل ما دربارهی تراشههای Blackwell مراجعه کنید.



گفتگو