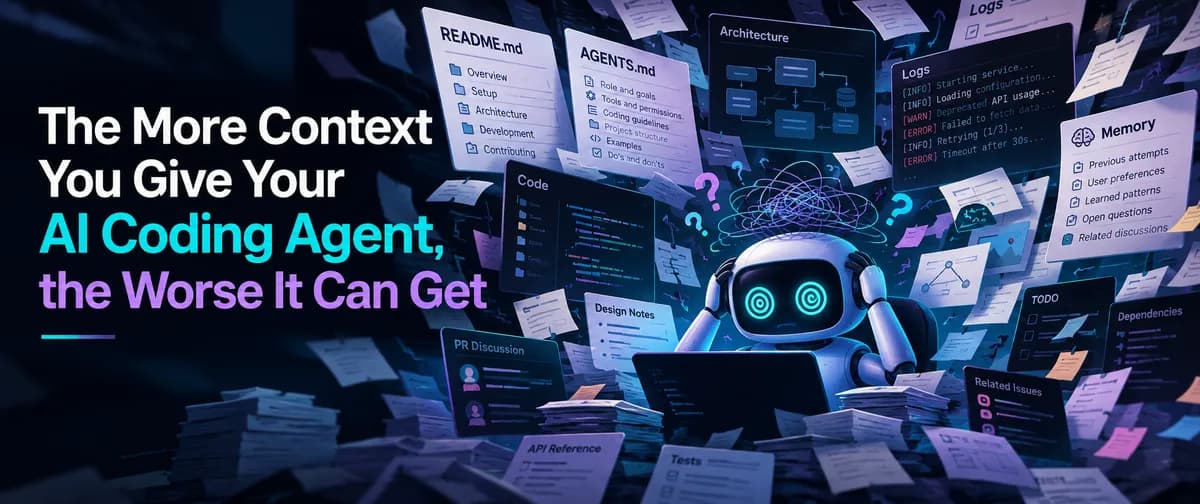
تصور کنید برای رفع یک باگ ساده، ۴۰۰ فایل کد، ۱۲ سند معماری، ۸ گزارش قدیمی از حوادث سیستمی، ۳ برنامه مهاجرت (Migration) منقضیشده، ۶ فایل دستورالعمل و ۴۰ صفحه لاگ را روی میز یک برنامهنویس میریزید و از او میخواهید سریعاً مشکل را حل کند؛ احتمالاً او زیر فشار این حجم از بار شناختی (Cognitive Load) دفن میشود. عاملهای هوش مصنوعی هم دقیقاً همین تجربه را دارند و هرچه دادههای بیشتری به آنها بدهید، لزوماً 똑똑تر نمیشوند، بلکه اغلب با اعتمادبهنفس بیشتری اشتباه میکنند.
به نقل از تحلیل دقیقی که در ۳ اکتبر ۲۰۲۶ در dev.to منتشر شد، باور رایج صنعت مبنی بر اینکه «زمینه بیشتر یعنی عملکرد بهتر» به چالش کشیده شده است. این گزارش استدلال میکند که «بهداشت ضعیف زمینه» (Bad Context Hygiene) یکی از دلایل اصلی شکست عاملهای هوش مصنوعی در مقیاس واقعی است. در واقع، ریختن کل یک کدبیس در یک پرامپت، هوش مدل را زیاد نمیکند، بلکه فقط باعث میشود مدل در اشتباهاتش جسورتر شود.
بسیاری از توسعهدهندگان اکنون از یک قاعده ساده پیروی میکنند: هرچه مدل بیشتر بداند، بهتر کد میزند. آنها پنجرهٔ زمینه (Context Window) — که شبیه میز کاری است که جا برای چند ورق دارد، نه برای کل کتابخانه — را مانند یک سطل در نظر میگیرند که باید با فایلهای README، مستندات معماری، فایلهای AGENTS.md، لاگها، تصمیمات گذشته و حافظه جلسات قبلی پر شود. در عمل، این کار باعث ایجاد مشکل «سیگنال به نویز» میشود؛ یعنی عامل باید میان صدها فایل بگردد تا یک خط کد مرتبط را پیدا کند.
همانطور که در بحثهای گذشتهی ما دربارهی امنیت مدلهای بازمتن اشاره کردیم، مدیریت ورودیها همیشه تعیینکننده خروجی است. در اینجا هم موضوع مشابه است؛ وقتی اطلاعات نامرتبط یا قدیمی برای جلب توجه مدل رقابت میکنند، احتمال خطا بالا میرود و مدل دچار سردرگمی میشود.
خطر زمینههای منقضیشده و متناقض
کیفیت زمینه بسیار مهمتر از کمیت آن است. همه زمینهها به یک اندازه مفید نیستند؛ برخی مرتبطاند، اما برخی دیگر منقضیشده، متناقض، غلط یا از نظر فنی درست اما نسبت به تسک فعلی نامرتبط هستند. اگر به همه اطلاعات وزن یکسانی داده شود، عامل مجبور است حدس بزند چه چیزی اهمیت دارد و دقیقاً همینجاست که اشتباهات شروع میشوند.
طبق گزارش dev.to، برخی دادهها نه تنها مفید نیستند، بلکه «سمی» عمل کرده و استدلال مدل را تخریب میکنند. این گزارش چندین نوع زمینه سمی را شناسایی کرده است:
- زمینه منقضیشده (Stale Context): مستندات قدیمی خطرناکتر از نبودِ مستندات هستند. نبودِ داده باعث ایجاد عدم قطعیت و تردید مدل میشود، اما دادهی منقضیشده، مدل را با اطمینان در مسیر اشتباه میبرد. این چالش ما را به این پرسش میرساند که چرا مدلها برای رسیدن به هوشمندی واقعی باید قابلیت فراموش کردن دادههای زائد را داشته باشند. برای مثال، اگر قانونی مربوط به سه ماه پیش بگوید «تمام پرداختها از طریق ارائهدهنده A انجام شود»، اما نیمی از سیستم از آن زمان به ارائهدهنده B منتقل شده باشد، مدل ممکن است با قاطعیت کامل، یک یکپارچهسازی (Integration) غلط را پیاده کند.
- دستورات متناقض (Conflicting Instructions): وقتی یک فایل
AGENTS.mdتقاضا میکند که تمام منطق تجاری در کلاسهای Service باشد، اما یک README پیشنهاد میدهد منطق تجاری را داخل Route Handlerها نگه دارید و یک یادداشت قدیمی از تسکهای قبلی میگوید از افزودن لایههای سرویس جدید اجتناب کنید، عامل باید این تضاد را حل کند. این وضعیت اغلب منجر به ایجاد یک الگوی «ترکیبی» (Blended Pattern) میشود که در هیچکدام از استانداردهای واقعی پروژه وجود ندارد. - نویز نامرتبط (Irrelevant Noise): گنجاندن مستندات سرویس ایمیل، تاریخچه تحلیلها یا لاگهای مهاجرت نامرتبط هنگام رفع باگِ «اعتبارسنجی سبد خرید»، احتمال تمرکز مدل روی ماژولهای غلط را افزایش میدهد.
برای مثال، مورد یک سند معماری قدیمی را در نظر بگیرید. اگر سیستم فعلی از جریان Controller → Service → Repository (با شناسه ixn1f3) استفاده کند، اما یک سند قدیمی هنوز جریان Controller → Data Layer (با شناسه 8ylsl1) را ذکر کرده باشد، عامل دو منبع حقیقت در اختیار دارد. او ممکن است از کد پیروی کند، یا از مستندات، و یا ترکیبی از هر دو را به کار ببرد و در نهایت الگویی بسازد که هرگز در کدبیس واقعی وجود نداشته است.
شکاف توجه و توهم
بزرگ بودن پنجرهٔ زمینه تضمین نمیکند که مدل به هر توکن (Token) — تکههای کوچکی از متن، مثل برشهای یک کیک طولانی که مدل تکهتکه میخورد — توجه یکسانی کند. چالش واقعی این نیست که آیا یک عامل میتواند کل یک مخزن کد را در پرامپت خود جای دهد، بلکه این است که آیا میتواند جزئیات درست را در لحظه درست استخراج کند. وقتی یک پرامپت شامل صدها فایل، لاگهای طولانی و بحثهای قدیمی باشد، استخراج جزئیات حیاتی سختتر میشود.
تعداد زیاد سیگنالهای ناقص میتواند منجر به توهم (Hallucination) شود؛ یعنی وقتی مدل با اطمینان چیزی میگوید که اصلاً وجود ندارد — مثل دوستی که خاطرهای را اشتباه تعریف میکند. اگر عامل ۱۰ ارجاع ناقص به یک رفتار سیستمی ببیند بدون اینکه تصویر کاملی داشته باشد، ممکن است آنها را با هم ترکیب کرده و یک توضیح منطقی اما غلط ارائه دهد. این توضیحات اغلب بسیار مطمئن به نظر میرسند و همین موضوع شناسایی خطا را برای برنامهنویس سختتر میکند.
پیادهسازی «حداقل زمینهٔ کافی»
برای مقابله با این وضعیت، نویسنده پیشنهاد میکند به سمت استراتژی «حداقل زمینهٔ کافی» (Minimum Sufficient Context) حرکت کنیم. هدف این است که فقط اطلاعات لازم برای تصمیمگیری درست به مدل داده شود، نه هر چه در دسترس است. برای رفع باگ اعتبارسنجی سبد خرید، مدل به جریان خرید، قوانین اعتبارسنجی، تستهای مرتبط، مدل داده و محدودیتهای معماری نیاز دارد—نه به تمام کامپوننتهای فرانتاند یا بحثهای قدیمی درباره طراحی.
بهجای تخلیه انبوه دادهها، توسعهدهندگان باید از الگوی «افشای تدریجی» (Progressive Disclosure) استفاده کنند:
- شروع کوچک: ابتدا فقط محدودیتهای اصلی و تسک فوری را ارائه دهید.
- اکتشاف مدلمحور: از عامل بپرسید چه اطلاعاتی نیاز دارد و کدام فایلها احتمالاً مرتبط هستند، پیش از آنکه شروع به نوشتن کد کند. بهطور مشخص این ۴ سوال را بپرسید: ۱) چه اطلاعاتی لازم داری؟ ۲) کدام فایلها احتمالاً مرتبطاند؟ ۳) چه فرضهایی میکنی؟ ۴) چه زمینهای ابهامات را کم میکند؟
- بارگذاری افزایشی: فایلها و مستندات را تنها زمانی اضافه کنید که مدل نیاز به آنها را شناسایی کند. اجازه دهید مدل با پیشرفت در تسک، زمینه بیشتری را «به دست آورد».
معماری مهندسیشده برای زمینه
زمینه باید مانند خودِ کد، به عنوان بخشی از معماری سیستم در نظر گرفته شود و با همان انضباط مهندسی مدیریت شود. چون زمینه بر باورهای مدل و الگوهایی که دنبال میکند اثر میگذارد، نیاز به نظم دارد. این کار مستلزم تقسیم زمینه به دو دسته مجزا است:
- زمینه دائمی (Permanent Context): قوانین کوتاه و تغییرناپذیر درباره استانداردهای کدنویسی، امنیت و قراردادهای نامگذاری. اینها باید ساده باشند تا تبدیل به یک «رمان» نشوند. مثال: «منطق تجاری فقط در سرویسها باشد»، «مخازن (Repositories) فقط مسئولیت پایداری داده را دارند» و «تستها باید رفتارهای تغییریافته را پوشش دهند».
- زمینه تسکمحور (Task Context): دادههای موقت مانند یک گزارش باگ، یک نیازمندی ویژگی (Feature)، یک مجموعه لاگ یا یک گزارش حادثه. اینها فقط برای کار فعلی کاربرد دارند.
علاوه بر این، گزارش اشاره میکند که زمینه باید «چرخه حیات» (Lifecycle) داشته باشد. قوانین موقت مهاجرت، راهکارهای موقت برای حوادث خاص یا رفتارهای منقضیشده API باید تاریخ انقضا داشته باشند. زمینه باید ایجاد، بررسی، بهروزرسانی، منقضی و حذف شود، دقیقاً مانند کد. این رویکرد در واقع پاسخی به این نیاز است که در محیطهای سازمانی، حافظه معنایی لزوماً راهکار بهینهای برای مدیریت دانش عاملها نیست.
شفاف کردن منابع (Sources) عادت حیاتی دیگری است. اطلاعات نباید به صورت یک توده ناشناس ظاهر شوند. با برچسبگذاری منابع — مثلاً «منبع: کد فعلی»، «منبع: AGENTS.md» یا «منبع: حادثه ژوئن» — مدل میتواند وزن حقیقت هر داده را بسنجد. در این حالت، کد فعلی در محیط Production باید وزن بیشتری نسبت به یک سند برنامهریزی دو سال پیش داشته باشد.
گردش کار جدید برای عاملهای AI
گردش کار پیشنهادی، رویکرد «بارگذاری همه چیز» را با یک توالی آگاهانه جایگزین میکند:
۱. تعریف تسک: هدف را بهطور واضح بیان کنید.
۲. ارائه محدودیتهای اصلی: مرزهای ضروری را مشخص کنید.
۳. شناسایی توسط عامل: اجازه دهید مدل زمینههای مورد نیاز را شناسایی کند.
۴. بارگذاری فایلهای مرتبط: فقط دادههای ضروری را وارد کنید.
۵. بررسی تداخلات: از مدل بخواهید قبل از تغییر هر خط کد، زمینه را برای یافتن دستورات متناقض، فرضهای منقضیشده یا منابع نامشخص حقیقت بررسی کند.
۶. اجرا و تایید: تغییرات را بر اساس زمینه کیوریتشده پیاده کنید.
در این مدل جدید، ارزش یک توسعهدهنده دیگر در مهارت مهندسی پرامپت (Prompt Engineering) — هنر سؤال درست پرسیدن، مثل کسی که میداند چطور از یک مشاور باتجربه بهترین جواب را بگیرد — نیست، بلکه در توانایی او برای «کیوریتوری» (Curating) یا مدیریت محیط اطلاعاتی AI است. بهترین پنجرهٔ زمینه، بزرگترین پنجره نیست، بلکه پنجرهای است که کمترین اطلاعات نامرتبط و شفافترین منبع حقیقت را دارد.
گام بعدی شما
- در پرامپتهای بعدی، بهجای پیوست کردن تمام فایلها، ابتدا از مدل بخواهید لیست فایلهای مورد نیازش را بنویسد.
- یک فایل
CONTEXT.mdبرای قوانین دائمی پروژه بسازید و آن را از مستندات موقت جدا کنید. - از مدل بخواهید قبل از هر تغییر بزرگ، «فرضهای زمینهای» خود را لیست کند تا توهمات احتمالی را شناسایی کنید.
اما داستان سختافزاری این تحول حتی شگفتانگیزتر است — به تحلیل ما دربارهی تراشههای Blackwell مراجعه کنید.



گفتگو