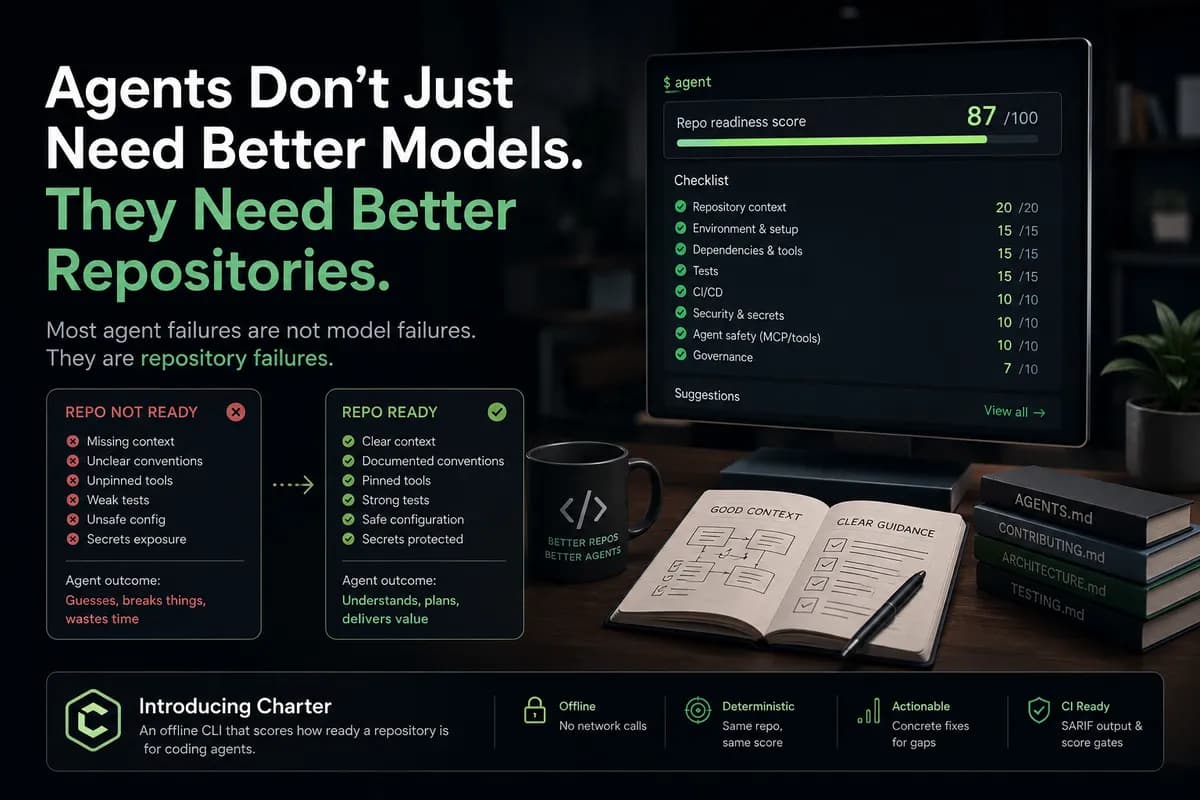
اگر امروز یک عامل هوش مصنوعی برای توسعه کد به پروژه شما وارد شود، احتمالاً در کمتر از یک ساعت با اعتمادبهنفس کامل، کد شما را به جای memperbaiki، خراب میکند. این اتفاق به دلیل ضعف مدل نیست، بلکه به این دلیل است که عاملها در محیطی میافتند که هیچکس برای آنها آماده نکرده است.
طبق تحلیلی فنی که در ۲۳ ژوئن ۲۰۲۶ در وبسایت dev.to منتشر شد، یک مخزن کد (Repository) با ساختار ضعیف، محیطی «سمی» ایجاد میکند که منجر به رفتارهای اشتباه اما با اطمینان بالای هوش مصنوعی میشود. این تحلیل پیشنهاد میکند که وقتی یک عامل هوش مصنوعی شکست میخورد، مقصر لزوماً یک مدل ضعیف نیست، بلکه یک مخزن نامنظم و آشفته است. این دیدگاه با این واقعیت همسو است که مدلهای قدرتمندتر به تنهایی نمیتوانند نقصهای ساختاری محیط کدنویسی را جبران کنند و عاملها همچنان با چالشهای بنیادی روبهرو هستند.
بیشتر بحثهای فعلی حول محور مقایسه مدلها میچرخد؛ برنامهنویسان میپرسند کدام مدل کد تمیزتری مینویسد، کدام یک دستورالعملها را بهتر دنبال میکند یا کدام مدل میتواند مخازن بزرگتر را مدیریت کند. در حالی که این سؤالات اهمیت دارند، اما یک نکته حیاتی را نادیده میگیرند: عاملها اغلب نه به دلیل بد بودن مدل، بلکه به دلیل بد بودن مخزن برای عاملها شکست میخورند. یک عامل کدنویسی در یک فضای انتزاعی و پاکیزه فرود نمیآید، بلکه مستقیماً وارد جزئیات خاص و پیچیده مخزن شما میشود.
همانطور که در تحلیل قبلی ما دربارهی امنیت مدلهای بازمتن اشاره کردیم، بستر دادهای مستقیماً بر خروجی مدل اثر میگذارد. در اینجا، مخزن کد در واقع امتدادی از خودِ پرامپت است.
وقتی یک عامل (Agent) — شبیه دستیاری که دستورات شما را اجرا میکند تا کاری را به سرانجام برساند — شروع به کار میکند، تمام محیط اطراف کد را به ارث میبرد. او فقط منطق برنامه را نمیبیند؛ بلکه ساختار پوشهها، قراردادهای نامگذاری و فایلهای پیکربندی عجیب را هم دریافت میکند. او وارث میانبرها، تناقضات و تصمیمات نیمهکارهای است که در طول زمان انباشته شدهاند. همچنین، او مستندات مفقود، دستورالعملهای راهاندازی قدیمی و مجموعهای از تستها را به ارث میبرد که ممکن است در واقعیت اصلاً اجرا نشوند.
تصور کنید یک مهندس ارشد را استخدام کنید اما هیچ سند راهنمایی، یادداشت معماری، راهنمای مشارکت (Contribution Guide) یا مستندات Onboarding به او ندهید و مجموعات تست را هم خراب تحویل دهید. شما در روز اول آن مهندس را بیکفایت نمینامید، بلکه سیستم ورود به سازمان را سرزنش میکنید. عاملهای هوش مصنوعی دقیقاً با همین مشکل روبهرو هستند، اما سریعتر و با اعتمادبهنفس بیشتری شکست میخورند؛ زیرا آنها برخلاف انسانها، از مزایای تاریخچه پیامهای Slack، حافظه تیمی یا سالها قضاوت انباشته شده برخوردار نیستند.
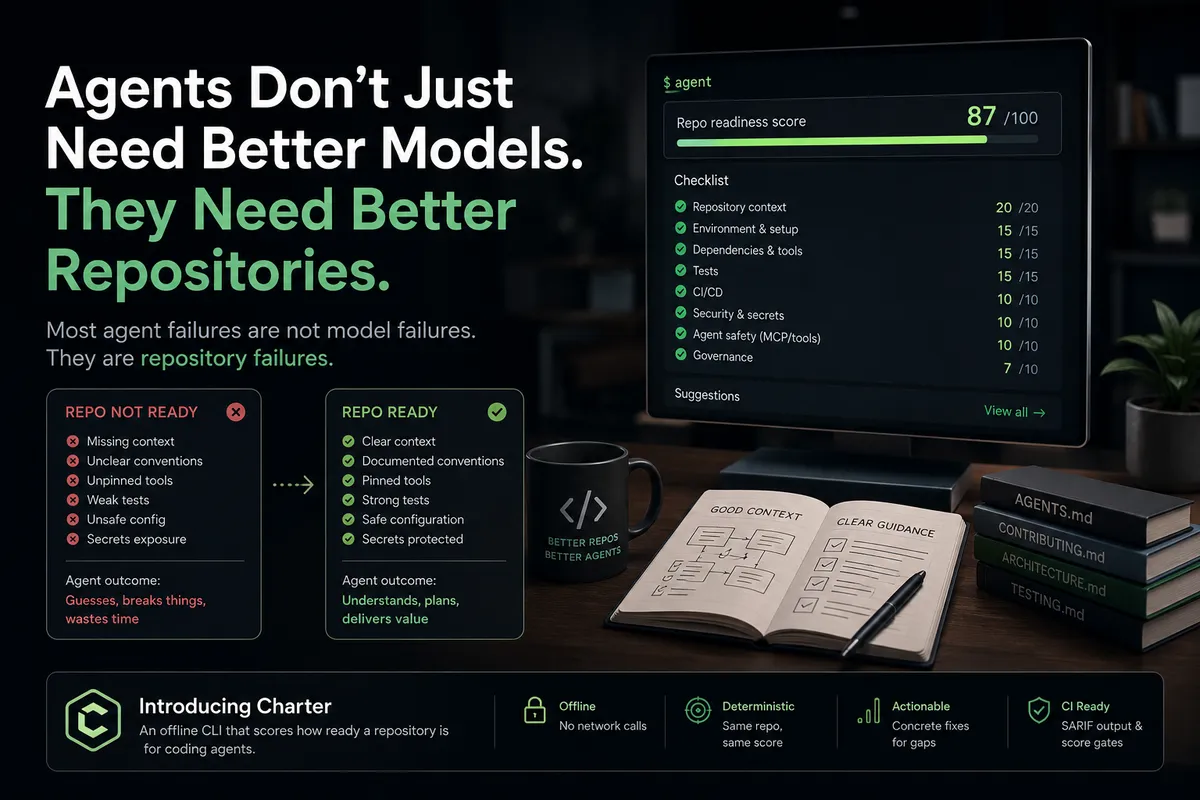
به گزارش این تحلیل، وقتی مخزن کد به درستی آماده نشده باشد، شکستهای عامل در ابتدا شبیه به مشکلات هوشی به نظر میرسند. نمونههای رایج عبارتاند از:
- بازنویسی غیرضروری و بیش از حد بخشهای وسیع کد.
- نادیده گرفتن قراردادهای تثبیتشده در پروژه.
- افزودن وابستگیهایی (Dependencies) که تیم هرگز تأیید نمیکرد.
- ناتوانی در پیدا کردن روش صحیح اجرای تستها.
- تغییر در فایلهایی که احتمالاً باید از آنها دوری میکرد.
- پیروی از دستورالعملهای راهاندازی که تاریخگذشته و منسوخ شدهاند.
- ایجاد تغییراتی که منطقی به نظر میرسند اما با سازوکار واقعی عملکرد مخزن همخوانی ندارند.
نویسنده مقاله استدلال میکند که «عامل-پذیری» (Agent-readiness) باید به یک معیار اندازهگیری تبدیل شود، درست مثل روشی که تیمها نرخ پوشش تستها یا خطاهای Linter را ردیابی میکنند. وقتی در مخزن یک فایل AGENTS.md یا قراردادهای صریح پروژه وجود ندارد، عامل مجبور به حدس زدن میشود. این منجر به چرخهای میشود که در آن توسعهدهندگان، مدل زبانی بزرگ (LLM) — مثل کتابخانهداری که میلیاردها صفحه را خوانده و حالا با همان لحن جواب میدهد — را برای خطاهایی سرزنش میکنند که در واقع ناشی از دستورالعملهای تاریخگذشته یا اسرار (Secrets) محافظتنشده است. برای جلوگیری از این چرخههای شکست، برخی رویکردها مانند چارچوب Agent Rigor سعی دارند با ایجاد سلسلهمراتب دستوری جلوی توهمات و خطاهای تکراری عاملها را بگیرند.
برای حل این مشکل، یک گردشکار «خستهکننده» اما مؤثر پیشنهاد شده است. هدف این است که از حالتی که در آن به عامل یک وظیفه مبهم داده میشود و او باید مخزنی را که به سختی میفهمد تغییر دهد، فاصله بگیریم. در عوض، مخزن باید «نردههایی» فراهم کند تا عامل بتواند تغییرات محدود و کراندار ایجاد کند، بررسیها را اجرا نماید و اقدامات خود را توضیح دهد.
یک گردشکار باکیفیت برای عاملها نیازمند موارد زیر است:
- مستندات: یک فایل راهنمای صریح مانند AGENTS.md یا فایل دستورالعمل معادل.
- راهاندازی قطعی: مراحل مستند شده برای راهاندازی و تثبیت نسخههای ابزارها.
- تأیید: دستورات تست واضح و سیستم CI که بازخوردهای مفید و کاربردی ارائه میدهد.
- حاکمیت: قراردادهای شفاف پروژه و مرزهای امن برای مدیریت اسرار و فایلهای پیکربندی.
- زمینه: اطلاعات صریح کافی تا عامل بفهمد تعریف کد «خوب» در این پروژه چیست.
ما هماکنون کیفیت نرمافزار را با وضعیت Build یا اسکن اسرار میسنجیم. اما عامل-پذیری معمولاً با جملات مبهمی توصیف میشود؛ مثلاً «Claude Code اینجا مشکل دارد» یا «Cursor در این مخزن خوب است اما در آن یکی بد». برای عملیاتی کردن این موضوع، نویسنده سؤالات تکرارپذیر زیر را پیشنهاد میکند:
- آیا مخزن قراردادهای خود را توضیح میدهد؟
- آیا عامل میتواند مسیر درست راهاندازی را پیدا کند؟
- آیا دستورات خطرناک مستند یا ایزوله شدهاند؟
- آیا زمینه پروژه برای جلوگیری از حدسهای گسترده کافی است؟
- آیا این موارد در CI به صورت مکرر و همزمان با تغییرات مخزن بررسی میشوند؟
در اینجاست که ابزار Charter وارد میشود. این ابزار خط فرمان (CLI) متنباز، عامل-پذیری را از مشاهدات مبهم به دادههای عملیاتی تبدیل میکند. Charter با انجام یک ممیزی آفلاین، امتیاز آمادگی قطعی از ۰ تا ۱۰۰ را ارائه میدهد. این ابزار بخشهای زیر را بررسی میکند:
- زمینه و حاکمیت (Context and Governance)
- امنیت اسرار و ایمنی ابزارهای MCP/Tool
- راهاندازی محیط (Environment setup)
- تستها و CI
این ابزار از امتیازدهی توسط مدلهای زبانی و تماسهای شبکه اجتناب میکند تا تضمین شود یک مخزن همیشه امتیاز یکسانی میگیرد. این روند به تیمها اجازه میدهد شکافهای عینی را که باعث احتمال شکست عاملها میشود، شناسایی کنند.
این تغییر، نشاندهنده یک گذار در ابزارهای توسعه است. تمرکز از افزایش پنجره زمینه (Context Window) — میزان متنی که مدل همزمان در ذهن نگه میدارد، شبیه میز کاری که فقط جای چند ورق دارد — یا اصلاح رابطهای گفتگو، به سمت سیستمهایی در سطح مخزن میرود که کدبیسها را برای کارهای عاملمحور ذاتاً ایمنتر میکنند. این به معنای پیشفرضهای بهتر، مرزهای اتوماسیون امنتر و حاکمیت صریحتر در مورد کارهایی است که عاملها میتوانند یا نمیتوانند انجام دهند.
برای توسعهدهندگان، این بدان معناست که آینده نه در جایگزینی مهندسان توسط عاملها، بلکه در بازطراحی گردشکارهای سازگار با آنهاست. عاملها میتوانند بازسازی کد (Refactor)، مهاجرتها، تحقیقات و کارهای تکراری پیادهسازی را انجام دهند، اما فقط اگر گردشکار برای آنها طراحی شده باشد. چون عاملها فاقد «دانش جمعی» (Tribal Knowledge) هستند، این زمینه باید صریحاً در ساختار مخزن نوشته شود.
اگر عاملهای شما مدام شکست میخورند، احتمالاً مشکل از مخزن است. مدلهای بهتر در نهایت استدلالهای دقیقتری خواهند داشت و اشتباهات کمتری میکنند، اما همچنان محیطی را به ارث میبرند که ما به آنها میدهیم. اگر مخزن گیجکننده و بدون مستندات باشد، حتی قدرتمندترین مدلها هم میتوانند اوضاع را بدتر کنند. مدل اهمیت دارد، اما مخزن هم به همان اندازه اهمیت دارد.
گام بعدی شما
- بررسی کنید آیا مخزن پروژه شما دارای یک فایل راهنمای صریح برای هوش مصنوعی (مانند AGENTS.md) است یا خیر.
- از ابزارهای ممیزی مانند Charter برای سنجش سطح پذیرش عاملها در کدبیس خود استفاده کنید.
- فرآیند Onboarding کد خود را برای یک انسان تازهوارد ساده کنید؛ این دقیقاً همان کاری است که برای موفقیت عاملها نیاز دارید.
اما داستان سختافزاری این تحول حتی شگفتانگیزتر است — به تحلیل ما درباره تراشههای Blackwell مراجعه کنید.



گفتگو