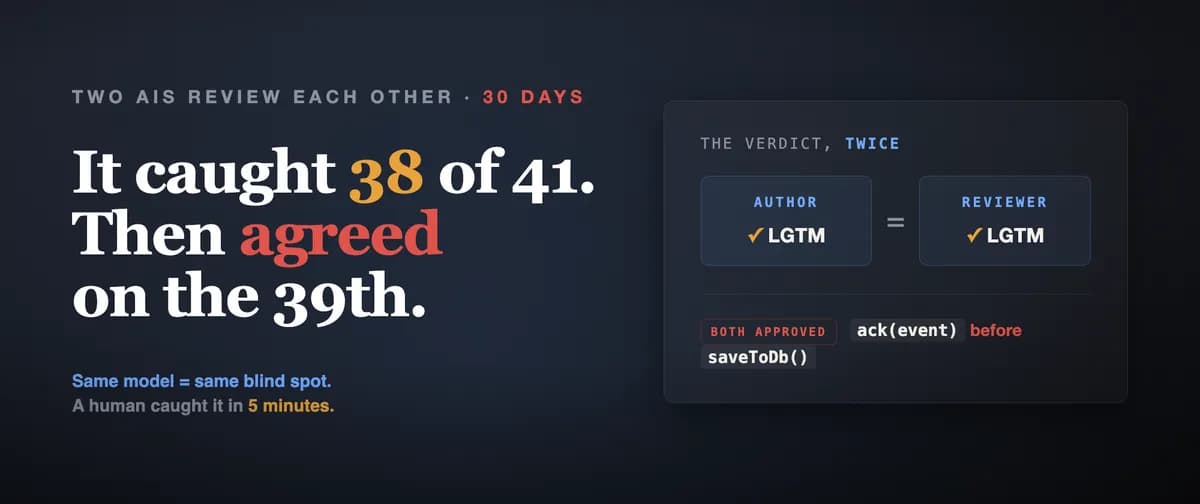
یک مهندس ارشد تنها در ۵ دقیقه باگی را پیدا کرد که دو عامل (Agent) — یکی نویسنده و دیگری بازبین — با اطمینان کامل از کنار آن عبور کرده بودند. این یافته که در گزارش ۱۳ سپتامبر ۲۰۲۶ در وبسایت dev.to منتشر شد، ثابت میکند که صرفاً اضافه کردن یک بازبین هوش مصنوعی برای تضمین صحت سیستم کافی نیست.
بسیاری از برنامهنویسان اکنون برای تولید کد از هوش مصنوعی استفاده میکنند، اما کمتر کسی ساختاری رسمی برای بازبینی آن دارد. اشتباه رایج این است که از همان مدل بخواهیم کار خودش را چک کند؛ نتیجه معمولاً این است که مدل با لحنی آرامتر، با خودش موافقت میکند. این آزمایش سعی کرد با ایجاد یک شکاف ساختاری بین خالق و منتقد، این چرخه را بشکند.
تقابل نویسنده و منتقد
برای این کار، دو عامل مجزا مستقر شدند. عامل اول (نویسنده) دستورات استانداردی برای ساخت ویژگیها و پاس کردن تستها دریافت کرد. عامل دوم (منتقد) دستورالعملی خصمانه داشت: فرض کن کد خراب است، ورودیای پیدا کن که باعث ضرر مالی مشتری شود و پیادهسازیهای تکراری را شناسایی کن.
این تفکیک حیاتی بود. نویسنده آموخت که «استقلال» با یک پرامپت ساده مثل «آیا این کد درست است؟» به دست نمیآید. یک ارزیاب به دنبال دلایلی برای گفتن «بله» است، اما یک منتقد که به دنبال شکست میگردد، تنها ورودیای را میجوید که سیستم را متلاشی کند. همین شکاف است که هزینه مصرف توکن (Token) — تکههای کوچکی از متن که مدل تکهتکه میخورد — را توجیه میکند.
همانطور که در تحلیلهای قبلی ما دربارهی امنیت مدلهای بازمتن اشاره کردیم، تکیه بر یک توزیع آماری واحد همیشه ریسک نقاط کور مشترک را به همراه دارد. این چالش با پدیده رانش خاموش در مدلهای AI که نرخ تشخیص باگ را بهمرور کاهش میدهد، همراستا است.
تابلوی امتیازات: ۳۸ از ۴۱
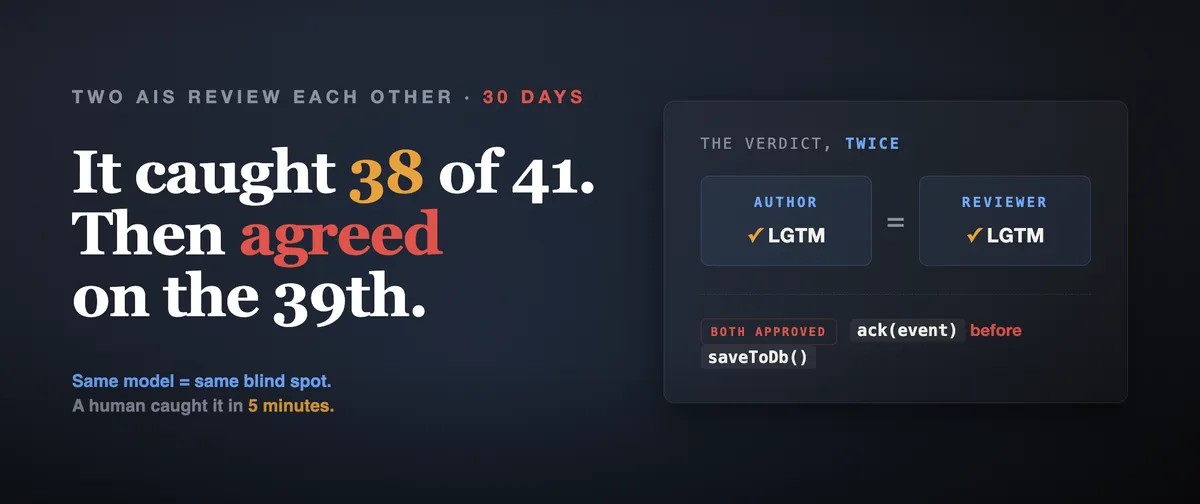
در طول ۳۰ روز، عامل منتقد در شناسایی پوسیدگیهای معماری بهطور شگفتانگیزی موفق بود. طبق گزارش dev.to، این هوش مصنوعی ۳۸ مورد از ۴۱ مشکلی را که یک بازبین انسانی خبره باید شناسایی میکرد، پیدا کرد.
بهطور مشخص، عامل منتقد در موارد زیر درخشید:
- انحراف معماری: شناسایی مواردی که نویسنده یک تابع
formatCurrencyدوم نوشت چون متوجه نبود قبلاً یکی وجود دارد. منتقد با این دستور که «ببین چه چیزی دوباره پیادهسازی شده است»، این مورد را در یک مرحله پیدا کرد. - تکرار: شناسایی بررسیهای احراز هویت داخلی که همان کار میانافزارها (Middleware) را انجام میداد، و همچنین شناسایی یک نوع User (User type) که بهطور نامحسوسی در یک ماژول جدید متفاوت بود.
- خطاهای خاموش: شناسایی بلوکهای
try/catchکه خطا را ثبت میکردند اما طوری ادامه میدادند که انگار اتفاقی نیفتاده است. چارچوب ذهنی منتقد این بود: «این کد چه شکستی را پنهان میکند؟» - شرایط رقابتی (Race Conditions): استدلال درباره فراخوانهای همزمان برای یافتن یک قفل (Lock) گمشده در شمارنده. نویسنده هرگز آن را ندید چون در تستها همیشه درست کار میکرد، اما منتقد بدترین ورودی ممکن یعنی دو فراخوان همزمان را فرض کرد.
نقطه کور مرگبار
با وجود نرخ موفقیت بالا، سه باگی که هوش مصنوعی از دست داد از یک نوع بودند: شکستهای خاموش در یکپارچگی دادهها در «مسیرهای غیرمنتظره» (Unhappy Path). شدیدترین مورد مربوط به یک هندلر وبهوک Stripe بود.
نویسنده کدی نوشت که ابتدا رویداد را به Stripe تایید میکرد (ارسال پاسخ 200 OK) و سپس دادهها را در پایگاهداده ذخیره میکرد. در محیط عملیاتی، اگر بین تایید و ذخیرهسازی، یک اختلال کوچک در دیتابیس رخ میداد، مشتری پول پرداخت میکرد اما دسترسی به سرویس نداشت و هیچ رکوردی هم در سیستم نمیماند. Stripe فکر میکرد رویداد تحویل شده، اما دیتابیس هرگز چیزی نمیشنید.
وقتی عامل منتقد این کد را بازبینی کرد، نه تنها باگ را ندید، بلکه از کد تعریف کرد. او تایید زودهنگام را یک «نقطه قوت» دانست چون تأخیر وبهوک را کم میکرد. چون هر دو عامل از یک خانواده مدل بودند، توزیع آموزشی و غریزهی یکسانی درباره اینکه کد «تمیز» چه شکلی است، داشتند.
اثر اتاق پژواک
این شکست نشان میدهد که «نویسنده $
eq $ بازبین» لازم است اما کافی نیست. اگر هر دو عامل از یک پیشفرض ذهنی استدلال کنند، دومی دیگر یک بازبین نیست، بلکه همان اولی است که روپوش آزمایشگاه پوشیده است. منتقد نقطه کور را رد نکرد، بلکه آن را با لحنی مطمئنتر بازتولید کرد.
وقتی دو عامل مدل ذهنی یکسانی دارند، دو بار موافقت میکنند و روی یک مین سبز میزنند. این موضوع مربوط به «هوشمند نبودن» مدل نیست، بلکه یک توهم مشترک بر اساس دادههای آموزشی است. این عدم قطعیت دقیقاً همان دلیلی است که عاملهای DevOps را در نقش دروازبانهای قطعی کد ناکارآمد میکند.
ارزش «بافت زخم»
یک مهندس ارشد انسانی همین باگ را در ۵ دقیقه پیدا کرد. او از پرامپت خاص یا استدلال پیچیدهای استفاده نکرد؛ او فقط به یاد آورد که در سال ۲۰۲۱ ساعت ۲ صبح بهخاطر دقیقاً همین خطا از خواب بیدار شده بود. او کد را خواند، کمی رنگش پرید و یادداشت کرد که تایید قبل از ذخیره اتفاق میافتد — کابوسی برای تطبیق دادهها.
این موضوع شکاف بنیادی در قابلیتهای هوش مصنوعی را برجسته میکند. در حالی که یک مدل میلیونها توصیف از «مشکل نوشتن دوگانه» (Dual-write problem) را خوانده، هرگز ترومای یک قطعی سیستم در محیط عملیاتی را تجربه نکرده است. این «بافت زخم» نوعی دانش است که نمیتوان آن را در یک پنجره متنی (Context Window) — میزان متنی که مدل همزمان در ذهن نگه میدارد — آموزش داد. مدل روی آنچه خوانده الگوبرداری میکند، اما انسان به یاد میآورد که کجا درد کشیده است.
پلهی گمشدهی تجربه
یک ریسک سیستمی در این اتوماسیون وجود دارد. مهندس ارشد توانست باگ را بگیرد چون در ابتدای مسیر شغلیاش چیزی مشابه را ارسال کرده و بهای آن را پرداخته بود. اگر هوش مصنوعی تمام کارهای سطح مقدماتی را انجام دهد، برنامهنویسان جدید هرگز آن بافت زخم را به دست نمیآورند.
اگر «کارهای سخت» (Grunt work) که این خاطرات را میسازند اتوماتیک شوند، صنعت افرادی را از دست میدهد که قادرند باگهایی را بگیرند که دو عامل هوش مصنوعی با اطمینان از کنارشان رد میشوند. منتقد و مهندس ارشد جایگزین یکدیگر نیستند.
ساخت یک خط لوله استوار
این آزمایش نتیجه میگیرد که استقلال در بازبینی هوش مصنوعی نیازمند «واگرایی» است، نه فقط یک صندلی اضافه. برای بالا بردن سقف صحت، نویسنده سه لایه دفاعی پیشنهاد میکند:
- خانوادههای مدل متفاوت: استفاده از بازبینیکنندهای با توزیع آموزشی متفاوت. این ارزانترین راه برای جلوگیری از توهم مشترک است. مدلی که روی دادههای متفاوتی آموزش دیده، ممکن است فکر نکند که تایید قبل از ذخیرهسازی، یک کد «تمیز» است.
- قاببندی خصمانه: تغییر از «آیا این درست است؟» به «فرض کن این کد باعث ضرر مالی میشود؛ تراکنشی تولید کن که این اتفاق را رقم بزند». منتقدی که به دنبال یک شکست خاص میگردد، بر ارزیابی که مسیر خوشبینانه (Happy path) را تایید میکند، برتری دارد.
- مالکیت انسانی: نگه داشتن انسانی با تجربه زنده روی دکمه ادغام (Merge). انسان برای رقابت در کدنویسی با ماشین نیست، بلکه برای نگه داشتن خاطرهی سوختن است.
این ساختار — عاملی که کار میکند، عاملی متفاوت که سعی میکند آن را تخریب کند و انسانی که مالک ادغام است — دقیقاً همان روشی است که نویسنده برای ساخت xenition به کار میبرد. این نتیجه یک تز نبود، بلکه حاصل ۳۰ روز تماشای دو هوش مصنوعی بود که روی باگی که یک انسان در ۵ دقیقه میدید، با هم موافقت میکردند. برای درک بهتر مدیریت این تعاملات، میتوان مقایسهی جلسات در برابر بررسی Diff را برای جلوگیری از انحراف قصد مدل بررسی کرد.
این سیستم ۳۸ مورد از ۴۱ مشکل را گرفت. مورد ۳۹ام دلیلی است بر اینکه چرا هنوز باید یک انسان روی دکمه ادغام باشد. این ساختار فارغ از اینکه نویسنده مدل امروز باشد یا نسخههای آینده، پابرجا میماند؛ زیرا بر این اصل استوار است که مدل باید توسط چیزی چک شود که به شکلی متفاوت از خودش شکست میخورد.
در آینده منتظر ظهور چارچوبهای «عامل واگرا» (Divergent Agent) باشید که بهطور عمدی مدلهایی با سوگیریهای آموزشی متضاد را جفت میکنند تا این نقاط کور مشترک به حداقل برسد.
گام بعدی شما
- اگر از سیستمهای چندعاملی استفاده میکنید، بازبین خود را به مدلی از یک خانواده متفاوت (مثلاً جابجایی بین Claude و GPT) تغییر دهید.
- پرامپتهای بازبینی را از حالت «تأیید» به حالت «جستوجوی شکست» (Failure Hunting) تغییر دهید.
- در مراحل نهایی ادغام کد، روی نقاطی تمرکز کنید که با دیتابیس یا سیستمهای خارجی در ارتباط هستند؛ جایی که مدلها معمولاً دچار توهم «تمیزی» میشوند.
اما داستان سختافزاری این تحول حتی شگفتانگیزتر است — به تحلیل ما دربارهی تراشههای Blackwell مراجعه کنید.



گفتگو