تصور کنید ساعتی را صرف نوشتن یک پرامپت ساده میکنید و در عرض چند ثانیه، یک سیستم کامل تحویل میگیرید که در ظاهر بینقص است، اما در عمل دقیقاً همان چیزی نیست که نیاز داشتید. حالا باید وارد چرخهای بیپایان از اصلاحات شوید تا مدل را به هدف واقعی برسانید؛ این یعنی شما تبدیل به یک «اوراکل» یا داور انسانی شدهاید که باید هر خط کد را بررسی کند تا بفهمد کجا اشتباه شده است. شما خروجی را بازبینی میکنید، نیت خود را شفافتر میکنید، درخواست تغییر میدهید، تستها را دوباره اجرا میکنید و سپس شکاف بعدی را پیدا میکنید، تا دوباره همین چرخه را تکرار کنید.
این پدیده که Vibe Coding (کدنویسی بر اساس حس و حال) نامیده میشود، در واقع مالیات پنهانی است که بابت نیازمندیهای مبهم در عصر عاملهای هوش مصنوعی پرداخت میکنید. این چرخه وسوسهانگیز است زیرا پرامپت اولیه ارزان به نظر میرسد، اما هزینه واقعی اصلاحات تکراری را پنهان میکند. این موضوع ثابت میکند که ابهام در تعریف نیازمندیها، منجر به توسعه چابک یا کمهزینه نمیشود.
O'Reilly در راهنمای کاربردی خود که در ۲۱ اوت ۲۰۲۶ منتشر شد، این تغییر در دینامیک مهندسی را با جزئیات شرح داد. مشکل اصلی این است که عاملها پیادهسازی را بسیار ارزانتر و سریعتر میکنند؛ به این معنا که یک ایده با تعریف ناقص میتواند پیش از آنکه کسی روی هدف واقعی سیستم توافق کند، به یک سیستم با ظاهر پذیرفتنی تبدیل شود. مهندسی نرمافزار هرگز عمدتاً درباره تایپ کردن یا تولید کد نبود، بلکه درباره تصمیمگیری در مورد این بود که چه چیزی باید وجود داشته باشد، چه اتفاقی هرگز نباید بیفتد، کدام سبکسنگین کردنها (Trade-offs) اهمیت دارند و معنای «پایان کار» زمانی که مسئله با دنیای واقعی برخورد میکند چیست.
در مهندسی سنتی، نیازمندیهای مبهم توسط کندی انسانها مهار میشدند. سالها بود که تیمها نقصهای مشخصات را از طریق اصطکاک انسانی کشف میکردند: یک بازبین متوجه یک مورد خاص (Edge Case) میشد، تیم QA مسیری را پیدا میکرد که هیچکس توصیف نکرده بود، یا یک مهندس ارشد نیازمندیها را جلسه به جلسه ترجمه میکرد. هیچکدام از اینها ظریف نبودند، اما ابهام را مجبور به آشکار شدن میکردند. اما اکنون، همان نیازمندیهای مبهم با سرعت ماشین پیش میروند و شکافی ایجاد میکنند که در آن دشواری کار از «نوشتن کد» به «تعریف صحت» و «بررسی قابلاعتماد» منتقل شده است. برای مدیریت این چالش، استفاده از متدهای توسعه مبتنی بر مشخصات (Spec-driven) میتواند از انحراف عاملها در طول مسیر کدنویسی جلوگیری کند.
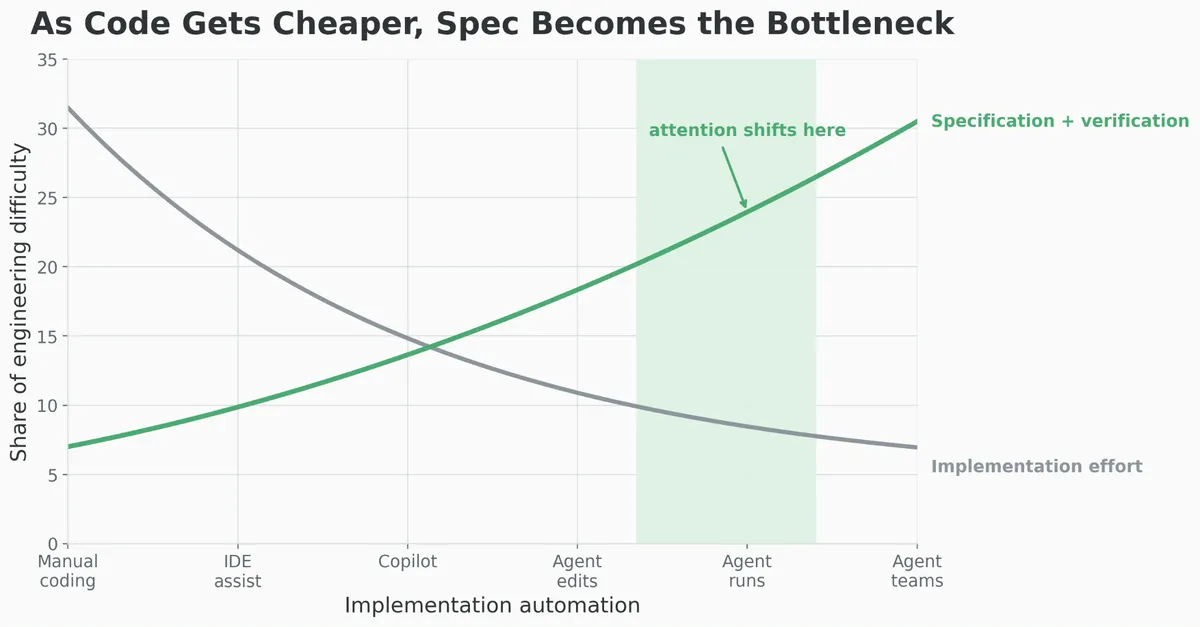
هزینهٔ «داور انسانی»
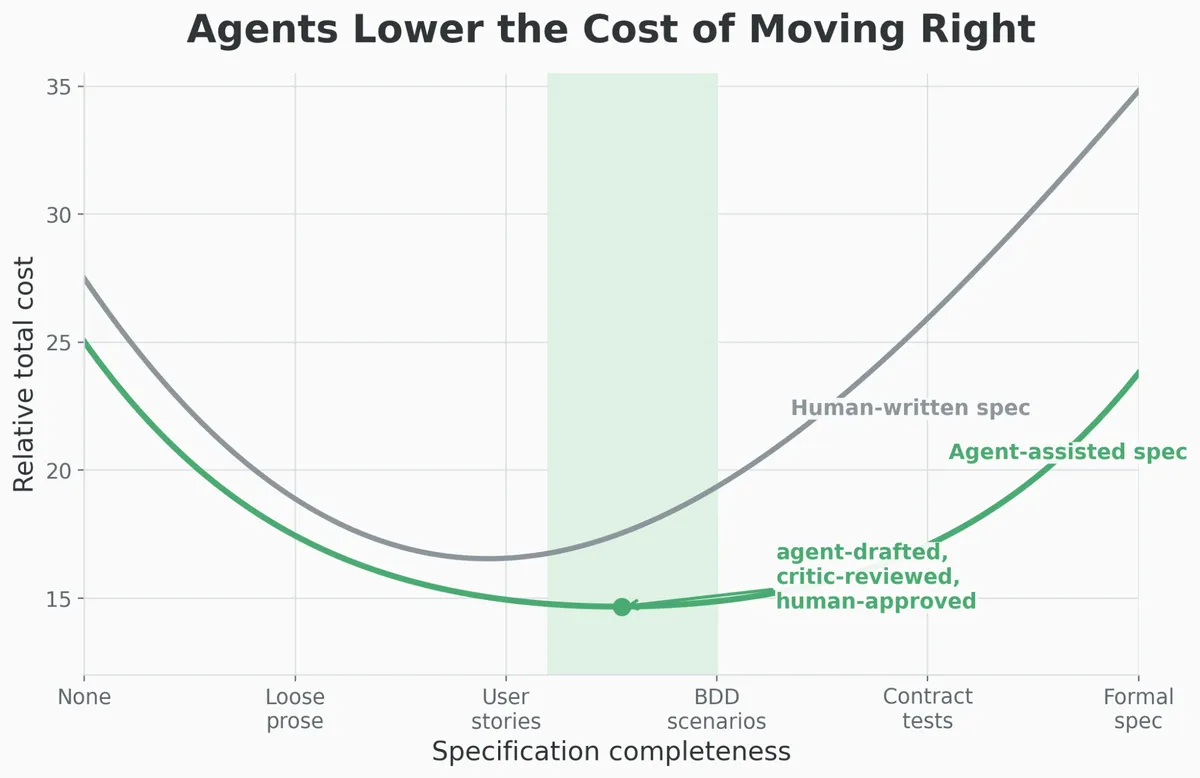
یک موازنه بنیادی بین تعریف دقیق اولیه (Upfront Specification) و اصلاحات پاییندستی وجود دارد. سؤال این نیست که آیا تعریف دقیق خوب است یا بد، بلکه سؤال این است که حداقل هزینه کل در کجا قرار دارد. برای اکثر کارهای عاملمحور، این نقطه در وسط قرار دارد: ساختاری کافی برای محدود کردن دامنه کار، مثالهای ملموس برای شفاف کردن نیت و بررسیهای اجرایی کافی تا بازبینی تبدیل به حدسزدن نشود.
توسعه با مستندات ضعیف (Low-spec) در ابتدا ارزان به نظر میرسد چون اجازه میدهد پیادهسازی فوراً شروع شود، اما هزینه بلندمدت بازبینی و تستهای مکرر را پنهان میکند. در مقابل، مستندات رسمی — مانند معیارهای پذیرش (Acceptance Criteria)، تستهای قراردادی (Contract Tests) یا سناریوهای توسعه رفتار-محور (BDD) — در ابتدا تلاش بیشتری میطلبند. با این حال، آنها نقش «داور» را از یک انسان خسته به یک تست اجرایی منتقل میکنند. یک تست هر بار یک شرط واحد را بررسی میکند؛ او خسته نمیشود، عجول نیست و پنج دقیقه قبل از ناهار، خوشبین نمیشود.
اعتبارسنجی مستندات
نوشتن مستندات کافی نیست؛ خودِ این مستندات به یک فرآیند بازبینی سختگیرانه نیاز دارند. این همان مرحله گرانقیمتی است که مردم اغلب از آن میپرند. آنها توالی کار را ساده میبینند: مستندات را بنویس و سپس اجازه بده عامل آن را پیاده کند. اما مستندات نیاز به بازبینی دارند زیرا حتی دقیقترین مشخصات نیز میتوانند به روشهای آشنایی شکست بخورند:
- تناقضات داخلی: مستندات ممکن است در بخشهای مختلف با یکدیگر در تضاد باشند.
- سوگیری مسیر ایدهآل (Happy Path Bias): ممکن است جریان ایدهآل را پوشش دهد اما درباره تلاشهای مجدد (Retries)، محدودیتهای نرخ درخواست (Rate Limits) یا شکستهای جزئی چیزی نگوید.
- رفتارهای غیرقابل تایید: ممکن است رفتاری را توصیف کند که دقیق به نظر میرسد اما در واقع توسط هیچ تستی قابل تایید نیست.
- شکاف نیت: ممکن است به روشی غلط دقیق باشد؛ یعنی آنچه نویسنده نوشته است را بیان کند، نه آنچه واقعاً در ذهن داشته است.
وقتی یک عامل، مستنداتی معیوب را با وفاداری کامل اجرا میکند، تشخیص خطا سختتر میشود چون کد منسجم به نظر میرسد و حتی ممکن است تستهای ارائه شده را پاس کند. مشکل در لایههای بالادستی استدلال نهفته است و توسعهدهنده را مجبور میکند کد و منطق را بهطور همزمان بازسازی کند. بنابراین، اعتبارسنجی مستندات باید یک ردیف مجزا در برنامه پروژه داشته باشد. پیش از شروع پیادهسازی، کسی باید بپرسد: آیا این مستندات از نظر داخلی سازگار است؟ آیا به اندازه کافی کامل است؟ کدام بخشها قابل تست هستند؟ کجا هنوز به قضاوت انسانی وابسته هستیم؟ کدام حالتهای شکست حذف شدهاند چون همه بهطور ضمنی فرض کردند آنها اتفاق نمیافتند؟
برای حل این مشکل، O'Reilly یک گردشکار اعتبارسنجی دو-عاملی را پیشنهاد میکند:
- عامل اول (طراح): بهجای پرامپتهای کلی «نیازمندیها را بنویس» — که معمولاً «مهِ صیقلخورده» تولید میکنند — از یک پرامپت خاص استفاده کنید: «کوچکترین مستنداتی را بنویس که یک عامل دیگر بتواند با ایمنی کامل آن را اجرا کند. شامل پیشفرضها، اهداف منفی (Non-goals)، معیارهای پذیرش، موارد خاص (Edge Cases)، نتایج قابل مشاهده و سؤالات باز. مشخص کن کدام ادعاها میتوانند به تستهای خودکار تبدیل شوند و کدامها هنوز نیاز به بازبینی انسانی دارند.»
- عامل دوم (حمله کننده): این پیشنویس را به عامل دیگری بدهید و به او بگویید نتیجه را مورد حمله قرار دهد. او باید تناقضات، اصطلاحات مبهم، وابستگیهای پنهان، ادعاهای غیرقابل تست، حالتهای شکست حذف شده و نقاطی را پیدا کند که در آن پیادهسازی میتواند معیارهای مکتوب را پاس کند اما همچنان نیت واقعی را نقض کند.
رانش تفسیری در سامانههای چندعاملی
در حالی که یک عامل در یک وظیفه محدود میتواند از دستورات سست ریکاوری کند (چون حلقه بازخورد تنگ است و اثر تخریبی محلی است)، سامانههای چندعاملی (Multi-Agent Systems) پدیدهای به نام «رانش تفسیری» (Interpretive Drift) را معرفی میکنند. در یک ساختار تک-عاملی، انسان معمولاً میتواند مدل را هنگام انحراف به مسیر برگرداند چون انحراف بهراحتی قابل تشخیص است.
اما وقتی خروجی یک عامل تبدیل به ورودی عامل دیگر میشود، این رانش تشدید میشود. عامل B نمیداند که عامل A یک نیازمندی را ۱۰٪ اشتباه فهمیده است؛ او صرفاً خروجی را به عنوان حقیقت مطلق (Ground Truth) میپذیرد و ادامه میدهد. تا زمانی که انسان نتیجه نهایی را بازبینی کند، خطای اولیه اغلب زیر لایههایی از کارهای با ظاهر حرفهای دفن شده است. در این خط لولهها، مستندات دیگر صرفاً یک راهنما نیستند، بلکه یک «قرارداد» هستند.
این قرارداد به چیزی بیش از یک پاراگراف بیان نیت نیاز دارد و مستلزم موارد زیر است:
- اسکیماها و ناورداهای سختگیرانه: تعریف دقیق اینکه دادهها باید دقیقاً چگونه باشند.
- قوانین اعتبارسنجی صریح: مرزهای روشن برای آنچه قابل پذیرش است.
- فرمتهای تحویل ماشینخوان: اطمینان از اینکه انتقال بین عاملها خودش یک محصول است. تحویل داده بخشی از محصول است که شاید کمتر از آنچه امیدوار بودیم جذاب باشد، اما به واقعیت نزدیکتر است.
- اینترفیسهای تایپشده و تستهای قراردادی: تبدیل داور انسانی به چیزی تکرارپذیر. وقتی رفتار به اندازه کافی پایدار است که بتوان آن را دقیقاً مشخص کرد، یک مستند اجرایی اغلب ارزانتر از یک دور بازبینی انسانی است.
خطر بیشازحد توصیف کردن
متن بیشتر همیشه به معنای امنیت بیشتر نیست. مدلهای فعلی دچار «پوسیدگی زمینه» (Context Rot) میشوند؛ پدیدهای که توسط کارهای Chroma برجسته شد، جایی که عملکرد مدل با رشد ورودی غیرقابلاعتمادتر میشود، حتی در کارهای ساده. در کدنویسی، این موضوع به شکل «رانش دستورات خودساخته» ظاهر میشود.
وقتی پنجرهٔ زمینه (Context Window) با متون قدیمی طراحی، تیکتهای منقضیشده، برنامههای تولید شده از سه جلسه قبل و مثالهای قدیمی پر شود، مدل شروع به میانگینگیری از منابع متضاد حقیقت میکند. ممکن است با یک سند طراحی قدیمی مواجه شود که کلاسهایی را توصیف میکند که دیگر وجود ندارند. در این نقطه، مدل دیگر یک مستند را نمیخواند، بلکه در حال میانگینگیری از منابع متضاد است و دیگر نمیتواند بین یک نیازمندی فعال، یک یادداشت تاریخی یا چیزی که کد قبلاً جایگزین کرده است، تفاوت قائل شود. در این راستا، جایگزینی دستورالعملهای انتزاعی با مراجع واقعی از محیط تولید راهکاری موثر برای کاهش خطاهای ناشی از ابهام در دستورات است.
برای جلوگیری از این اتفاق، اسناد طراحی باید با تکامل پروژه کوچک شوند. وقتی اینترفیسها، تستها و ناورداها واقعی شدند، برنامه مفصل ساخت باید ناپدید شود. شما باید متونی را که صرفاً آنچه کلاسها و متدها انجام میدهند را تکرار میکنند، حذف کنید. فقط بخشهایی را نگه دارید که کد نمیتواند به تنهایی بیان کند:
- منطق کسبوکار (Business Rationale)
- اهداف منفی (Non-goals)
- محدودیتهای ایمنی
- قراردادهای خارجی
- ناورداهای حیاتی (آنهایی که نمیخواهید از طریق آزمون و خطا دوباره کشف شوند)
در غیر این صورت، شما با دو مستند مواجه میشوید. انسانها در بازبینی از این موضوع شکایت خواهند کرد و عاملها اغلب سعی میکنند از هر دو پیروی کنند.
طراحی API سازگار با هوش مصنوعی
کد میتواند به عنوان مستندات خودش عمل کند اگر API برای «کشفپذیری» (Discoverability) طراحی شده باشد. اگر یک API داخلی رفتار را پشت قراردادهای ضمنی، پارامترهای با تایپ ضعیف، جادوی تنظیمات (Setup Magic) و خطاهای کلی پنهان کند، یک عامل نمیتواند با کد به عنوان مستند برخورد کند. او مجبور میشود قوانین را از متون پراکنده و آزمون و خطا بازسازی کند، که برای انسانها کند و برای مدلها بدتر است.
یک API سازگار با هوش مصنوعی از نامهای صریح، متدهای متناسب با وظیفه (Task-level)، تایپهای قوی و پیامهای خطای عملیاتی استفاده میکند. این به عامل اجازه میدهد تا کدبیس را به عنوان مستند معتبر در نظر بگیرد و نیاز به کشاندن حجم عظیمی از متن به پنجره زمینه را کاهش دهد. اصول کلیدی عبارتند از:
- کشفپذیری صریح: غلبه بر قراردادهای ضمنی با شفافیت.
- متدهای همراستا با وظیفه: همراستا کردن متدها با وظایف واقعی بهجای مجبور کردن عامل به طی کردن دهها مرحله شکننده.
- اعتبارسنجی ورودی: استفاده از تایپها برای نشان دادن اینکه ورودی مجاز چگونه است.
- خطاهای عملیاتی: اشاره به راه حل بعدی بهجای اعلام صرف شکست.
- شفافیت در عملکرد: ارائه سرنخهایی درباره فراخوانیهای گرانقیمت تا عامل یک حلقه تکرار درست اما وحشتناک دور یک فراخوانی گران بنویسد.
این موضوع نه تنها برای SDKهای عمومی، بلکه برای مرزهای سرویسهای داخلی، کلاینتهای کتابخانه، انتزاعهای مخزن (Repository Abstractions) و کلاسهای کمکی در یک monorepo بزرگ صدق میکند. هرچه بازرسی یک API آسانتر باشد، برای یک عامل راحتتر است که کد را به عنوان مستند معتبر بپذیرد.
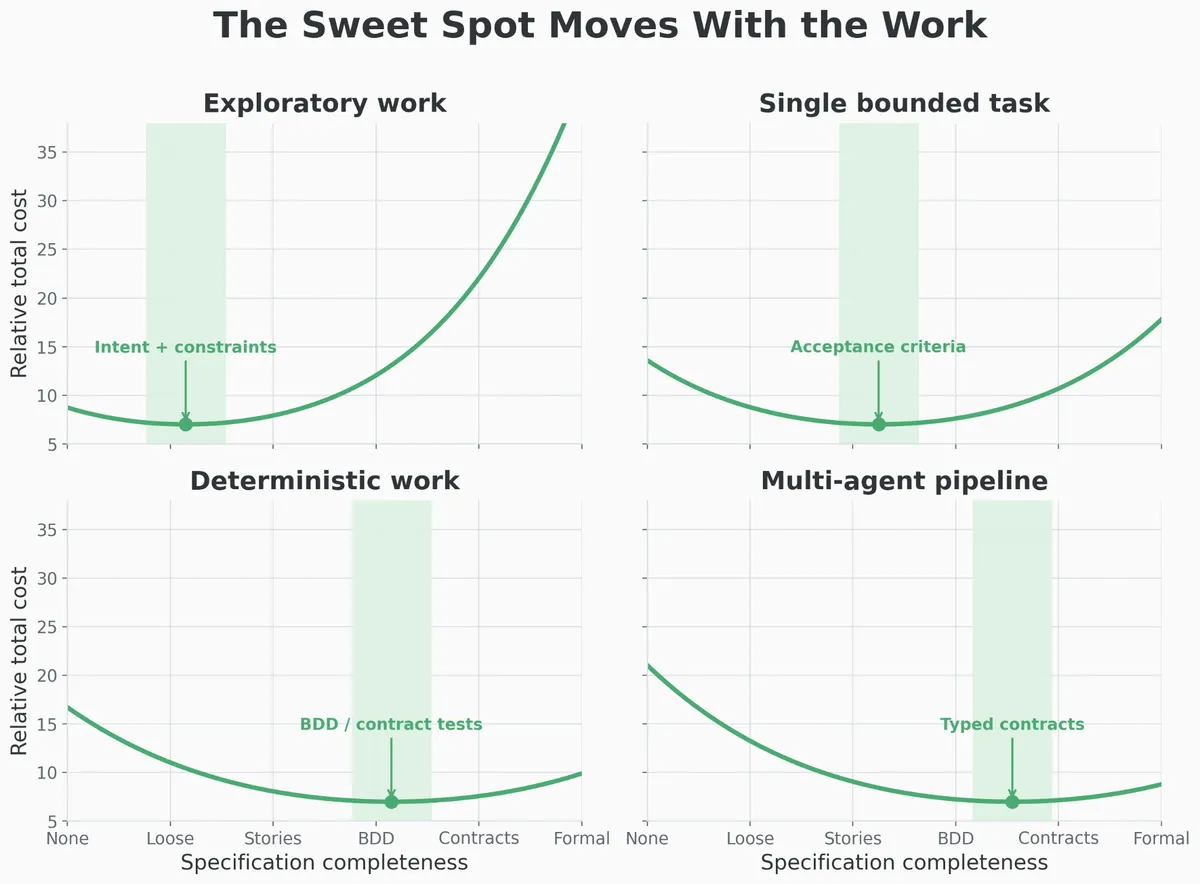
یافتن نقطه بهینه مستندات
هیچ مقدار جهانی برای مستندات وجود ندارد؛ نقطه بهینه به ماهیت کار بستگی دارد:
- کارهای اکتشافی: (مانند گزینههای معماری، سنتز تحقیقات، ایدههای نو) به کمترین میزان مستندات نیاز دارند. توصیف بیش از حد میتواند انعطافپذیری را که عامل را مفید میکند، بکشد. بهجای نتایج خاص، روی مرزها تمرکز کنید — چه چیزی باید درست باشد، چه چیزی نباید اتفاق بیفتد، چه شواهدی مورد نیاز است و کدام تصمیمات هنوز به انسان نیاز دارند.
- وظایف محدود: (مانند ویژگیهای کوچک) به نیت ساختاریافته، چند مثال، اهداف منفی و معیارهای پذیرش روشن نیاز دارند تا عامل بدون اینکه تنظیمات سنگینتر از خودِ تسک شود، بهرهور بماند.
- کارهای قطعی: (مانند جریانهای CRUD، یکپارچهسازی API، تبدیل دادهها) به بیشترین میزان مستندات نیاز دارند. اینها بهراحتی محدود و تست میشوند، بنابراین BDD و تستهای قراردادی با کاهش بازبینیهای مکرر و دوبارهکاریها، سریعاً هزینه خود را جبران میکنند.
- خط لولههای چندعاملی: به بالاترین سطح سختگیری نیاز دارند. هر مرز بین عاملها نیاز به یک قرارداد تاییدشده دارد. بدون آن، شما یک سیستم را هماهنگ نمیکنید، بلکه تفاسیر را روی هم میچینید و امیدوارید که اثر یکدیگر را خنثی کنند.
بقای متدهای Agile و XP
توسعه عاملمحور متدهای چابک (Agile) یا برنامهنویسی مفرط (XP) را منسوخ نمیکند، بلکه «تشریفات» آنها را حذف میکند. جلسات روزانه وضعیت، تشریفات متورم بکلاگ و تخمینهایی که با اعتماد به نفسی بیشتر از اطلاعات ارائه میشوند، قربانیان این تحول هستند. عاملها شکل تسکها را چنان سریع تغییر میدهند که تخمینهای قدیمی تلاشها تقریباً بلافاصله به داستانهای تخیلی تبدیل میشوند. برنامهریزی باید دست از این تظاهر بردارد که میتواند هزینه پیادهسازی را با همان راحتی پیشبینی کند که زمانی داشت وقتی کدنویسی بخش کند کار بود.
آنچه باقی میماند، منطق بازخورد است. چرخههای کوتاه و برشهای عمودی نازک اکنون مهمتر از همیشه هستند زیرا عاملها میتوانند «اشتباهات متقاعدکننده» را با سرعت بالا تولید کنند. بازخورد سریع تنها راهی است که بفهمیم کدهای تولید شده در صبح، بر اساس یک ایده غلط بنا شدهاند.
اصول هسته XP — تفکر تست-اول، یکپارچهسازی مداوم و بازسازی کد (Refactoring) — همچنان حیاتی هستند. چون ماشین غرور ندارد، با اطمینان کامل یک آشفتگی ساختاری تولید میکند که کار میکند و چند تست را پاس میکند اما غیرقابل نگهداری است. قضاوت طراحی انسانی باید در کنار فرآیند تولید کد باقی بماند، چه از طریق جفتشدن انسان-عامل و چه از طریق بازبینی مدل-روی-مدل. بخش مفید جفتشدن (Pairing) هرگز دو کیبورد در هماهنگی نبود؛ بلکه بازخورد سریع طراحی بود پیش از آنکه کد در جای خود تثبیت شود.
انتشارات کوچک نیز به دلیل یک دلیل عملی باقی میمانند: وقتی عاملها تغییرات بزرگ را ارزان میکنند، وسوسه پذیرش diffهای بزرگ زیاد است. با این حال، بازبینی، بازگشت (Rollback) و تشخیص خطا در دستههای کوچک آسانتر است. یک شاخه ویژگی (Feature Branch) کوتاهمدت همیشه استدلال درباره آن آسانتر از یک هیولای ۴۰۰۰ خطی است.
در نهایت، وعده عاملها ارزان کردن پیادهسازی است. اما وقتی کد ارزان میشود، پروژههای موفق آنهایی خواهند بود که روی دقت مستندات و قابلیت اطمینان اعتبارسنجی خود سرمایهگذاری میکنند. تیمهایی که بیشترین اهرم را خواهند داشت، تیمهایی نیستند که کمترین توصیفات را مینویسند، بلکه کسانی هستند که میدانند چه زمانی سه گلوله (توضیح کوتاه) کافی است، چه زمانی به یک قرارداد واقعی نیاز دارند و چه زمانی آن قرارداد باید اجرایی شود.
گام بعدی شما
- برای هر تسک پیچیده، از متد «طراح-حملهکننده» برای اعتبارسنجی مستندات قبل از شروع کدنویسی استفاده کنید.
- مستندات پروژه را هر دو هفته یکبار پاکسازی کنید و متونی که کد آنها را بیان کرده است حذف نمایید.
- APIهای داخلی خود را با متدهای Task-Aligned بازنویسی کنید تا مدلها بتوانند بدون نیاز به متن زیاد، کد را بفهمند.
اما داستان سختافزاری این تحول حتی شگفتانگیزتر است — به تحلیل ما درباره تراشههای Blackwell مراجعه کنید.



گفتگو