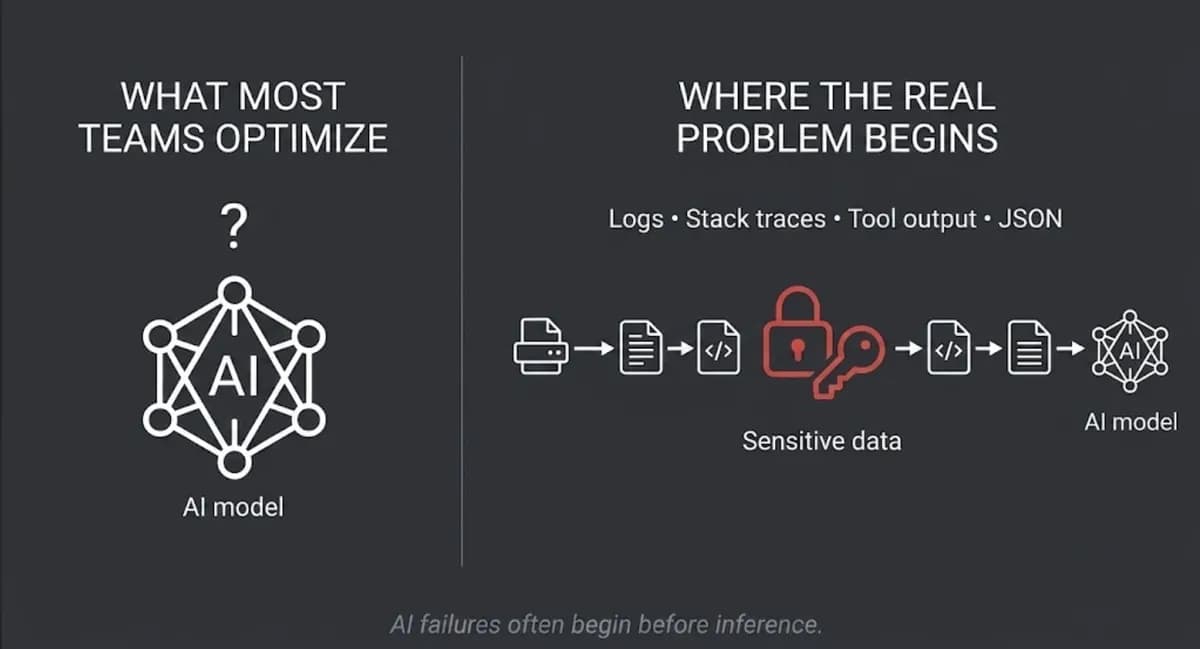
اگر امروز برای پیادهسازی یک عامل هوش مصنوعی در محیط عملیاتی تلاش میکنید، احتمالاً متوجه شدهاید که مدلهای پیشرفته در مواجهه با دادههای واقعی شکست میخورند. حقیقت تلخ این است که مشکل معمولاً از «مغز» مدل نیست، بلکه از «حسی» است که دادههای ورودی به مدل منتقل میکنند. چرا عاملهای هوش مصنوعی در محیط تولید بهرغم استدلالهای پیچیده شکست میخورند؟ در حالی که توسعهدهندگان بهطور غریزی تنظیمات دما (Temperature) یا خود مدل را مقصر میدانند، تیم XContext کشف کرد که مدل تقریباً هرگز مشکل اصلی نیست؛ مشکل اصلی چیزی است که به مدل ارسال میشود.
ریشه این مسئله معمولاً در مرحله «تجمع» (Assembly) نهفته است؛ جایی که دادههای خام برای پردازش توسط عامل جمعآوری میشوند. در نهایت، ورودیهای بد و نه استدلالهای ناقص، عامل اصلی شکست سیستمها هستند. همانطور که در تحلیلهای پیشین ما دربارهی امنیت مدلهای بازمتن اشاره کردیم، لایههای پیشپردازش دادهها اغلب نادیده گرفته میشوند، در حالی که حیاتیترین بخش زنجیره هستند. این موضوع تأیید میکند که بهبود کیفیت بستر دادهها برای مدلها اثرگذاری بیشتری نسبت به صرفاً ارتقای نسخه مدل دارد.
ساخت عاملهای حرفهای نیازمند عبور از رابطهای سادهٔ گفتگو است. یک سیستم عملیاتی باید بتواند فایلها را ببلعد، ابزارها را فراخوانی کند و لاگها، ردپاهای اجرا (Stack Traces)، خروجیهای CI و پاسخهای API را در لحظه پردازش کند. این محتوا در زمان اجرا جمعآوری شده و به مدل ارسال میشود تا بر اساس آن استدلال کند. در پستی که در ۸ ژوئیه ۲۰۲۶ منتشر شد، تیم XContext با جزئیات توضیح داد که چگونه در ابتدا با این مصنوعات بهصورت ورودیهای خام برخورد میکردند و این رویکرد چگونه منجر به افت سیستماتیک عملکرد شد.
ماهیت عاملهای عملیاتی
عاملهای هوش مصنوعی در محیط تولید با چتباتها تفاوتهای بنیادینی دارند:
- آنها حجم عظیمی از دادههای سیستمی، از جمله مصنوعات زمان اجرا (Runtime Artifacts) را پردازش میکنند.
- آنها برای آمادهسازی زمینه (Context) مدل، به یک مرحله تجمع پیچیده متکی هستند.
- شکستهای آنها معمولاً بر اساس کیفیت ورودی است، نه منطق استدلالی.

یکی از بحرانیترین حالتهای شکست، غرق کردن مدل در مقیاسهای نامربوط است. برای مثال، ارسال یک لاگ کامل ساخت CI — که بین ۴۰,۰۰۰ تا ۶۰,۰۰۰ خط است — مدل را مجبور میکند میان دهها هزار توکن از دانلودهای وابستگی (Dependency Downloads)، هشدارهای تکراری و مراحل مفصل ساخت بگردد. نویسندگان این گزارش دریافتند که مکانیزمهای توجه (Attention) قدرتمند هستند، اما جایگزینی برای یک ابزار جستوجوی هدفمند مانند grep نیستند. هرچه مقدار زمینه نامربوط رشد کند، مدل باید توجه بیشتری را صرف اطلاعاتی کند که کمکی به حل مسئله نمیکنند.
این نویز سه آسیب جدی وارد میکند:
- هزینه: هر توکن غیرضروری، هزینه API را افزایش میدهد. این چالش مدیریت هزینهها مشابه مواردی است که در پیادهسازی مسیریابهای قطعی برای کاهش مصرف توکنها مورد بررسی قرار دادیم.
- تأخیر: ورودیهای حجیمتر باعث کند شدن زمان پاسخدهی میشوند.
- کیفیت: غرق کردن مدل در نویز باعث میشود یافتن «سیگنال» واقعی دشوار شود، حتی اگر علت اصلی خطا در دل لاگ وجود داشته باشد.
برای حل این مشکل، این تیم یک خط لوله پالایش (Curation Pipeline) پیادهسازی کرد. بهجای ارسال بیش از ۵۰,۰۰۰ توکن از لاگهای خام، آنها بهطور مشخص بخشهای معیب (Failing Sections) را استخراج کرده، خروجیهای تکراری را متراکم (Collapse) کردند و هرچه نامربوط بود را حذف نمودند. این رویکرد پالایششده، ورودیها را به ۵۰۰ تا ۱,۰۰۰ توکن کاهش داد که نتیجه آن پاسخهایی سریعتر، ارزانتر و بهوضوح دقیقتر بود. تیم مذکور خاطرنشان کرد که آنها در ابتدا سیستمهای «ارسال خام» را ساخته بودند، زیرا اکثر مثالهای رایج در آموزشها، مصنوعات خام را مستقیماً به مدل میفرستند.
ریسکهای نامرئی امنیتی
امنیت، خطرناکترین حالت شکست است، چون بهصورت نامرئی رخ میدهد. تیمها بهندرت قصد دارند اسرار (Secrets) را لاگ کنند، اما دادههای عملیاتی اغلب حساستر از آن هستند که تصور شود. این اطلاعات حساس بهعنوان محصولات جانبی عیبیابی سیستمهای توزیعشده ظاهر میشوند، از جمله:
- کلیدهای API که در پیامهای خطا مخفی شدهاند.
- رشتههای اتصال به پایگاه داده در لاگهای شکست اتصال.
- هدرهای احراز هویت در ردپاهای درخواستهای HTTP.
- محمولههای (Payloads) ارسالی یا دریافتی که توسط کتابخانههای شخص ثالث و SDKها لاگ شدهاند.
چون عاملها بهرغم این نشت داده، اغلب پاسخی مفید تولید میکنند، تخلف امنیتی نادیده گرفته میشود. هیچ خطا یا هشداری صادر نمیشود؛ فقط یک مشکل CI عیبیابی میشود در حالی که اطلاعات حساس از مرزهای تعیینشده خارج میشوند. سطح حمله (Attack Surface) فراتر از کد منبع است و تمام دادههای عملیاتی، شامل پاسخهای ابزارها و مصنوعات زمان اجرا را در بر میگیرد.
XContext این مشکل را با پیادهسازی حذف اسرار (Secret Redaction) بهعنوان اولین گام در خط لوله حل کرد. آنها عملیات حذف را پیش از تلخیص (Summarization) انجام میدهند و نه بعد از آن؛ چرا که یک مدل تلخیصگر میتواند اطلاعات حساس را حتی در صورتی که مصنوع اصلی دور ریخته شود، در نسخه کوتاه حفظ کند.
چالش دادههای منقضیشده
در نهایت، این تیم با مشکل «کهنگی دادهها» (Staleness) مواجه شد. یک عامل ممکن است یک پیکربندی استقرار (Deployment Configuration) را در ابتدای یک جلسه بخواند. اگر آن جلسه دو ساعت طول بکشد و پیکربندی تغییر کند، عامل همچنان بر اساس دادههای اولیه کار میکند. این منجر به پارادوکسی میشود که در آن استدلال مدل کاملاً درست به نظر میرسد (چون با اطلاعاتی که ۹۰ دقیقه پیش داشت سازگار است)، اما تصمیم نهایی اشتباه است.
این شکست مربوط به داده است، نه منطق. برای کاهش این اثر، XContext در حال حاضر زمان دریافت (Ingestion Time) را بهعنوان متادیتا برای هر شیء زمینه ردیابی میکند تا قدیمی بودن اطلاعات را تشخیص دهد. با این حال، تیم پذیرفته است که هنوز در حال تدوین سیاستهای مناسب برای مدیریت کهنگی دادهها هستند.
این تغییر دیدگاه، نحوه نگاه ما به پشته هوش مصنوعی را عوض میکند. گلوگاه دیگر «مغز» (مدل) نیست، بلکه «حواس» (خط لوله داده) است. برای توسعهدهندگان، این یعنی سرمایهگذاری بیشتر روی پیشپردازش و ردیابی متادیتا بهجای مهندسی پرامپت (Prompt Engineering).
عدم پالایش دادهها فقط پول شما را نمیسوزاند، بلکه یک مسئولیت امنیتی (Security Liability) ایجاد میکند. تکیه صنعت بر مثالهای ساده و «ارسال مصنوعات خام» در آموزشهای اولیه، بسیاری از سیستمهای عملیاتی را آسیبپذیر و ناکارآمد کرده است.
گام بعدی شما
- بررسی مجدد لاگهایی که به عاملهای خود ارسال میکنید و شناسایی بخشهای تکراری یا نامربوط.
- پیادهسازی یک لایه حذف اسرار (Redaction) پیش از هرگونه پردازش یا تلخیص متنی.
- افزودن برچسب زمان (Timestamp) به دادههای بازیابیشده برای جلوگیری از استدلال بر اساس اطلاعات منقضی.
اما داستان سختافزاری مدیریت این حجم از دادهها حتی پیچیدهتر است؛ برای درک تأثیر حافظه در استنتاج، به تحلیل ما دربارهی KV Cache مراجعه کنید.



گفتگو