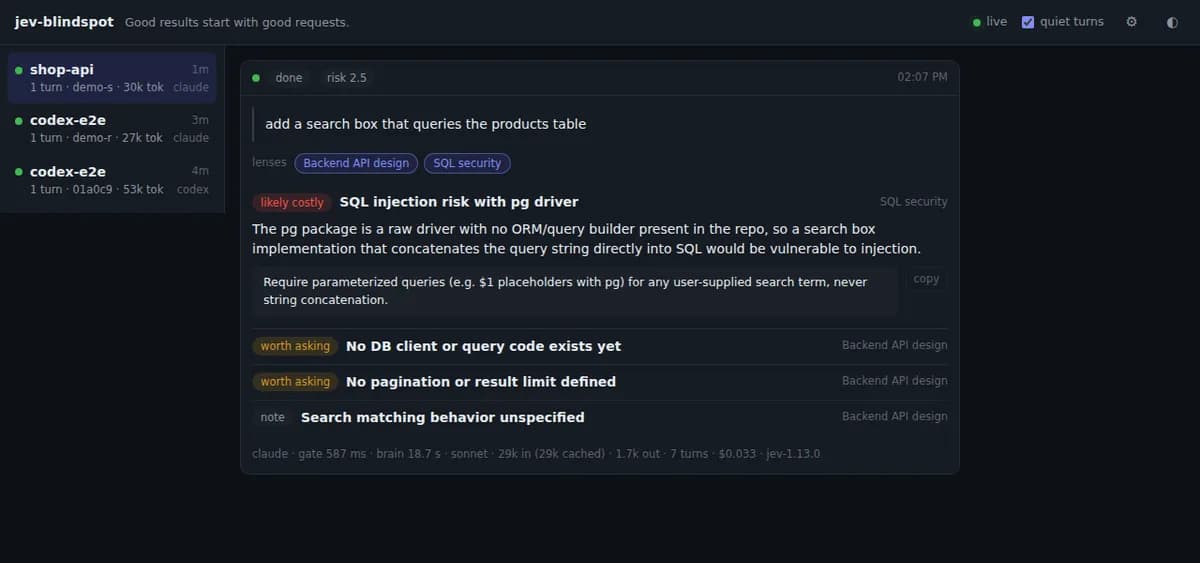
اگر فکر میکنید مدلهای هوش مصنوعی در اجرای دستورات شما اشتباه میکنند، احتمالاً در اشتباهید؛ مشکل این است که آنها دستورات ناقص شما را بهطور کامل اجرا میکنند. در ۲۲ سپتامبر ۲۰۲۶، یک تحلیل فنی عمیق در وبسایت dev.to فاش کرد که عاملهای هوش مصنوعی نه بهدلیل خطای مدل، بلکه بهدلیل اجرای بینقص درخواستهای ناقصی که «ناشناختههای ناشناخته» را نادیده میگیرند، شکست میخورند.
مرزهای درخواست
یک پرامپت که به هوش مصنوعی ارسال میشود، در واقع تصویری از تمام دانستههای شما در لحظهی دقیق تایپ آن است. خروجی مدل نه توسط تواناییهای فنی مدل، بلکه توسط مرزهای این درخواست محدود میشود. مدلهای پیشرفتهتر شاید همان قالب را روانتر پر کنند، اما نمیتوانند شکل و ابعاد خودِ درخواست را گسترش دهند.
تصور کنید از یک عامل (Agent) — شبیه دستیاری که دستورات شما را میگیرد و به ابزارهای مختلف میسپارد — میخواهید یک سیستم تأیید ایمیل با کد ۶ رقمی بسازد. هوش مصنوعی در چند دقیقه یک ویژگی کاربردی و فعال را تحویل میدهد، اما برای هر چیزی که شما مشخص نکردهاید، در سکوت پیشفرضهای خودش را انتخاب میکند. ممکن است هفتهها بعد بفهمید که کدها هرگز منقضی نمیشوند یا اسکریپتهای Brute-force بهراحتی تمام ۱,۰۰۰,۰۰۰ ترکیب ممکن را حدس میزنند؛ چون شما اصلاً نمیدانستید باید «محدودیت نرخ درخواست» (Rate Limiting) را بخواهید.
همانطور که در تحلیلهای قبلی ما دربارهی امنیت مدلهای بازمتن اشاره کردیم، بسیاری از حفرههای امنیتی نه از نقص کد، بلکه از نقص در تعریف نیازمندیها ناشی میشوند. موارد لبهای (Edge Cases) دیگری که معمولاً دیرتر ظاهر میشوند عبارتاند از:
- تغییر ایمیل حساب کاربری که باعث میشود کل فرآیند تأیید بهطور کامل دور زده شود.
- درخواست ارسال مجدد کد که یک کد جدید میسازد اما کد قبلی را باطل نمیکند.
ناشناختههای شناختهشده در مقابل ناشناختههای ناشناخته
این شکاف به این دلیل است که تخصص تنها دانستن پاسخها نیست، بلکه دانستن این است که چه سوالاتی باید پرسیده شود. طبق این گزارش، تمایز حیاتی بین دو نوع جهل وجود دارد:
۱. ناشناختههای شناختهشده (Known Unknowns): چیزهایی که میدانید که نمیدانید. اینها در واقع یک لیست «کارهای مورد نیاز» (To-do list) هستند؛ شما میتوانید مستندات را بخوانید، دربارهشان جستجو کنید یا از یک همکار بپرسید.
۲. ناشناختههای ناشناخته (Unknown Unknowns): چیزهایی که حتی نمیدانید که نمیدانید. این موارد از درون سیستم کاملاً نامرئی هستند. شما نمیتوانید چیزی را لیست کنید که هرگز به ذهنتان خطور نکرده است.
یک توسعهدهنده ارشد فهرستی ذهنی از شکستهای گذشته و سوالاتی دارد که در نهایت اهمیتشان ثابت شده است، اما یک تازهکار نمیتواند چیزی را لیست کند که هرگز به ذهنش نرسیده است. هوش مصنوعی این خطر را تشدید میکند؛ چون کدی بسیار روان تولید میکند و تستها را پاس میکند، تا زمانی که پروژه به محیط عملیاتی برسد یا وارد مرحله بازبینی کد (Code Review) شود و توهم کامل بودن فرو بریزد.
چرا بررسیکنندههای پرامپت شکست میخورند؟
بسیاری از «بررسیکنندههای پرامپت» — مانند Linterهای پرامپت، دیالوگهای شفافساز یا پنجرههای «آیا منظورتان این بود؟» — شکست میخورند چون اصطکاک ساختاری در تجربه کاربری (UX) ایجاد میکنند. این ابزارها معمولاً پرامپت را متوقف کرده و یک نقطه بازرسی اضافه میکنند که کاربر هرگز درخواست نکرده است.
به گزارش نویسنده، این ابزارها اغلب ظرف یک روز غیرفعال میشوند، زیرا با سه مشکل اصلی روبرو هستند:
- تأخیر (Latency): یک مدل باید ابتدا پرامپت را بازرسی کند و سپس مدل اصلی شروع به کار کند، که این یعنی ابزار دقیقاً روی مسیر بحرانی (Critical Path) قرار گرفته است.
- اتلاف منابع: یک درخواست ساده مثل «اوکی، ادامه بده» همان پردازش سنگین و سختگیرانهای را دریافت میکند که یک درخواست پیچیده مثل «مهاجرت جدول اصلی دیتابیس».
- قطع جریان کاری: این ابزارها در هر پرامپت، سدی بین کاربر و عامل ایجاد میکنند و تمرکز را به هم میزنند.
معماری یک راهکار
برای حل این مشکل، نویسنده ابزار jev-blindspot را توسعه داده است که یک ابزار سبک برای Claude Code و Codex CLI است. این سیستم بر اساس چهار محدودیت خاص عمل میکند تا به جای کمک، مزاحم نباشد:
- طبقهبندی ارزان: یک طبقهبند سریع و سبک تصمیم میگیرد که آیا پرامپت دارای یک نقطه کور بحرانی است یا خیر. درخواستهای ساده فوراً و بدون تأخیر عبور میکنند.
- بازرسی دقیق: تنها زمانی که یک نقطه کور احتمالی شناسایی شود، یک مدل کامل درخواست را در برابر کل کدبیس میخواند تا شناسایی کند یک توسعهدهنده خبره چه مواردی را در نظر میگرفت.
- اجرای ناهمگام (Asynchronous): پرامپت بلافاصله به عامل ارسال میشود. بررسی در پسزمینه اجرا میشود تا هرگز مانع کاربر نشود.
- بازخورد کانال جانبی: بینشها و هشدارها در یک پنل کناری نمایش داده میشوند. این کار باعث میشود جلسه اصلی تمیز بماند و نویز اضافی به کانتکست (Context) عامل تزریق نشود.
پیادهسازی و نتایج
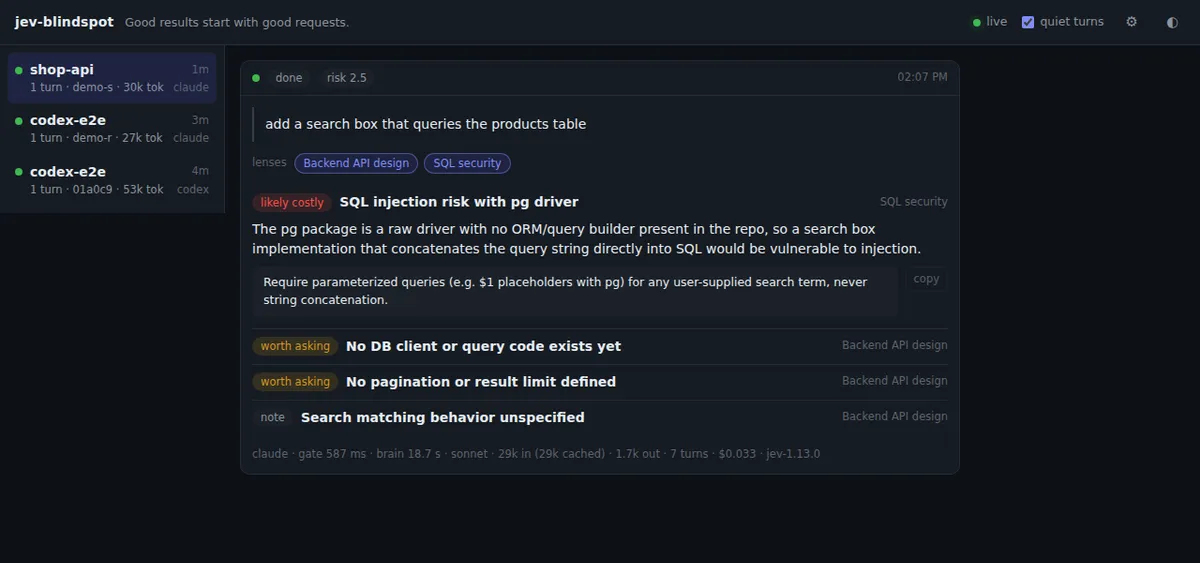
در پیادهسازی jev-blindspot، وقتی نقطه کوری شناسایی میشود، یک هوک محلی پرامپت را به یک Daemon پسزمینه میفرستد. اگر درخواست از آستانه حساسیت عبور کند، یک نسخه Read-only از عامل، دایرکتوری پروژه را بازرسی کرده و کارتهای کوتاهی تولید میکند که شامل موارد زیر است:
- مورد فراموششده (The missing consideration).
- دلیل اهمیت آن در این بستر خاص.
- یک خط کد آماده برای کپی و قرار دادن در پرامپت بعدی.
این رویکرد تمرکز را از «اصلاح یک پرامپت واحد» به «گسترش آگاهی متاشناختی کاربر» تغییر میدهد. با شناسایی لبههای دانش خود، توسعهدهنده میتواند درخواستهای خود را از «سمت دیگر» آن مرز بنویسد.
برای توسعهدهنده مدرن، مهارت حیاتی دیگر مهندسی پرامپت (Prompt Engineering) — در معنای کلمات جادویی و کلیدواژهها — نیست؛ بلکه توانایی شناسایی موارد لبهای در حوزه تخصصی (Domain-specific edge cases) قبل از تولید اولین خط کد است. اگرچه این ابزار گاهی ممکن است به سمت توصیههای کلی و چکلیستگونه متمایل شود، اما درس کلی این است: عامل محدودکننده در مهندسی به کمک هوش مصنوعی، مرزهای درخواست است. هر چیزی که این مرز را گسترش دهد — چه یک ابزار، چه یک بازبین ارشد، یا صرفاً پرسیدن این سوال که «یک متخصص این حوزه اول چه میپرسید؟» — کیفیت تمام نتایج پاییندستی را ارتقا میدهد.
گام بعدی شما
- در درخواستهای بعدی خود از هوش مصنوعی، صراحتاً بپرسید: «اگر یک متخصص ارشد در این حوزه بود، چه موارد لبهای یا امنیتی را در این درخواست من فراموش کرده است؟»
- ابزارهای بررسی ناهمگام (Asynchronous) را جایگزین چکلیستهای دستی کنید تا سرعت توسعهتان کاهش نیابد.
- روی یادگیری «ناشناختههای ناشناخته» در دامین کاری خود تمرکز کنید، زیرا مدل هر چقدر هم قدرتمند باشد، در مرزهای درخواست شما زندانی است.
اما داستان سختافزاری این تحول حتی شگفتانگیزتر است — به تحلیل ما دربارهی تراشههای Blackwell مراجعه کنید.



گفتگو