
اگر امروز برای هر درخواست ساده از مدلهای گرانقیمت استفاده میکنید، احتمالاً بخش بزرگی از بودجه استنتاج خود را دور میریزید. تصور کنید برای خرید یک بسته شیر از بقالی سر کوچه، یک لیموزین لوکس اجاره کنید؛ این دقیقاً همان اتفاقی است که وقتی یک بررسی احساسات تکخطی را به مدلهای پیشرفته میسپارید، رخ میدهد.
به گزارش AIBridge در ۳۱ اوت ۲۰۲۶، این یک «مشکل مسیریابی» سیستماتیک است. اکثر پیادهسازیهای فعلی از یک مدل قدرتمند برای تمام درخواستها استفاده میکنند. این رویکرد سختافزاری نادیده میگیرد که هزینه تولید یک مقاله ۵۰۰ کلمهای نباید با یک طبقهبندی ساده برابر باشد.
همانطور که در تحلیلهای قبلی ما دربارهی بهینهسازی هزینههای مدلهای بازمتن اشاره کردیم، کلید بهرهوری در تفکیک حجم کاری است. توسعهدهندگان باید از یک ابزار کلی به یک جعبهابزار دقیق تغییر مسیر دهند. در همین راستا، برخی ابزارها با رویکردهای نوآورانه مانند استخراج حافظه توانستهاند هزینههای توکن را تا ۸۱ درصد کاهش دهند.
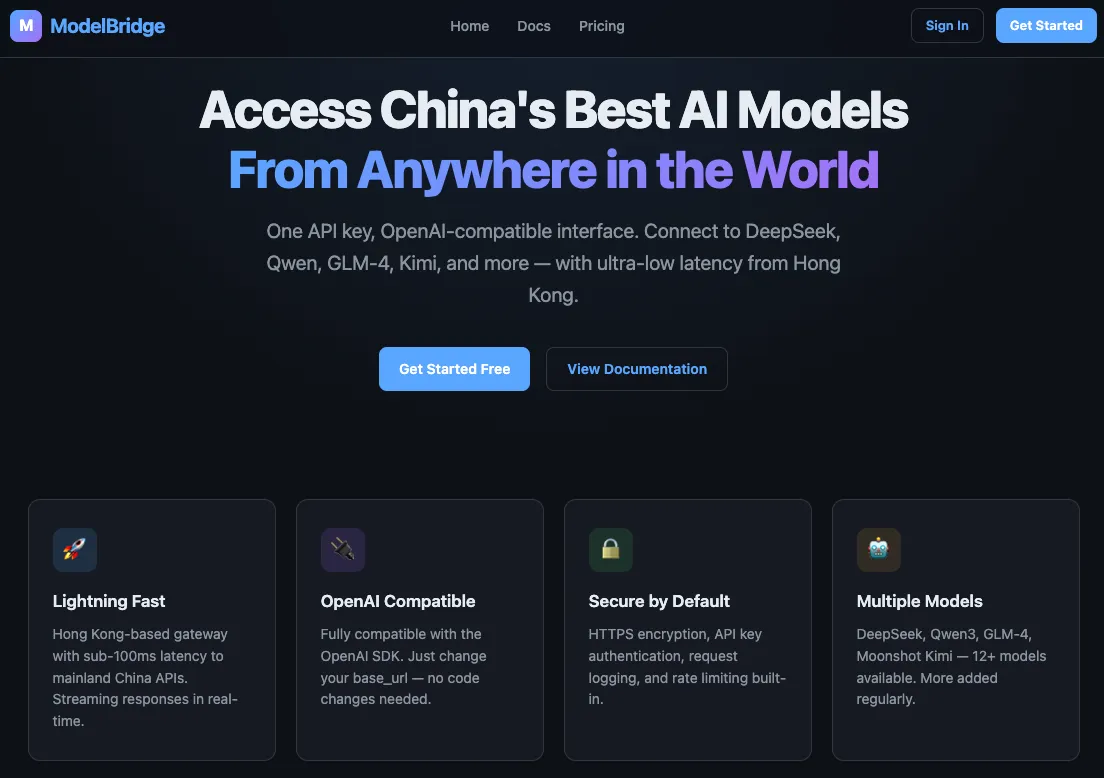
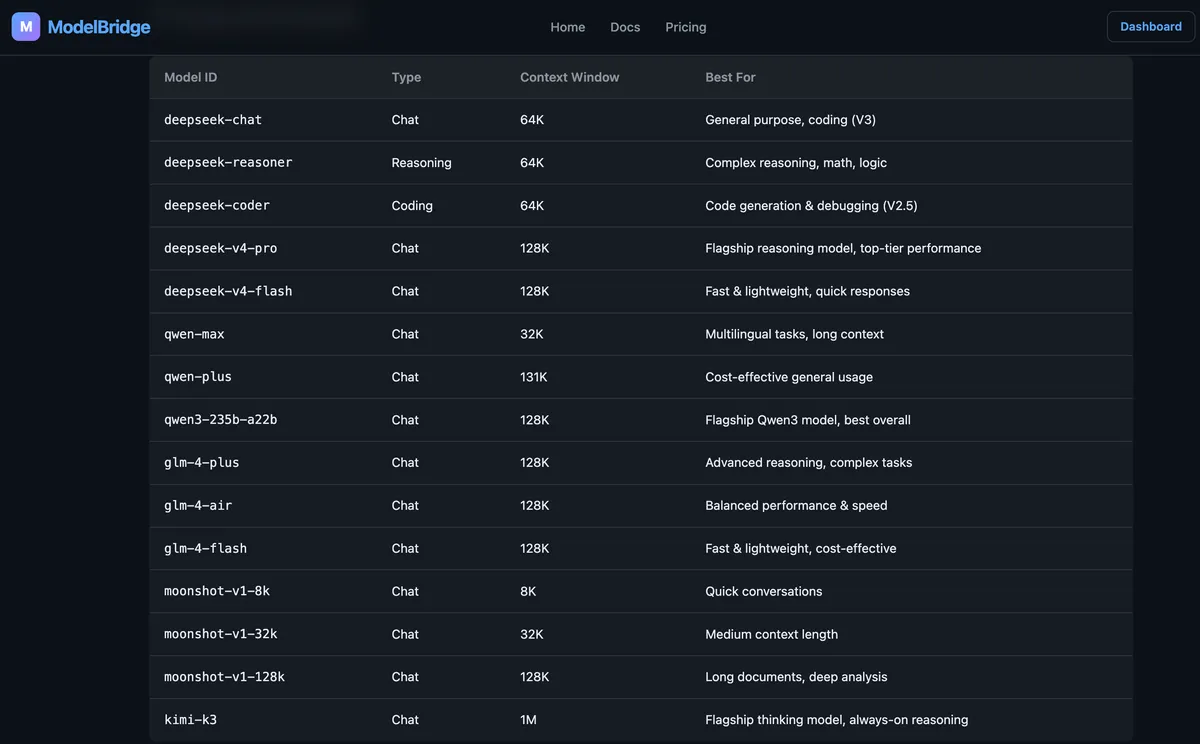
پلتفرم AIBridge اکنون ۱۵ مدل از چهار تأمینکننده مختلف را از طریق یک SDK ارائه میدهد. بر اساس مستندات این پلتفرم، استراتژی ایدهآل مسیریابی به این صورت است:
- استدلال پیچیده و ریاضیات: استفاده از deepseek-reasoner یا deepseek-v4-pro برای کارهایی که نیاز به زنجیره تفکر (Chain-of-Thought) — شبیه وقتی شاگرد ریاضی پای تخته بلند بلند فکر میکند تا به جواب برسد — دارند.
- تولید کد: استفاده از deepseek-coder برای عیبیابیهای تخصصی.
- حجم بالا/اهمیت کم: استفاده از glm-4-flash یا deepseek-v4-flash برای به حداقل رساندن هزینهها.
- بستر متنی طولانی: استفاده از kimi-k3 برای اسناد میلیونی یا qwen-plus برای پنجرههای متنی ۱۳۱ هزار توکنی.
- پرچمدار عمومی: استفاده از qwen3-235b-a22b برای بالاترین سطح عملکرد کلی.
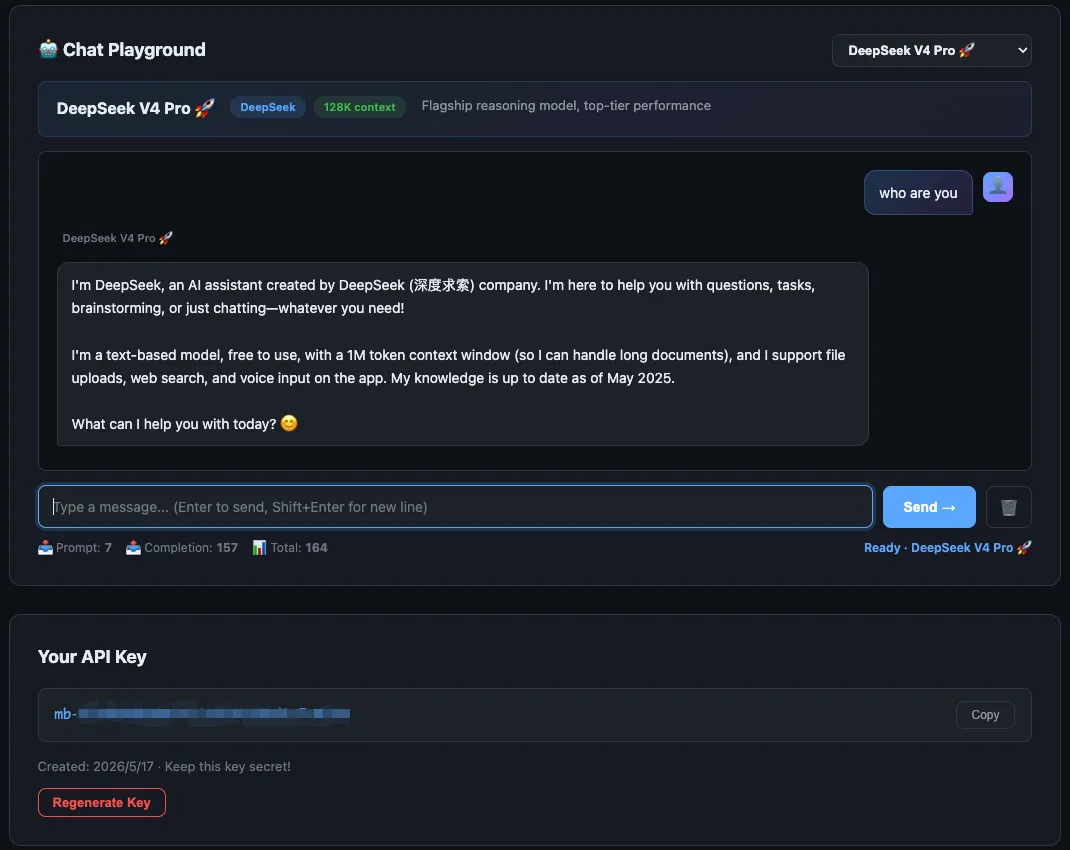
در یک دستیار نویسنده عملی، این یعنی استفاده از deepseek-v4-pro برای ساختار کلی، qwen-plus برای بسط متن و glm-4-flash برای اصلاحات گرامری. این کنترل دقیق اجازه میدهد منحنی کیفیت-هزینه بدون نیاز به بازنویسی کامل کد، تنظیم شود.
از منظر مالی، این تغییر فشار را از ماتریسهای پیچیده قیمت هر مدل برمیدارد. AIBridge یک سطح رایگان با ۵۰۰ هزار توکن (Token) — تکههای کوچکی از متن شبیه برشهای کیک که مدل میخورد — در ماه و یک طرح حرفهای با قیمت ۹.۹۰ دلار برای ۵ میلیون توکن ارائه میدهد.
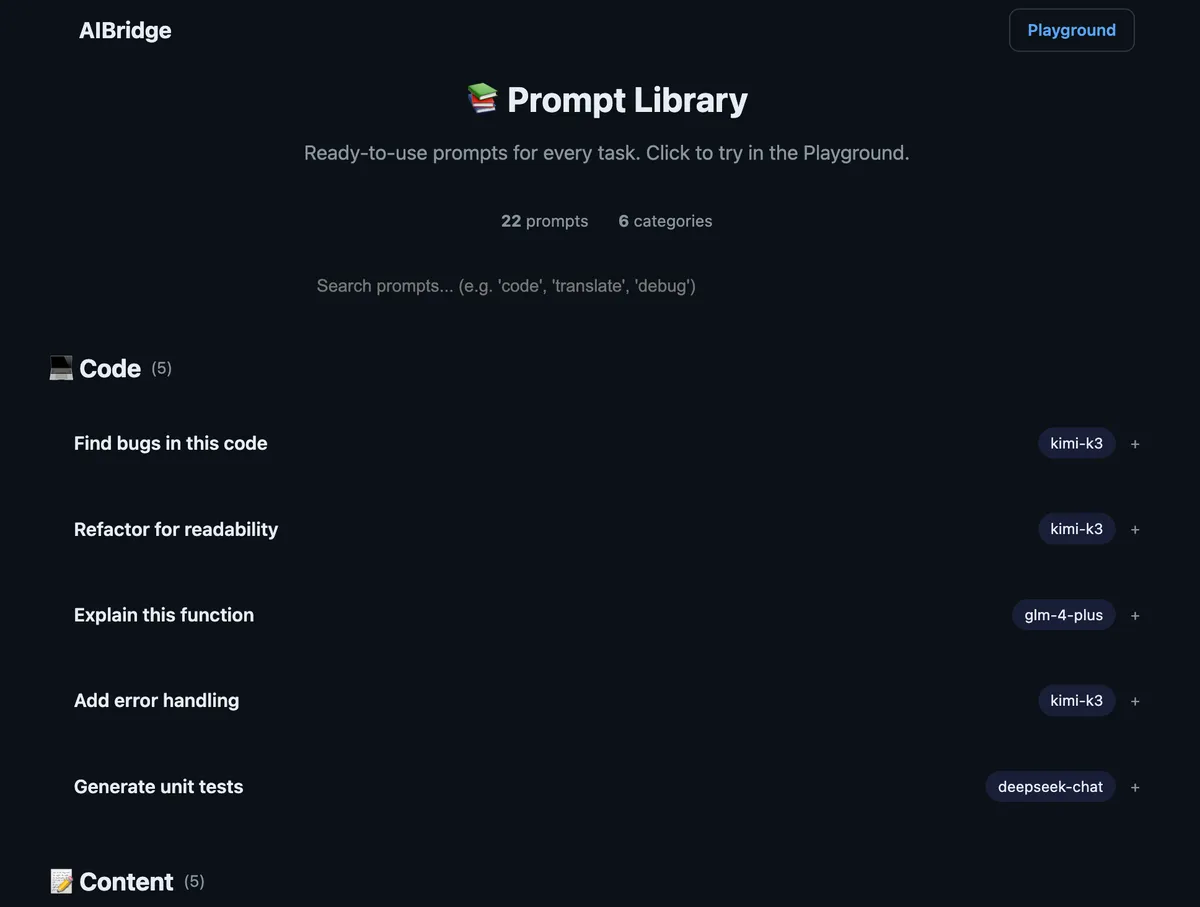
برای کیف پول توسعهدهنده، این به معنای پایان غافلگیریهای «حلقه تکرار» است، زیرا سهمیههای اتمی هر توکن و داشبوردهای لحظهای در دسترس است. این مدیریت دقیق منابع یادآور راهکارهایی است که برای دور زدن محدودیتهای نرخ درخواست در طرحهای رایگان و افزایش ظرفیت نمونههای اولیه به کار میرود. هدف این است که با هوش مصنوعی نه به عنوان یک سرویس یکپارچه، بلکه به عنوان یک ابزار طبقهبندیشده برخورد شود.
برای بهینهسازی هزینههای فعلی، لاگهای API خود را بررسی کنید تا ببینید چند درصد از درخواستهای شما «ساده» هستند و میتوانند همین امروز به یک مدل Flash منتقل شوند.
گام بعدی شما
- تحلیل لاگهای API برای شناسایی درخواستهای تکراری و ساده.
- تست مدلهای Flash برای وظایفی مانند اعتبارسنجی JSON یا خلاصهسازی کوتاه.
- بررسی مدلهای تخصصی کدنویسی برای جایگزینی مدلهای عمومی در محیط توسعه.
اما داستان سختافزاری این تحول حتی شگفتانگیزتر است — به تحلیل ما دربارهی تراشههای Blackwell مراجعه کنید.



گفتگو