اگر امروز بر اساس رتبهبندیهای عمومی مدل هوش مصنوعی خود را انتخاب میکنید، احتمالاً در حال بهینهسازی برای دادههایی هستید که هرگز در دنیای واقعی با آنها مواجه نمیشوید. حقیقت این است که لیدربوردهای عمومی، بار کاری دیگران را میسنجند، نه نیازهای خاص محصول شما را.
به گزارش وبسایت dev.to در ۲۱ اوت ۲۰۲۶، تنها معیاری که واقعاً اهمیت دارد، محکی (Benchmark) است که روی دادههای واقعی تولید (Production) شما اجرا شده باشد. همانطور که در تحلیلهای قبلی ما دربارهی امنیت مدلهای بازمتن اشاره کردیم، فاصله میان عملکرد آزمایشگاهی و محیط عملیاتی همیشه یک ریسک پنهان است. در همین راستا، استفاده از تستهای دودزا به عنوان معیاری سریعتر میتواند پیش از اجرای بنچمارکهای سنگین، کفِ عملکرد مدل را در محیط واقعی بسنجد. استفاده از مدل زبانی بزرگ (LLM) — مثل کتابخانهداری که میلیاردها صفحه را خوانده و حالا با همان لحن کتابها جواب میدهد — بدون داشتن یک سیستم سنجش داخلی، شبیه به رانندگی با چشمبسته در جادهای ناشناخته است.
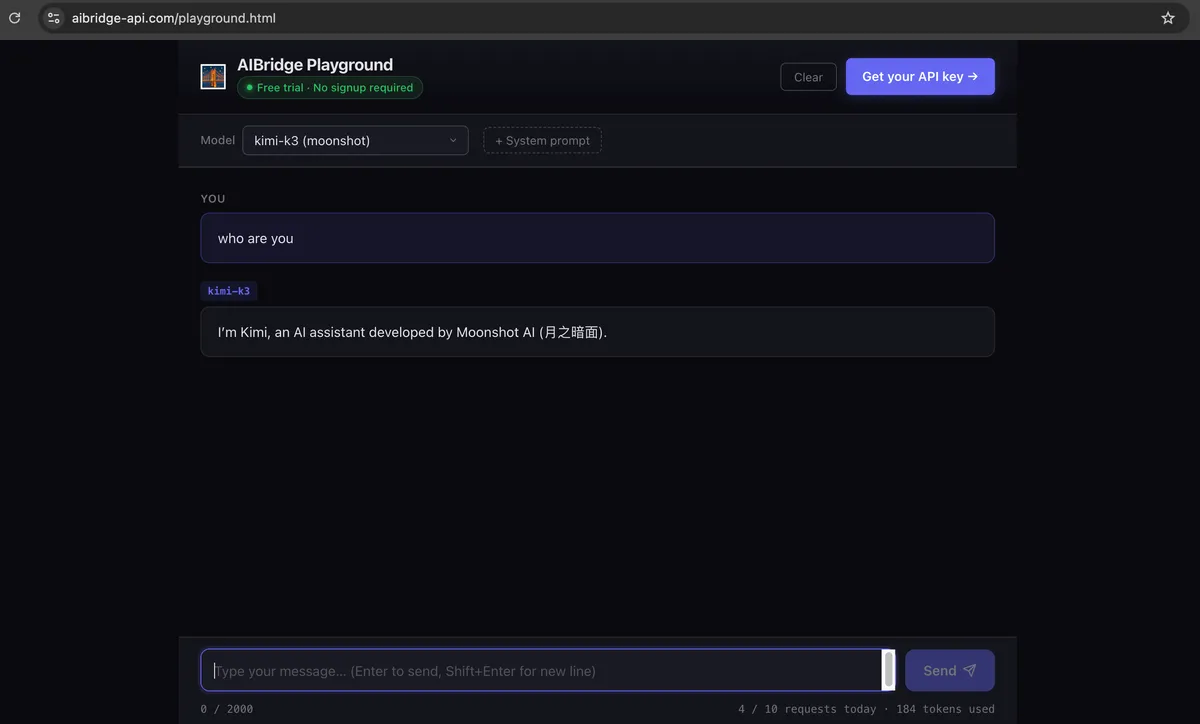
بسیاری از توسعهدهندگان بهدلیل پیچیدگیهای فنی از تستهای سفارشی دوری میکنند. مدیریت چندین حساب کاربری، SDKها و داشبوردهای پرداخت مختلف، سدی است که باعث میشود نمودارهای آمادهی شخص ثالث وسوسهانگیز شوند. برای حل این مشکل، ابزارهایی مانند AIBridge یک نقطه اتصال واحد برای تست بیش از ۱۵ مدل، از جمله deepseek-chat، kimi-k3، glm-4-plus و qwen-plus فراهم میکنند تا نیاز به کلیدهای API متعدد نباشد. برای مثال، قابلیتهای جدید GLM-5.2 نشان میدهد که چگونه مدلهای بازمتن در حال تبدیل شدن به جایگزینهای عملی برای توسعهدهندگان در محیطهای کدنویسی هستند.
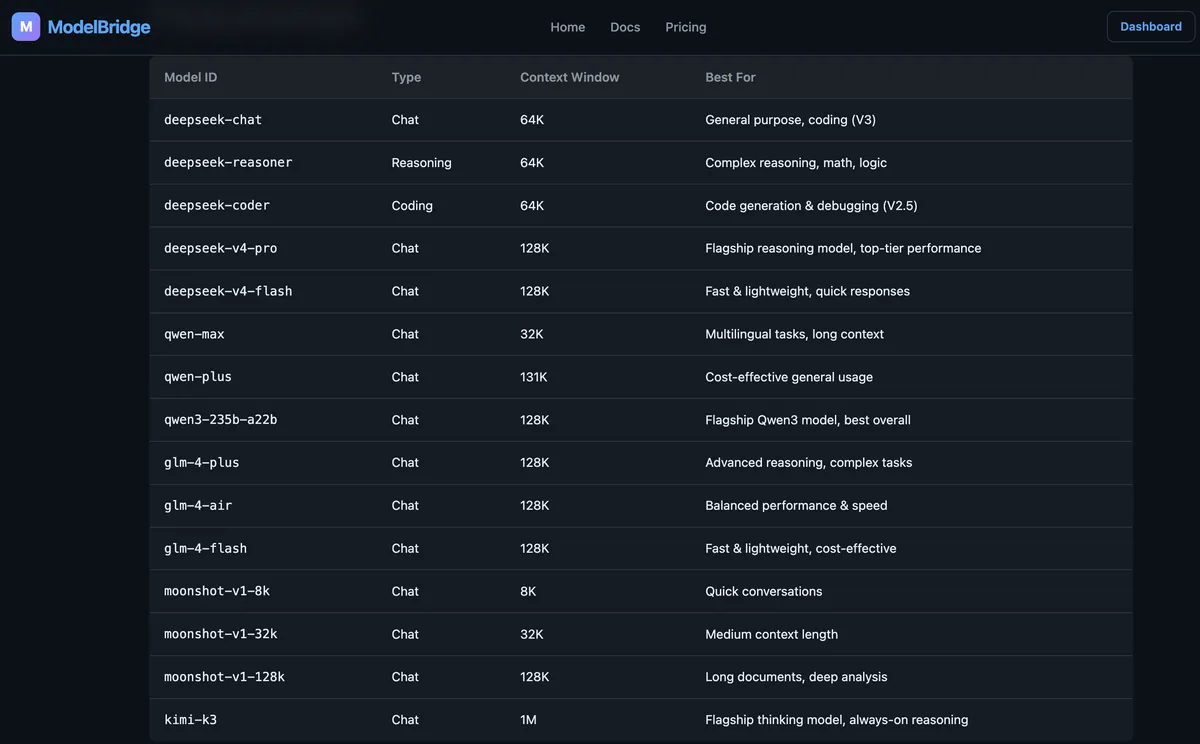
یک ارزیابی داخلی مؤثر باید سه محور اصلی را بسنجد:
- صحت (Correctness): آیا مدل سختترین موارد خاص (Edge Cases) شما را حل میکند یا فقط پاسخهای ساده را درست میدهد؟
- هزینه (Cost): مجموع توکنهای ورودی و خروجی ضربدر قیمت مدل. توجه کنید که مدلهای استدلالی (Reasoning Model) — مدلی که قبل از جواب، یک قدم درنگ میکند و فکر میکند، شبیه شطرنجبازی که چند حرکت جلوتر را میبیند — میتوانند تا ۵۰ برابر گرانتر از مدلهای معمولی باشند. در این زمینه، تقابل مدلهای بازمتن ترکیبی با مدلهای غولپیکر تکسازه نشان میدهد که لزوماً حجم بیشتر مدل به معنای بهرهوری اقتصادی بالاتر در مهندسی نیست.
- تأخیر (Latency): زمان رسیدن به نخستین توکن. یک وقفه ۴ ثانیهای برای «تفکر» مدل میتواند برای اپلیکیشنهای کاربر-محور غیرقابلقبول باشد.
بر اساس بررسی منابع متعدد، استراتژی بهینه معمولاً یک ساختار ترکیبی است. استفاده از یک مدل ارزان برای مدیریت ۹۵٪ موارد ساده و ارجاع ۵٪ موارد دشوار به یک مدل استدلالی قدرتمند، تقریباً همیشه بهتر از استفاده از یک مدل گرانقیمت برای تمام درخواستها است.
این تغییر رویکرد به این معناست که انتخاب مدل دیگر یک تصمیم معماری یکباره نیست، بلکه به یک پارامتر ماهانه تبدیل میشود که بر اساس اعداد واقعی شما بازبینی میشود. با جداسازی مدل از کد، محکزنی از یک پروژه سنگین به یک عادت ۱۰ دقیقهای تبدیل میشود.
گام بعدی شما
- یک اسکریپت ساده پایتون بنویسید تا رایجترین پرامپتهای خود را روی مدلهای مختلف اجرا کنید.
- کیفیت پاسخها را بهصورت بصری بررسی کرده و میزان مصرف توکنها را پیش از انتخاب تامینکننده نهایی رصد کنید.
- یک ماتریس مقایسهای از «صحت در برابر هزینه» برای هر مدل ایجاد کنید.
اما داستان سختافزاری این تحول حتی شگفتانگیزتر است — به تحلیل ما دربارهی تراشههای Blackwell مراجعه کنید.



گفتگو