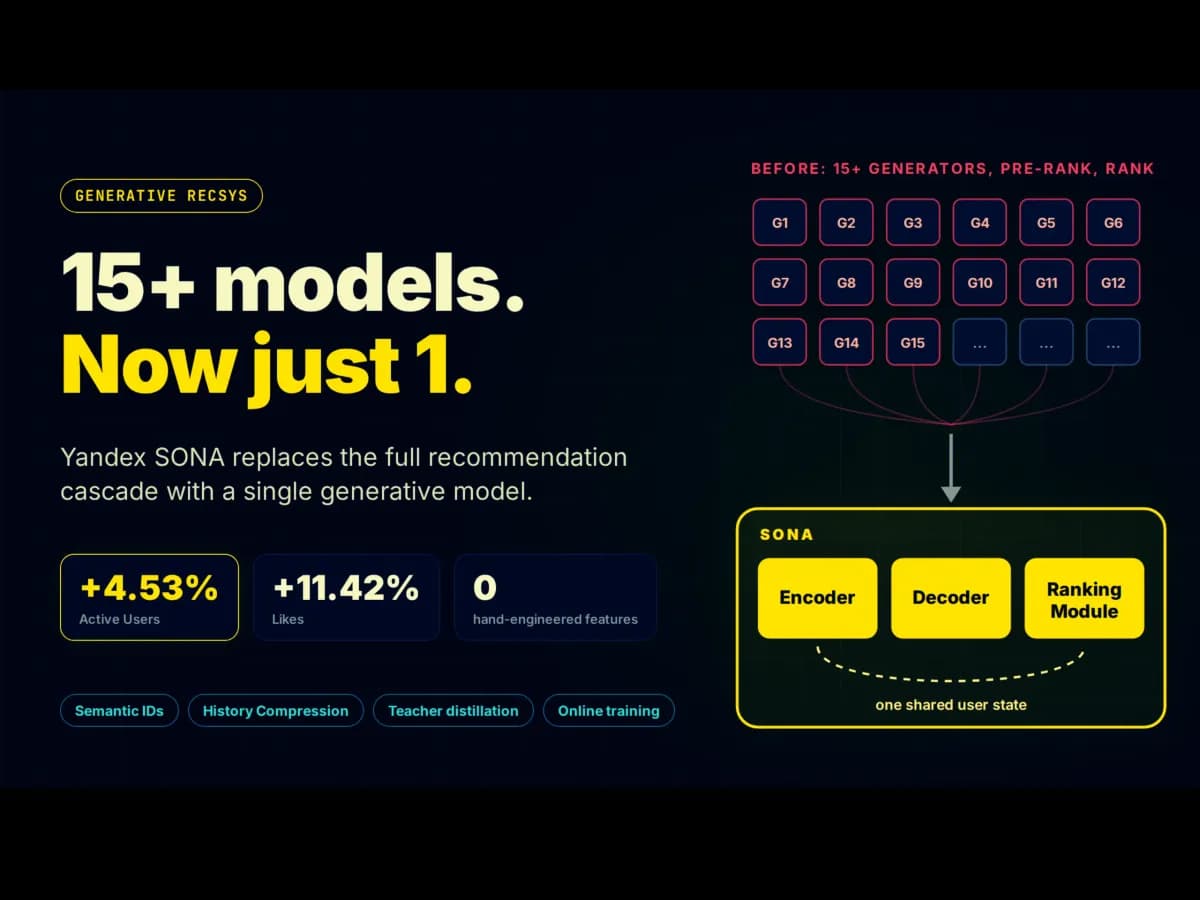
تصور کنید سیستمی که بهجای عبور دادن دادهها از دهها فیلتر متوالی، در یک نگاه دقیق بفهمد شما دقیقاً چه آهنگی را میخواهید. یاندکس با معرفی Sona ثابت کرد که یک مدل ترنسفورمر (Transformer) واحد میتواند جایگزین کل معماری پیچیدهٔ توصیهگرهای مدرن شود. در حالی که موتورهای توصیهگر امروزی سالهاست که بر زنجیرههای چندمرحلهای پیچیده تکیه کردهاند، Sona نشان داد که یک مدل واحد میتواند هم تولید کاندیدها (Candidate Generation) و هم رتبهبندی (Ranking) را بهطور همزمان مدیریت کند.
طبق اعلام یاندکس، موتورهای توصیهگر سنتی مانند یک آبشار یا زنجیره (Cascade) عمل میکنند. در این ساختار، ابتدا تولیدکنندگان کاندید میلیونها آیتم را به چند هزار مورد محدود میکنند. سپس یک رتبهبند (Ranker) با استفاده از صدها ویژگی مهندسیشده توسط انسان، این موارد را پالایش و مرتب میکند. این رویکرد تکهتکه به این معناست که هر مرحله هدف متفاوتی را بهینه میکند و رتبهبند نهایی تنها به آنچه مراحل بالادستی اجازه عبور دادهاند دسترسی دارد.
مشکلی که Sona حل میکند
در زیرساخت قبلی یاندکس برای سرویس موسیقی (Yandex Music)، سیستم صدها ویژگی را مصرف میکرد که شامل سیگنالهایی از مدل Argus (یک ترنسفورمر توصیهگر قدیمیتر) بود. این زنجیره سنتی، یک تصمیم واحد را بین مدلهایی که بهطور مجزا آموزش دیدهاند تقسیم میکرد. این امر باعث ایجاد یک گلوگاه میشد؛ جایی که کیفیت رتبهبند نهایی بهطور مستقیم توسط کیفیت تولیدکنندگان کاندید محدود میشد.
Sona این مشکل را با متمرکز کردن تولید کاندید و رتبهبندی حول یک نمایش مشترک از کاربر (Shared User Representation) حل میکند. سیستم تاریخچه شنونده را در هر درخواست تنها یکبار میخواند و با استفاده از یک رمزگذار (Encoder)، وضعیتی ایجاد میکند که هم رمزگداز (Decoder) برای تولید کاندیدها و هم ماژول رتبهبندی برای امتیازدهی از آن استفاده میکنند. این رویکرد بهویژه در بلندگوهای هوشمند یاندکس بسیار مؤثر است؛ جایی که پخش موسیقی میتواند بدون اینکه کاربر ابتدا هنرمند، ژانر یا حالتی خاص را انتخاب کند، آغاز شود. تیم تحقیق یاندکس این سناریو را «تنظیمات توصیه خالص» (Pure-recommendation setting) مینامند.
معماری Sona
بر اساس مستندات فنی، Sona تکیه بر مهندسی ویژگیهای دستی را حذف کرده است. این مدل تنها از فیلدهای ثبتشده در رویدادها (Logged event fields) مانند شناسه آهنگ (Track ID)، شناسه هنرمند، مدت زمان، لایکها، زمان پخش شده و پرچمهای سطحی (Surface flags) و همچنین شناسههای معنایی آموختهشده (Learned Semantic IDs) استفاده میکند. معماری این سیستم از سه بخش اصلی تشکیل شده است:
- توکنساز معنایی (Semantic Tokenizer): با پیروی از فرمولبندی Rajput و همکاران، هر آهنگ به یک چندتایی (Tuple) شامل سه کد گسسته تبدیل میشود. یک مدل LLM چندوجهی منجمد (Frozen)، طیفنگاشت (Mel-spectrogram) ۹۰ ثانیه اول آهنگ را به همراه عنوان، هنرمندان و تگها در حالت prefill-only میخواند. سپس یک ترنسفورمر ۴ لایه برای پالایش، این ویژگیها را با استفاده از InfoNCE روی جفتآهنگهای مشارکتی (Collaborative track pairs) با رفتار شنوندگان همراستا میکند. در نهایت، روش Residual K-means نتیجه را به سه کتابکد (Codebook) با ۳۲,۰۰۰ ورودی در هر کدام کوانتیزه میکند. این رویکرد توانست بر خط پایه صوتی CLMR غلبه کند و نرخ Recall@1000 را از ۰.۸۱۱۱ به ۰.۸۵۲۴ برساند.
- رمزگذار فشردهساز تاریخچه (History-Compressed Encoder): برای مدیریت هزینه پردازش ۸۱۹۲ رویداد گذشته، Sona از عمق نامساوی (Uneven depth) استفاده میکند. جدیدترین ۲۰۴۸ رویداد توسط یک پشته ۷ لایه از خودتوجهی (Self-attention) پردازش میشوند، در حالی که رویدادهای قدیمیتر از طریق توجه متقاطع (Cross-attention) عبور کرده و تنها یک لایه تاریخچه کامل را طی میکنند. این ترفند هزینه استنتاج (Inference) را تقریباً نصف کرد در حالی که اکثر کیفیت توجه کامل (Full attention) حفظ شد.
- رمزگداز و ماژول رتبهبندی: یک رمزگداز ۲ لایه از طریق جستوجوی پرتویی (Beam Search) با عرض ۱۰۲۴، چندتاییهای شناسههای معنایی را تولید میکند. یک درخت پیشوندی (Catalog trie) برای مسدود کردن پیشوندهای نامعتبر استفاده میشود و هر چندتایی به تمام آهنگهایی که در آن مشترک هستند گسترش مییابد. سپس یک ماژول رتبهبندی، متشکل از چهار لایه توجه متقاطع، این آهنگها را در برابر حافظه مشترک رمزگذار امتیازدهی میکند.
آموزش از طریق تقطیر رولاوت (Rollout Distillation)
برای دستیابی به دقت بالا بدون استقرار مدلی عظیم در محیط عملیاتی، یاندکس از یک مدل «معلم» (Teacher) استفاده کرد که هرگز به تولید نمیرسد. این ترنسفورمر با ۰.۶ میلیارد پارامتر، روی دادههای تعاملی یک سال در دو مرحله آموزش دید: ابتدا پیشآموزش برای پیشبینی آیتم بعدی (Next-item-prediction) و سپس تنظیم دقیق رتبهبندی چندسره (Multi-head ranking fine-tuning). اهمیت مرحله اول بسیار زیاد بود؛ بهطوری که حذف پیشآموزش باعث افت صحت جفتهای وزنی (Weighted pair accuracy) از ۰.۶۲۱۵ به ۰.۶۱۵۳ شد.
از طریق فرآیندی به نام تقطیر رولاوت (Rollout Distillation)، مدل معلم به کاندیدهای تولیدشده توسط رمزگداز در طول آموزش و همچنین اثرات ثبتشده (Logged impressions) امتیاز میدهد. سپس ماژول رتبهبندی یاد میگیرد که با استفاده از میانگین خطای مطلق (MAE)، روی این امتیازها رگرسیون کند. تابع زیان مشترک به صورت L = L_NTP + L_rollout + L_impression تعریف شده است که در آن هر دو زیان، رمزگذار مشترک را بهروزرسانی میکنند.
زیرساخت و سرویسدهی
پس از تکمیل آموزش، مدل معلم حذف شده و تنها مدل بهینه Sona برای سرویسدهی باقی میماند. سرویسدهی از طریق NVIDIA Triton Inference Server با استفاده از گرافهای CUDA انجام میشود که به بهرهوری ۴۱ درصدی از FLOPs مدل دست یافته است.
این سیستم با یک حلقه آموزش مداوم آنلاین باقی میماند. رویدادها در پنجرههای ۱۵ دقیقهای به جلسات (Sessions) تبدیل شده و به یک آموزشدهنده GPU تغذیه میشوند. وزنهای جدید هر ۱۰ دقیقه یکبار به محیط سرویسدهی میرسند. تأخیر سرتاسری (End-to-end latency) در میانه (median) ۴۵ دقیقه و در p99 حدود ۶۰ دقیقه است.
نتایج عملیاتی
در یک تست A/B هفتروزه روی ۱۵ درصد از ترافیک زنده بلندگوهای هوشمند یاندکس، Sona جایگزین بیش از ۱۵ تولیدکننده کاندید، مرحله پیشرتبهبندی و مرحله رتبهبندی شد. این مدل دستاوردهای آماری قابلتوجهی نسبت به سیستم کنترل داشت:
- کاربران فعال (معیار اصلی): ۴.۵۳٪+
- کل زمان شنیدن: ۶.۳۰٪+
- لایکها: ۱۱.۴۲٪+
- دستورات تکراری: ۱۷.۹۹٪+
- کاربران با تعامل عمیق: ۷.۳۷٪+
این نتایج نشاندهنده بهبود ۲.۳۵ برابری نسبت به افزایشی است که مدل Argus (نسل قبلی ترنسفورمر یاندکس) ایجاد کرده بود (که افزایشی ۱.۹۳ درصدی بود).
مقایسه صنعتی
مدل Sona در حوزهای وارد شده است که سایر غولهای فناوری نیز در حال آزمایش سیستمهای زاینده سرتاسری هستند. مدل OneRec شرکت Kuaishou نیز از یک مدل رمزگذار-رمزگداز واحد برای ویدیوهای کوتاه استفاده میکند، اما همچنان به مسیرهای «مهندسی ویژگیهای چندمقیاسی» (شامل شناسه کاربر، سن و جنسیت) و یادگیری تقویتشده با مدل پاداش P-Score (ECPO) متکی است. همچنین مدلهای توصیهگر مولد Meta (HSTU) توصیهها را به عنوان تبدیل متوالی (Sequential transduction) روی اقدامات کاربر میبینند و از مقیاس عظیم ۱.۵ تریلیون پارامتر استفاده میکنند، هرچند آنها کل زنجیره فیلترها را به همان شیوهای که Sona انجام داد، جایگزین نکردهاند.
این چرخش راهبردی نشان میدهد که صنعت در حال حرکت از مجموعههای ویژگیهای دستچینشده توسط انسان به سمت نمایشهای معنایی آموختهشده است. یاندکس با یکپارچه کردن خط لوله، «اتلاف اطلاعاتی» را که در هنگام فیلتر شدن کاندیدها توسط چندین مدل مجزا رخ میداد، به حداقل رسانده است.
اگرچه دستاوردهای Sona چشمگیر است، اما این مدل بهصورت خارجی قابل استقرار نیست، زیرا یاندکس کدها یا وزنهای آن را منتشر نکرده است. اکنون صنعت با این پرسش روبروست که آیا هزینه محاسباتی رمزگشایی زاینده (Generative decoding) میتواند در تمام سطوح مقیاسپذیر شود یا اینکه محدود به دامنههای خاص و با ارزش بالا مانند استریم موسیقی باقی خواهد ماند.
گام بعدی شما
- اگر روی سیستمهای توصیهگر کار میکنید، معماری Sona را به عنوان جایگزینی برای مدلهای چندمرحلهای (Multi-stage) بررسی کنید.
- برای درک بهتر تبدیل سیگنالهای صوتی به توکنهای معنایی، مقالات مربوط به Semantic IDs و InfoNCE را مطالعه کنید.
- انتشار وزنهای باز مدلهای HSTU در گیتهاب را دنبال کنید تا شباهتهای این رویکرد با مدلهای متای ۱.۵ تریلیونی را بسنجید.
اما چالش اصلی اکنون مقیاسپذیری هزینه محاسباتی رمزگشایی مولد در تمام سطوح است — به تحلیل ما درباره بهینهسازیهای استنتاج در مدلهای بزرگ مراجعه کنید.



گفتگو