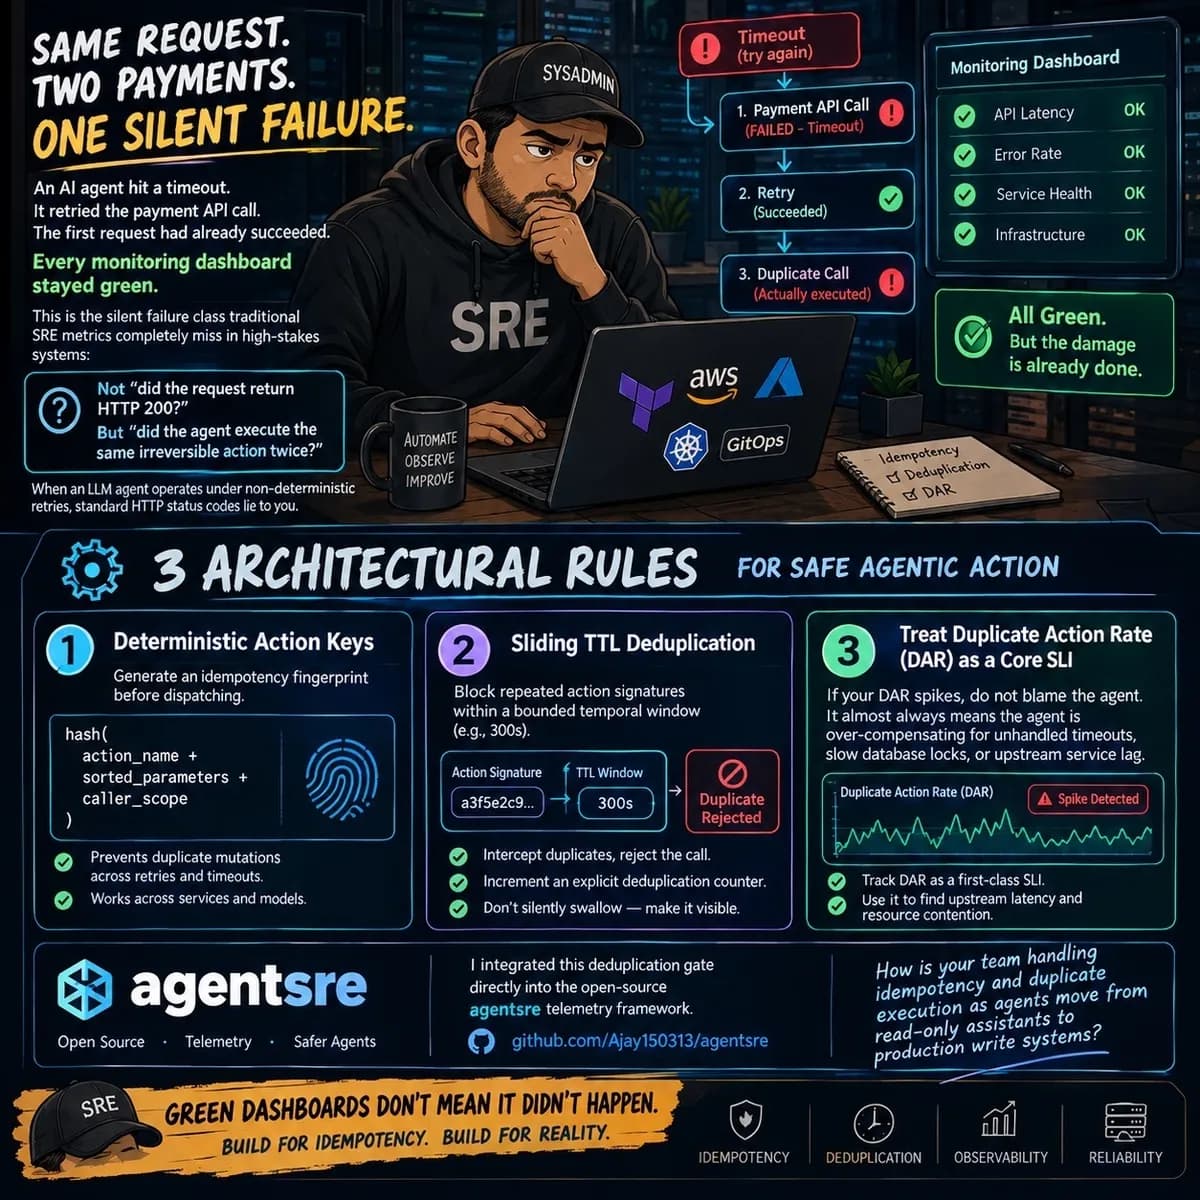
تصور کنید یک مدیر محصول است که تمام داشبوردهای نظارتیاش سبز هستند، اما مشتریان از پرداخت دوبرابار هزینه برای یک سفارش شکایت میکنند. این کابوس زمانی رخ میدهد که یک عامل (Agent) — شبیه دستیاری که دستورات شما را اجرا میکند اما گاهی در میانه راه گیج میشود — پس از یک خطای زمانی (Timeout)، عملیاتی را که در واقع موفقیتآمیز بوده، دوباره تکرار کند. این شکست خاموش زمانی اتفاق میافتد که یک عامل درخواستی را که در حقیقت با موفقیت انجام شده است، مجدداً ارسال کند؛ ریسکی که در یک گزارش فنی منتشر شده در ۱۷ اکتبر ۲۰۲۶ در وبسایت dev.to برجسته شده است.
bیشتر متریکهای SRE (مهندسی قابلیت اطمینان سیستم) تنها این سوال را میپرسند که آیا یک درخواست کد وضعیت HTTP 200 برگردانده است یا خیر. اما برای عاملهایی که دسترسی نوشتاری (Write Access) دارند، سوال حیاتی این است که آیا عامل همان اقدام غیرقابلبازگشت را دو بار اجرا کرده است یا خیر. وقتی مدلهای زبانی بزرگ (LLMs) تحت تلاشهای مجدد غیرقطعی (Non-deterministic retries) عمل میکنند، کدهای وضعیت استاندارد دیگر حقیقتِ وضعیت سیستم را بازتاب نمیدهند.
همانطور که در تحلیلهای قبلی ما دربارهی امنیت مدلهای عاملمحور اشاره کردیم، مدیریت دسترسیهای نوشتاری ریسکهای بسیار بالاتری نسبت به دستیارهای صرفاً خواندنی دارد. در همین راستا، پیادهسازی یک لایه مجوز برای کنترل دقیق دسترسیها میتواند مانع از اجرای غیرمجاز یا اشتباه APIها توسط عاملها شود.
مکانیسم شکست در عاملها
طبق این گزارش، عاملها مشکل تکرار را تشدید میکنند چون تلاشهای مجدد اغلب در لایههای مختلف روی هم انباشته میشوند. یک کلاینت HTTP ممکن است تلاش مجدد کند، سپس یک چارچوب ارکستراسیون (Orchestration) تلاش مجدد انجام دهد و در نهایت خودِ مدل تصمیم بگیرد که «دوباره امتحان کند». هر لایه تصور میکند که تنها مدیریتکنندهٔ منطق تکرار است.
علاوه بر این، عاملها میتوانند برنامهریزی خود را تغییر داده و عملیات را با پارامترهایی اندکی متفاوت یا ترتیب کلیدهای متفاوت صادر کنند. چون مدل ممکن است بعد از یک Timeout، درخواست را بازنویسی یا بازگو کند، سیستمهای سطح پایینتر اغلب نمیتوانند این درخواستها را به عنوان نسخههای تکراری شناسایی کنند. در این موارد، یک Timeout به جای اینکه به عنوان «شکست»، به عنوان وضعیتی «نامعلوم» تلقی میشود و عامل تمایل دارد حدس بزند که باید صرفاً دوباره آن را انجام دهد. این نوع عدم قطعیت در تشخیص وضعیت عملیات، مشابه چالشی است که در پروژه Oathra برای حذف توهم موفقیت در عاملهای صوتی مورد بررسی قرار گرفت.
جزئیات پیادهسازی برای مسیرهای نوشتاری
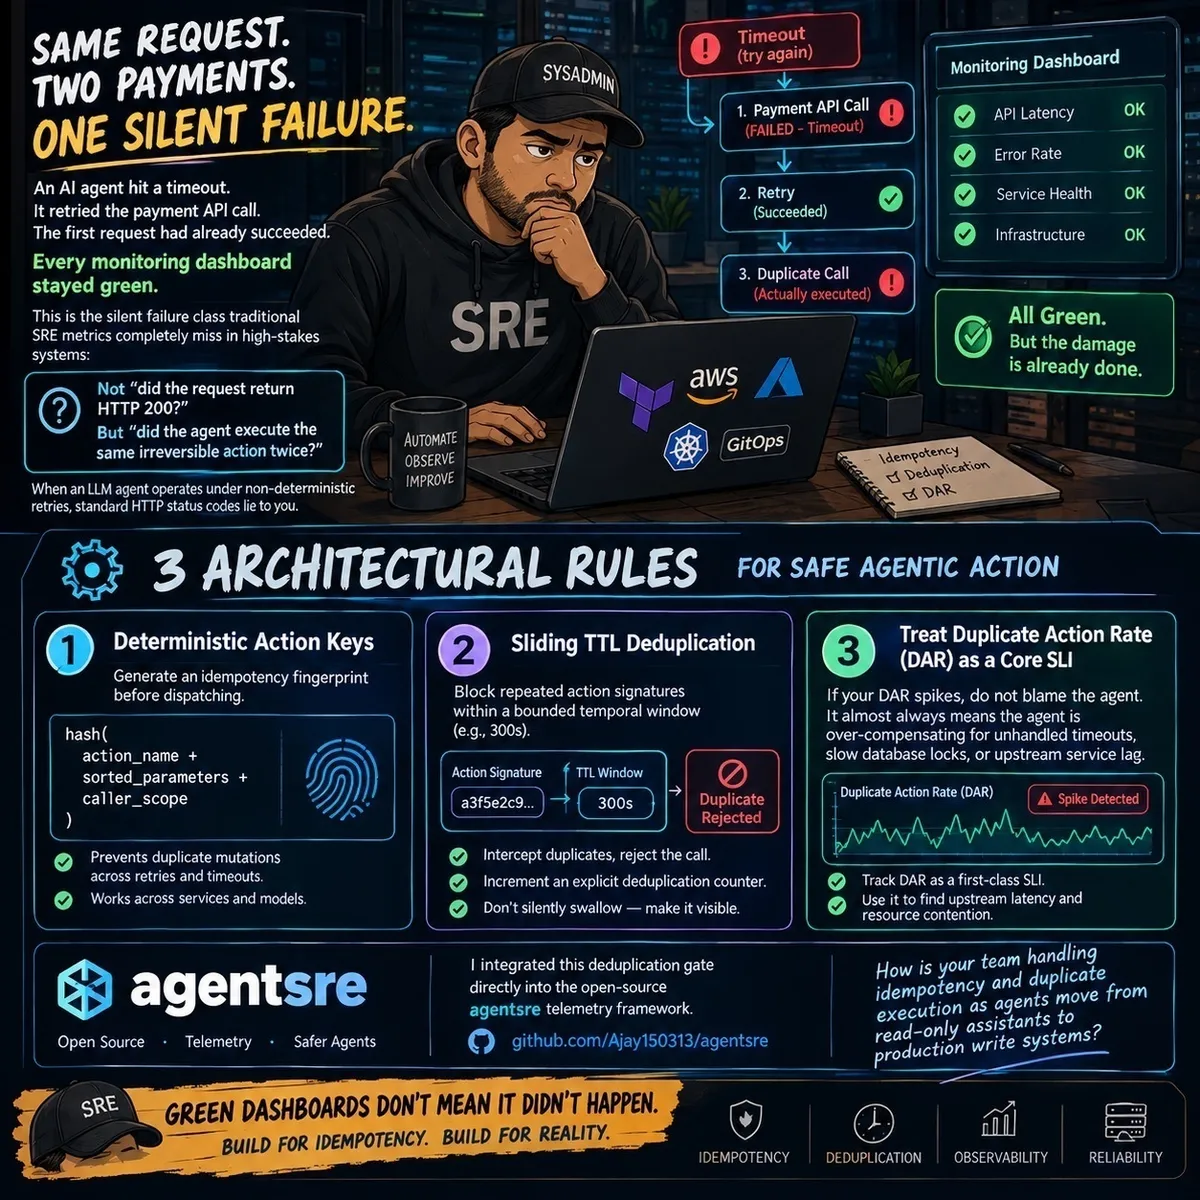
برای حل این مشکل، گزارش مذکور سه قانون برای مسیرهای حساس نوشتاری پیشنهاد میکند:
- کلیدهای عملیاتی قطعی (Deterministic Action Keys): ایجاد اثر انگشت برای هر عملیات از طریق هش کردن نام عملیات، پارامترهای مرتبشده و محدوده فراخوان (Caller Scope) تا اطمینان حاصل شود که محمولههای (Payloads) منطقاً یکسان، کلید یکسانی تولید کنند. فرمول مورد استفاده
key = hash(action_name + sorted_parameters + caller_scope)است. در اینجا نرمالسازی انواع دادهها و مرتبسازی کلیدها ضروری است تا ورودیهای منطقاً یکسان به یک مقدار هش یکسان تبدیل شوند. - حذف تکرار با TTL لغزنده (Sliding TTL Deduplication): مسدود کردن امضاهای تکراری در یک بازه زمانی محدود (مثلاً ۳۰۰ ثانیه). سیستم نباید تکرارها را بیصدا حذف کند — زیرا این کار باگهای زیربنایی را پنهان میکند — بلکه باید تماس را رهگیری کرده، آن را با یک خطای صریح رد کند و یک شمارنده را افزایش دهد. مفهوم «لغزنده» به این معناست که هر تلاش مسدود شده، بازه زمانی را بازنشانی (Refresh) میکند تا اطمینان حاصل شود عاملی که در یک حلقه (Loop) گیر کرده است، مسدود باقی میماند.
- نرخ عملیات تکراری (DAR): پیادهسازی یک شاخص سطح خدمات (SLI) جدید که به صورت
blocked_duplicate_actions / total_action_attemptsمحاسبه میشود.
حفاظهای فنی و نکات کلیدی
بر اساس مستندات dev.to، جهش در نرخ DAR معمولاً نشاندهندهٔ Timeoutهای مدیریتنشده، قفلهای کند در پایگاهداده یا تأخیر در سیستمهای بالادستی است، نه لزوماً نقص در منطق عامل. DAR اغلب این مشکلات زیرساختی را پیش از آنکه مشتریان متوجه شوند، آشکار میکند. نویسنده این منطق را در چارچوب تلهمتری متنباز agentsre ادغام کرده است تا دید کافی نسبت به این شکستها فراهم شود.
برای توسعهدهندگان، این یعنی عبور از مفهوم سادهٔ Idempotency در API. در حالی که کلیدهای Idempotency در سطح ارائهدهنده (Provider) از اختلالات شبکه محافظت میکنند، یک گیت حذف تکرار (Deduplication Gate) سیستم را از رفتارهای غیرقطعی خودِ عامل محافظت میکند.
در پیادهسازی این سیستم، چند نکته حیاتی (Gotchas) وجود دارد:
- Timeoutهای مبهم: هرگز کلید را در زمان وقوع Timeout آزاد نکنید. توسعهدهندگان باید ابتدا وضعیت را با سیستم پاییندستی تطبیق دهند. کلیدها تنها در صورت شکستهای قطعی (مانند خطای
PaymentDeclined) باید آزاد شوند. - مقیاسپذیری وضعیت: گیتهای حافظه داخلی (In-memory) فقط برای یک پروسه واحد کار میکنند. برای چندین Worker، گیت باید توسط یک ذخیرهساز اتمیک مشترک پشتیبانی شود؛ مانند Redis با استفاده از دستور
SET key value NX EX 300یا یک نوشتن شرطی (Conditional Write) در DynamoDB. - تکرارهای مشروع: دو انتقال ۱۰ دلاری که به طور عمدی انجام شدهاند، تکراری نیستند. برای مدیریت این مورد، یک «شناسه قصد» (Intent ID) باید در کلید گنجانده شود تا تفاوت بین یک حلقه تکرار و یک تکرار هدفمند مشخص گردد.
این تغییر، فرض بنیادی دربارهٔ قابلیت اطمینان عاملها را عوض میکند. دیگر نمیتوان به این باور بود که یک تلاش مجددِ «موفق»، لزوماً یک عملیات پاک و بدون خطا بوده است. با ارسال کلید عملیات به عنوان کلید Idempotency ارائهدهنده، توسعهدهندگان یک «دفاع در عمق» ایجاد میکنند: گیت از سیستم در برابر عامل محافظت میکند و کلید ارائهدهنده از سیستم در برابر هر چیز دیگری محافظت میکند.
اگر در حال انتقال عاملها از دستیارهای صرفاً خواندنی به سیستمهای نوشتاری در محیط عملیاتی هستید، باید این گیتها را در هر دو لایه عامل و API پیادهسازی کنید تا از فساد دادهها یا خسارات مالی جلوگیری شود.
گام بعدی شما
- اگر از عاملهایی با دسترسی Write استفاده میکنید، نرخ DAR را به عنوان یک متریک نظارتی اضافه کنید.
- برای تمامی عملیاتهای مالی یا حساس، یک لایه Deduplication بر پایه Redis پیادهسازی کنید.
- منطق آزاد کردن کلیدها را از حالت «زمانمحور» به حالت «وضعیتمحور» تغییر دهید.
اما داستان سختافزاری این تحول و تأثیر تأخیرهای GPU بر نرخ DAR حتی شگفتانگیزتر است — به تحلیل ما دربارهی تراشههای Blackwell مراجعه کنید.



گفتگو