تصور کنید یک عامل کدنویس (Coding Agent) ماموریت دارد تا نام ستون users.name را به full_name تغییر دهد. این عامل با دقت مدل داده را بهروز میکند، تمام کوئریهای موجود در پروژه را اصلاح میکند و یک مهاجرت (Migration) تکخطی مینویسد: ALTER TABLE users RENAME COLUMN name TO full_name;.
در محیط تست، همه چیز عالی به نظر میرسد و تستها پاس میشوند، زیرا تستها روی یک نسخه واحد از کد اجرا میشوند. اما همین دستور ساده RENAME COLUMN میتواند در محیط عملیاتی (Production) باعث سقوط فوری کل سیستم شود.
دلیل این اتفاق ساده است: در محیطهای واقعی، دو نسخه از کد همزمان اجرا میشوند. در یک استقرار Kubernetes، فرآیند Rollout باعث میشود ReplicaSet جدید بالا بیاید و همزمان ReplicaSet قدیمی پایین برود. با تنظیمات پیشفرض maxUnavailable و maxSurge که معمولاً ۲۵٪ است، پادهای قدیمی و جدید برای مدتی در کنار هم ترافیک را مدیریت میکنند. مهاجرت شما یکبار اجرا میشود، دقیقاً قبل یا در حین این بازه زمانی. هر پاد قدیمی که پس از تغییر نام ستون هنوز زنده است، دستور SELECT name ... را به جدولی میفرستد که دیگر ستونی به نام name ندارد.
همانطور که در تحلیل قبلی ما دربارهی اینکه چگونه سرورهای MCP میتوانند پنجره زمینه (Context Window) یک عامل را هدر دهند اشاره کردیم، این مسئله یک شکاف عمیقتر را برجسته میکند: عاملهای هوش مصنوعی اغلب فاقد «زمینه عملیاتی» (Operational Context) در مورد نحوه استقرار واقعی کد هستند. آنها کدبیس را به صورت یک موجود ایستا میبینند، نه یک سیستم زنده که در آن نسخههای مختلف کد همزمان در حال اجرا هستند.
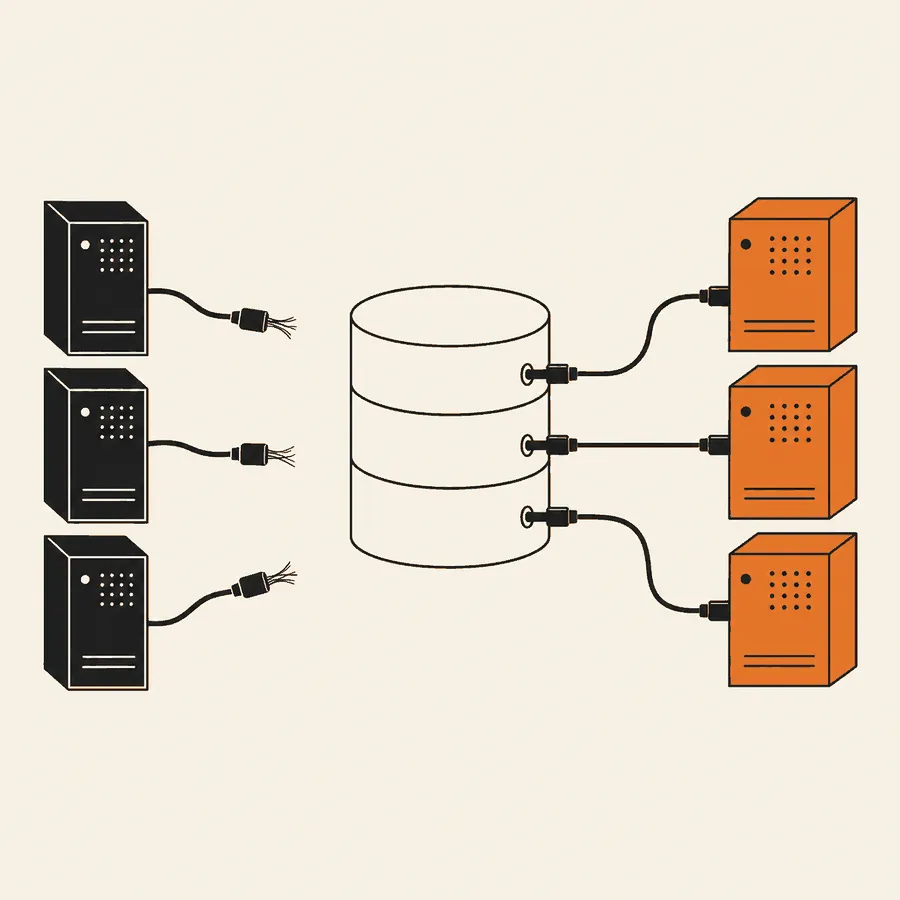
بر اساس یک راهنمای فنی منتشر شده در xgabriel.com، این شکست به دلیل عدم تطابق کد و طرحواره (Code-Schema Mismatch) رخ میدهد. در واقع دو شکست مجزا در آن یک خط SQL نهفته است: اول، اگر تغییر نام را قبل از استقرار کد جدید اجرا کنید، پادهای قدیمی شکست میخورند. دوم، اگر ابتدا کد را مستقر کنید، پادهای جدید تا زمان اجرای مهاجرت شکست میخورند. هیچ ترتیب واحدی برای یک تغییر نام تکخطی وجود ندارد که هر دو نسخه را راضی نگه دارد. به همین دلیل است که در فایل README ابزار strong_migrations صراحتاً ذکر شده است: «تغییر نام ستونی که در حال استفاده است، باعث بروز خطا در برنامه شما خواهد شد.» ابزار تحلیل کد Squawk نیز دقیقاً به همین دلیل قانونی به نام renaming-column دارد.
علاوه بر عدم تطابق، خطر قفل شدن پایگاهداده (Database Lock) نیز وجود دارد. در Postgres، دستور ALTER TABLE یک قفل انحصاری (ACCESS EXCLUSIVE) ایجاد میکند، مگر اینکه صراحتاً ذکر شود. این حالت با هر حالت قفل دیگری، از جمله قفل ACCESS SHARE که یک دستور SELECT ساده میگیرد، تداخل دارد. اگرچه مستندات پستگرس بیان میکنند که تغییر نام «تاثیری بر دادههای ذخیره شده ندارد»، اما این قفل است که عامل تخریب است.
اگر یک تراکنش طولانی از قبل در حال اجرا باشد، دستور تغییر نام در یک صف انتظار میماند. همانطور که در تحلیل Xata درباره صف قفلها توضیح داده شده است، هر دستور بعدی که نیاز به قفل روی آن جدول داشته باشد، پشت دستور تغییر نام صف میکشد. این وضعیت عملاً جدول را برای تمام عملیات خواندن و نوشتن مسدود میکند تا زمانی که تغییر نام به پایان برسد یا متوقف شود.
آزمایشگاه: شبیهسازی شکست
برای مشاهده این وضعیت در عمل، میتوانید یک نمونه Postgres 18 را با استفاده از داکر اجرا کنید:
docker run -d --name pg -e POSTGRES_PASSWORD=pw postgres:18
سپس جدولی با ۲۰۰,۰۰۰ ردیف ایجاد کنید:
CREATE TABLE users (
  id bigint GENERATED ALWAYS AS IDENTITY PRIMARY KEY,
  name text NOT NULL
);
INSERT INTO users (name) SELECT 'user ' || g FROM generate_series(1, 200000) g;
برای شبیهسازی استقرار (Rollout)، دو فایل ایجاد کنید که نسخههای مختلف ایمیج را نمایندگی کنند. «برنامه قدیمی» این دستورات را اجرا میکند:
INSERT INTO users (name) VALUES ('Old Pod Writer');
SELECT id, name FROM users ORDER BY id DESC LIMIT 1;
و «برنامه جدید» این دستورات را اجرا میکند:
INSERT INTO users (full_name) VALUES ('New Pod Writer');
SELECT id, full_name FROM users ORDER BY id DESC LIMIT 1;
در حال حاضر، برنامه قدیمی کار میکند و برنامه جدید شکست میخورد. اگر تغییر نام پیشنهادی عامل هوش مصنوعی را اعمال کنید، نتیجه برعکس میشود: برنامه قدیمی فوراً با خطای «ستون وجود ندارد» شکست میخورد. این جابجایی دقیقاً همان اتفاقی است که در یک استقرار تدریجی (Rolling Deploy) رخ میدهد.
برای مشاهده صف قفل، سه ترمینال باز کنید. در ترمینال A، یک تراکنش را با BEGIN; SELECT count(*) FROM users; شروع کنید و آن را باز نگه دارید. در ترمینال B، دستور ALTER TABLE برای تغییر نام را اجرا کنید؛ این دستور متوقف شده و منتظر A میماند. در ترمینال C، یک دستور ساده SELECT id FROM users LIMIT 1; اجرا کنید؛ این دستور نیز متوقف شده و پشت B صف میکشد.
اگر B را با Ctrl-C لغو کنید، C فوراً پاسخ میدهد. برای جلوگیری از این وضعیت گروگانگیری، میتوانید در ترمینال B دستور SET lock_timeout = '2s'; را اجرا کنید. در این صورت، تغییر نام پس از دو ثانیه با خطای lock-timeout متوقف میشود. از آنجایی که lock_timeout برای هر تلاش برای کسب قفل بهطور جداگانه اعمال میشود، این تنظیم برای هر مهاجرتی که اجرا میکنید ضروری است.
راهکار چهارمرحلهای «گسترش-انقباض» (Expand-Contract)
برای اجتناب از این بحران، توسعهدهندگان باید از الگوی «تغییر موازی» (Parallel Change) استفاده کنند که توسط دانیلو ساتو در سال ۲۰۱۴ توصیف شد. این روش ابتدا رابط را برای پشتیبانی از هر دو نسخه قدیمی و جدید گسترش داده و سپس آن را به نسخه جدید منقبض میکند.
گام اول: گسترش بدون قفل طولانی
یک مهاجرت مستقر کنید که ستون جدید را به صورت nullable (پذیرنده مقدار تهی) اضافه کند. در این مرحله هنوز هیچ تغییری در کد برنامه ایجاد نمیشود. سپس یک تریگر BEFORE INSERT OR UPDATE بسازید تا ستونهای قدیمی و جدید را همگام نگه دارد.
SET lock_timeout = '2s';
SET statement_timeout = '10s';
BEGIN;
ALTER TABLE users ADD COLUMN full_name text;
CREATE FUNCTION users_sync_name() RETURNS trigger LANGUAGE plpgsql AS $
BEGIN
  IF TG_OP = 'INSERT' THEN
    NEW.full_name := coalesce(NEW.full_name, NEW.name);
    NEW.name := coalesce(NEW.name, NEW.full_name);
  ELSIF NEW.name IS DISTINCT FROM OLD.name THEN
    NEW.full_name := NEW.name;
  ELSIF NEW.full_name IS DISTINCT FROM OLD.full_name THEN
    NEW.name := NEW.full_name;
  END IF;
  RETURN NEW;
END $
CREATE TRIGGER users_sync_name BEFORE INSERT OR UPDATE ON users FOR EACH ROW EXECUTE FUNCTION users_sync_name();
COMMIT;
این دستور را با docker exec -i pg psql -U postgres -v ON_ERROR_STOP=1 < 001_expand.sql اجرا کنید. اگر قفل با تایماوت مواجه شود، psql با وضعیت ۳ خارج میشود، تراکنش rollback شده و شما بهسادگی آن را دوباره اجرا میکنید. سه جزئیات این مرحله را ایمن میکند:
- عدم بازنویسی جدول: افزودن ستون بدون مقدار پیشفرض، به ردیفهای موجود مقدار NULL میدهد. مستندات
ALTER TABLEتایید میکنند که در این حالت نیازی به بازنویسی جدول نیست، بنابراین قفل انحصاری فقط برای مدت کوتاهی نگه داشته میشود. - منطق تریگر: تریگر ردیفی
BEFOREمقدارnameرا قبل از اجرای بررسیNOT NULLپر میکند، که به برنامه جدید اجازه میدهد بدون نام بردن از ستون قدیمی، دادهها را درج کند. - همگامسازی دوطرفه: شاخه
UPDATEمقادیر را از هر ستونی که تغییر کرده کپی میکند و تضمین میکند که نویسندهای در هر یک از نسخهها، مقدارش توسط نسخه دیگر بازنویسی نشود.
گام دوم: پر کردن دادههای قدیمی در دستههای کوچک (Backfill)
ردیفهای موجود هنوز ستون full_name خالی دارند. هرگز از یک دستور بزرگ UPDATE users SET full_name = name استفاده نکنید، زیرا این کار قفلهای ردیفی را روی تمام ردیفها در یک تراکنش طولانی نگه میدارد. در عوض، از اصول strong_migrations پیروی کنید: دستهبندی (Batching)، کنترل سرعت (Throttling) و اجرا خارج از تراکنش.
- دستهبندی: از اسکریپتی استفاده کنید که بر اساس کلید اصلی (Primary Key) باشد تا هر دسته از جایی شروع شود که دسته قبلی متوقف شده است. یک دسته ۱۰۰۰ تایی به این شکل است:
SET lock_timeout = '2s';
SET statement_timeout = '30s';
WITH batch AS (
  SELECT id FROM users WHERE id > :last ORDER BY id LIMIT 1000
), upd AS (
  UPDATE users u SET full_name = u.name FROM batch b WHERE u.id = b.id AND u.full_name IS NULL
)
SELECT coalesce(max(id), 0) FROM batch;
- اجرا: پستگرس دستورات تغییر داده در
WITHرا دقیقاً یکبار و تا انتها اجرا میکند. این را در یک حلقه bash با استفاده از psql در حالت autocommit اجرا کنید تا هر دسته تراکنش خود باشد. برای کنترل فشار روی سیستم، بین دستههاsleep 0.2قرار دهید. - تایماوتها: مقدار
statement_timeout = '30s'را تنظیم کنید. اگر یک دسته با تایماوت مواجه شد، بهطور خودکار rollback شده و حلقه همان محدوده را دوباره امتحان میکند.
قبل از ادامه، تایید کنید که دستور SELECT count(*) FROM users WHERE full_name IS DISTINCT FROM name; مقدار صفر را برمیگرداند.
گام سوم: تغییر کد
نسخه جدید برنامه (Deploy 2) را مستقر کنید که فقط از full_name برای خواندن و نوشتن استفاده میکند. در طول این استقرار، پادهای قدیمی هنوز به name مینویسند و تریگر آن را کپی میکند. پادهای جدید به full_name مینویسند و تریگر آن را به عقب برمیگرداند، بنابراین پادهای قدیمی که name را میخوانند، همچنان آخرین دادهها را میبینند. این امر امکان بازگشت (Rollback) ایمن به ایمیج قدیمی را بدون از دست دادن دادهها فراهم میکند.
اگر ستون جدید باید NOT NULL باشد، Postgres 18 اجازه میدهد محدودیت را به صورت NOT VALID اضافه کنید. سپس میتوانید یک دستور جداگانه VALIDATE CONSTRAINT اجرا کنید:
SET lock_timeout = '2s';
SET statement_timeout = '15min';
ALTER TABLE users ADD CONSTRAINT users_full_name_nn NOT NULL full_name NOT VALID;
ALTER TABLE users VALIDATE CONSTRAINT users_full_name_nn;
مقدار statement_timeout به ۱۵ دقیقه افزایش یافته است زیرا VALIDATE کل جدول را اسکن میکند. با این حال، این دستور فقط قفل SHARE UPDATE EXCLUSIVE میگیرد، بنابراین خواندن و نوشتن بدون وقفه ادامه مییابد.
گام چهارم: انقباض طرحواره
زمانی که هیچ کدی از ستون قدیمی استفاده نکرد و پنجره بازگشت بسته شد، ستون قدیمی را در یک استقرار مجزا (Deploy 3) حذف کنید.
SET lock_timeout = '2s';
SET statement_timeout = '10s';
BEGIN;
DROP TRIGGER users_sync_name ON users;
DROP FUNCTION users_sync_name();
ALTER TABLE users DROP COLUMN name;
COMMIT;
دستور DROP COLUMN سریع است زیرا پستگرس ستون را فوراً بهطور فیزیکی حذف نمیکند؛ بلکه فقط آن را برای SQL نامرئی میکند و فضا در اولین بازنویسی جدول reclaimed میشود. توجه داشته باشید که برخی ORMها مانند Active Record در Rails، ستونها را هنگام بوت کش میکنند. در چنین مواردی، باید ابتدا ستون را به ignored_columns اضافه کرده و مستقر کنید و سپس دستور drop را اجرا نمایید.
خودکارسازی نردههای حفاظتی عاملها
برای جلوگیری از پیشنهاد دستورات تکخطی خطرناک توسط عاملها، میتوانید قوانین محدود به مسیر (Path-scoped rules) را پیاده کنید. برای Claude Code، قوانین در .claude/rules/ (بهویژه برای migrations/**/*.sql) میتوانند صراحتاً RENAME COLUMN را روی جداول فعال ممنوع کرده و طرح چهارمرحلهای را اجباری کنند. این قوانین باید به عامل دستور دهند که:
- به جای تغییر نام، طرح گسترش-انقباض (Expand-Contract) را پیشنهاد دهد.
- از
ADD COLUMN(به صورت nullable و بدون مقدار پیشفرض متغیر) همراه با تریگرBEFOREاستفاده کند. - عملیات Backfill را به صورت اسکریپتهای دستهبندی شده جداگانه نگه دارد و هرگز آنها را بخشی از مهاجرت نکند.
- هر مهاجرت را با
SET lock_timeoutوSET statement_timeoutشروع کند. - دستور
DROP COLUMNرا در یک استقرار جداگانه و بعدی قرار دهد. - هنگامی که تغییر نام درخواست شد، طرح ۴ مرحلهای را بنویسد و فقط مرحله ۱ را در تغییر فعلی قرار دهد.
برای اجرای گستردهتر، این موارد را در AGENTS.md برای سایر عاملهای کدنویس کپی کنید. با این حال، از آنجایی که Claude با قوانین به عنوان «زمینه» برخورد میکند و نه «پیکربندی اجباری»، به بررسی نیاز دارید که اهمیتی ندهد چه کسی SQL را نوشته است. ابزار Squawk را در CI یا از طریق squawk-action روی Pull Requestها اجرا کنید. Squawk میتواند خطاهای renaming-column را شناسایی کرده و تضمین کند که هر مهاجرت شامل تایماوتهای اجباری از طریق require-lock-timeout و require-statement-timeout باشد. همچنین حذفهای مرحله ۴ را علامتگذاری میکند که هدفمند است، زیرا این تنها مهاجرتی است که یک انسان باید قبل از ارسال بهطور دستی بررسی کند.
برای کسانی که به دنبال خودکارسازی کامل هستند، ابزارهایی مانند pgroll میتوانند منطق افزودن ستون، Backfill و تریگر همگامسازی را بهطور خودکار از طریق ارائه نسخههای مختلف طرحواره از طریق Viewها مدیریت کنند.
این تغییر در رویکرد، مهاجرتهای پایگاهداده را از ذهنیت «یک رویداد واحد» به ذهنیت «چرخه عمر» منتقل میکند. این امر اذعان میکند که در سیستمهای توزیعشده مدرن، طرحواره یک وضعیت ایستا نیست، بلکه یک گذار (Transition) است. این چالشها یادآور محدودیتهایی است که در مراحل حساس مهاجرت SAP مشاهده شد، جایی که دسترسی مستقیم عاملهای هوش مصنوعی به دلیل ریسکهای عملیاتی محدود گردید.
برای توسعهدهندگانی که سیستمهای با ترافیک بالا را مدیریت میکنند، هزینه این حسابوکتابها، بهای دسترسی بدون وقفه (Zero-downtime availability) است. نادیده گرفتن آن به معنای سپردن کلیدهای صف قفل محیط عملیاتی به یک عامل هوش مصنوعی است.
برای بررسی عمیقتر این تصمیمات معماری، Database Playbook (و سری مرتبط Thinking in Go درباره معماری Hexagonal) چارچوبی جامع برای انتخاب ذخیرهسازهایی ارائه میدهد که میتوانند این تغییرات طرحواره را تحت بار واقعی مدیریت کنند. در همین راستا، آنتروپیک برای جلوگیری از خطاهای مشابه در سطح ابزارها، راهکار جداسازی نام از شناسه را معرفی کرد تا تغییرات در نامها باعث شکست در فراخوانی توابع نشود.



گفتگو