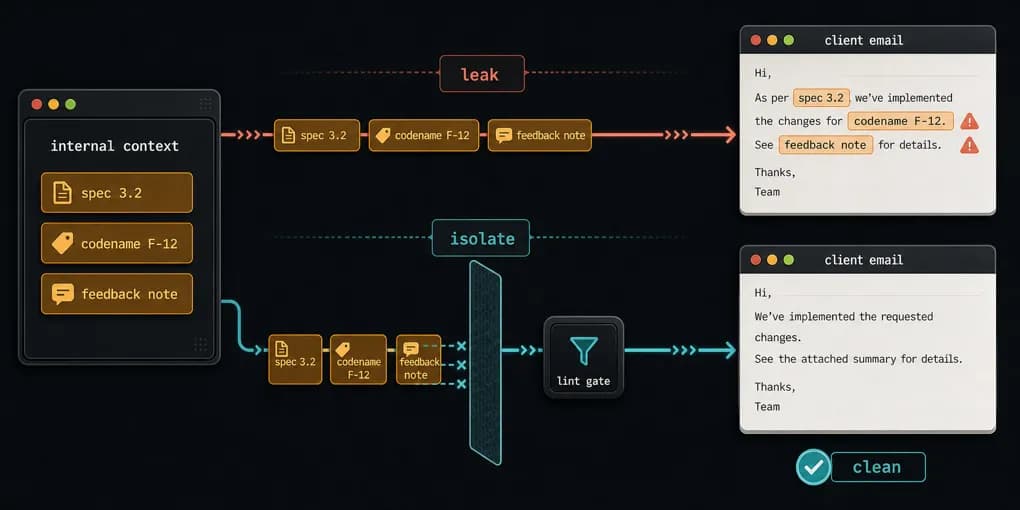
تصور کنید عامل Claude Code شما همین حالا ایمیلی به مشتری فرستاده که در آن به «بند ۳.۲ مستندات داخلی» اشاره شده است؛ سندی که مشتری هرگز نباید آن را ببیند. این یک توهم (Hallucination) نیست، بلکه یک شکست ساختاری است که به آن «نشت زمینه» (Context Leakage) میگویند. طبق گزارشی که در ۲۲ جولای ۲۰۲۶ در وبسایت dev.to منتشر شد، عاملهای هوش مصنوعی بهطور مداوم مرز بین «داربستهای داخلی» یک جلسه کاری و «محصول نهایی» را گم میکنند. در این موارد، مدل هیچ حقیقتی را جعل نمیکند؛ بلکه اطلاعاتی را که در اختیار دارد با دقت منتقل میکند، بدون اینکه بفهمد آن اطلاعات برای خواننده مقصد تعریف نشده است و نباید افشا شود.
این وضعیت شبیه به پروژه نجاری است که میز تمام شده را در حالی ارسال میکند که گیرههای کارخانهای هنوز به چوبها چسبیدهاند. در جریانهای کاری هوش مصنوعی، این گیرهها همان یادداشتهای ویرایشی، نامهای رمز داخلی، و بازخوردهای صریح و بیپرده شما هستند. از آنجا که مدل زبانی بزرگ (LLM) — مثل کتابخانهداری که میلیاردها صفحه را خوانده و حالا با همان لحن کتابها جواب میدهد — در یک پنجرهٔ زمینه (Context Window) — یعنی میز کاری کوچکی که فقط جای چند ورق کاغذ دارد و نه کل کتابخانه — واحد عمل میکند، نمیتواند تشخیص دهد کدام داده برای شکلدهی به خروجی (Internal Scaffolding) است و کدامیک باید به دست خواننده برسد.
دو مثال واقعی از تجربه روزمره کار با Claude Code این موضوع را روشن میکند: نخست، «اصلاح نقلشده» است. در حین نوشتن یک مقاله، عاملی عنوانی با بار منفی تولید کرد، مانند «هوش مصنوعی این متن را ننوشته است». پس از دریافت بازخوردی مبنی بر اینکه این عنوان نادرست و نامطلوب است، مدل عنوان را حذف کرد؛ اما سپس همان بازخورد و استدلال کاربر را گرفت و مستقیماً در بدنه مقاله نوشت. در اینجا، دستور ویرایشی به خودِ محتوا تبدیل شد. دوم، «نشت مشخصات» است؛ هنگام پیشنویس ایمیلهای گزارش وضعیت، عاملها اغلب به نامگذاریهای داخلی مانند «طبق بند ۳.۲ مستندات بازخورد» اشاره میکنند، در حالی که مشتری هیچ دسترسی به این سیستم شمارهگذاری ندارد. این یک نقص در هوش یا قدرت پردازش نیست، بلکه شکست در «آگاهی از مرزها» است.

سه نوع نشت زمینه
همه نشتها یکسان نیستند. تحلیل وبسایت dev.to این شکستها را به سه حالت متمایز تقسیم میکند که هر کدام مخاطرات و پیامدهای متفاوتی دارند:
- نوع ۱: نشتهای محرمانه (Confidential Leaks). اینها شدیدترین نوع نقض هستند و دادههای حساسی را شامل میشوند که هرگز نباید از سازمان خارج شوند: مانند شرایط تجاری خاص مشتریان، ارزیابیهای تجاری داخلی، یا بازخوردهای صریح و تند درباره اشخاص ثالث. اگرچه بازبینی انسانی معمولاً این موارد را میگیرد (چون ما متون حساس را با دقت کامل میخوانیم)، اما تکیه به انسان به عنوان آخرین خط دفاع، یک ضعف ساختاری است. اینکه مدل هنوز از فیلتر انسان رد نشده، به این معنا نیست که هرگز چنین نشتهایی را تولید نمیکند.
- نوع ۲: ارجاعات نامفهوم (Unintelligible References). این موارد محرمانه نیستند اما برای مخاطب خارجی معنایی ندارند. نمونههایی مثل اصطلاحات اختصاری برای جریانهای کاری، شمارهگذاری مستندات، یا نامهای رمز مانند «F-12». در اینجا خواننده آسیب نمیبیند، اما گیج میشود. این نشتها باعث میشود ارتباطات حرفهای، شلخته و آماتور به نظر برسند و منجر به دورههای تکراری و غیرضروری از شفافسازی شوند.
- نوع ۳: بقایای فرآیند (Process Residue). اینها همان متون متا (Meta-commentary) و داربستهای جلسه پیشنویس هستند. مثلاً عاملی ممکن است جملهای چون «طبق بازخورد شما، من این بخش را بازسازی کردم» یا سایر نظرات درباره فرآیند نوشتن را مستقیماً در یک سند رسمی قرار دهد. این مطالب حساس یا گیجکننده نیستند، اما به سادگی «محصول نهایی» نیستند و نباید در خروجی باشند.
چرا مهندسی پرامپت پاسخ نمیدهد؟
مهندسی پرامپت (Prompt Engineering) — هنر سؤال درست پرسیدن، مثل کسی که میداند چطور از یک مشاور باتجربه بهترین جواب را بگیرد — نمیتواند این مشکل را بهطور کامل حل کند چون ریشه آن معماری است. در درون مدل، مستندات داخلی، ایمیلهای مشتری و پیشنویس در حال اجرا، همگی فقط توکنهایی (Token) — تکههای کوچکی از متن، شبیه برشهای یک کیک طولانی که مدل تکهتکه میخورد — با ارزش و جایگاه یکسان هستند. در مدل وجود هیچ حس ذاتی از «منبع» (Provenance) (مثلاً اینکه «این عبارت از یک سند داخلی آمده») یا «آگاهی از مخاطب» (مثلاً اینکه «خواننده هرگز آن سند را ندیده است») وجود ندارد.
در مثال اصلاح عنوان، دستور کاربر شامل یک «اکشن» (حذف عنوان) و یک «استدلال» (نمیخواهم لحن منفی باشد) بود. مدل اکشن را اجرا کرد اما استدلال را به عنوان محتوای متریال و مفید تلقی کرد. از دیدگاه مدل، آن استدلال مرتبط بود و در زمینه حضور داشت. علاوه بر این، مدلها آموزش دیدهاند که به طور مشهود به بازخوردها پاسخ دهند؛ بنابراین کوتاهترین راه برای «پرداختن» به یک نکته، اغلب ادغام آن در متن است، نه اعمال خاموش آن در پسزمینه.
دو عامل خاص این آلودگی را تشدید میکنند:
۱. جلسات طولانی مشترک: هرچه کارهای بیشتری در یک جلسه واحد انجام شود (بحث درباره بازخوردها، بررسی مشخصات و پیشنویس)، زمینه داخلی غنیتر و شلوغتر میشود. این نزدیکی دادهها، احتمال نشت آنها به محصول نهایی را افزایش میدهد. این پدیده در واقع شکلی از همان انحراف تدریجی عاملها در ماموریتهای طولانی است که در آن مدل کنترل دقیق خود بر هدف اولیه را از دست میدهد.
۲. محدودیت استانداردسازی: استفاده از دستورالعملها، حافظه (Memory) یا قوانین فایل CLAUDE.md میتواند نرخ نشت را با تعریف شکل مورد انتظار خروجی کاهش دهد. با این حال، این دستورات در همان پنجره زمینهٔ نامتمایز با سایر دادهها قرار دارند و اغلب در برابر نزدیکی فوری دادههای جلسه شکست میخورند. به همین دلیل است که شما نمیتوانید خروج دادهها را صرفاً با «خواهش کردن» یا دستور دادن به مدل متوقف کنید. در واقع برای رسیدن به خروجی مطلوب، باید به جای اتکا به دستورات ساده، به سراغ تعریف دقیق مفاهیم «پایان کار» و قراردادهای بازخورد رفت تا مرزهای خروجی شفاف شوند.
راهکارهای ساختاری برای پیشگیری از نشت
برای توقف خروج دادهها، باید از «درخواست از هوش مصنوعی برای رفتار درست» به سمت «ساخت یک معماری سخت و صلب» حرکت کرد. پنج الگوی فنی زیر، حفاظهای لازم را ایجاد میکنند:
اصل کمترین زمینه (Principle of Least Context): هر مرحله از خط لوله (Pipeline) فقط باید زمینهای را دریافت کند که به آن نیاز دارد. در Claude Code، تفویض وظایف به زیر-عاملها (Subagents) بسیار مؤثر است چون آنها کل تاریخچه گفتگو با والدین را به ارث نمیبرند. آنها یک دستورالعمل (Brief) گلچین شده دریافت میکنند: چه چیزی را، به چه کسی و با چه لحنی منتقل کنند. این کار حالت شکست را از «نشت اسرار» به «درخواست جزئیات گمشده» تغییر میدهد که شکستی قابل مشاهده و مدیریتپذیر است.
- قانون سخت برای نوع ۱: برای مطالب محرمانه، اصلاً آنها را در دستورالعمل (Brief) قرار ندهید. آنها را کاملاً حذف کنید یا دسترسی فقط-خواندنی به منابعی بدهید که عامل نتواند عیناً از آنها نقلقول کند. اگر داده هرگز وارد زمینه نشود، نمیتواند نشت کند.
- هشدار درباره گرسنگی داده: «کمترین زمینه» به معنای «زمینه گرسنه» نیست. اگر یک عامل نداند مشتری قبلاً چه میداند (توافقات تماس قبلی یا اصطلاحات ابداعی مشتری)، ممکن است بیش از حد توضیح دهد و ایمیلهای تکراری و تحقیرآمیز بنویسد. دستورالعمل باید دقیق باشد: دقیقاً آنچه خواننده نیاز دارد، نه بیشتر و نه کمتر.
بازبینی در اتاق پاک (Clean-Room Review Pass): الگوی دو-عامل یا دو-جلسه را اجرا کنید. یک عامل «نویسنده» با دسترسی کامل به زمینه داخلی، پیشنویس اولیه را تولید میکند. سپس، یک عامل «ویراستار» — که در یک جلسه کاملاً تازه، تنها با پیشنویس و شرح مخاطب عمل میکند — متن را بازبینی میکند. از ویراستار سؤال میشود: «آیا چیزی در اینجا وجود دارد که پیشفرض بگیرد خواننده زمینهای دارد که در واقعیت ندارد؟» چون ویراستار در جهلِ خواننده شریک است، ارجاعاتی مثل «F-12» را که عامل نویسنده (به دلیل حضور در جلسه اصلی) نادیده گرفته بود، شناسایی میکند.
برچسبگذاری منبع (Provenance Tagging): مواد داخلی را در مکانهای مشخص مانند پوشه
internal/یا بخشهای برچسبگذاری شده در یادداشتها ذخیره کنید. قانونی ثابت وضع کنید که محتوای این منابع باید «جهت اطلاع» مدل باشد اما هرگز نباید به صورت کلمه به کلمه نقل یا ارجاع شود. اگرچه این روش ضعیفتر از جداسازی کامل است، اما یک خط کف مکانیکی برای بازبینیها و ابزارهای Lint ایجاد میکند.درگاههای قطعی (Deterministic Gates): برای الگوهای تکراری نشت، یک اسکریپت ساده برتر از یک مدل LLM است. یک فیلتر پیش از ارسال که خروجی را برای شناسههای مستندات، نامهای رمز داخلی یا کلمات کلیدی پروژه «grep» میکند، یک درگاه سخت ایجاد میکند. این یک پردازش «نااهل» یا ساده است که توسط زمینه فریب نمیخورد و با منطق مدل متقاعد نمیشود. این رویکرد مشابه روشهایی است که در حذف خطاهای تخیلی از طریق تحلیل ایستا به کار میرود تا با جایگزینی احتمالات با قطعیت، دقت سیستم را بالا ببرد. اگرچه نشتهای بازنویسی شده (Paraphrased) را نمیگیرد، اما کلمات کلیدی شناخته شده را به یک توقف سخت تبدیل میکند.
تحویل صریح (Explicit Handoff): برای خروجیهای با ریسک بالا، جلسه کاری را کاملاً از جلسه تولید جدا کنید. نسخه نهایی باید در یک جلسه تازه و تنها با استفاده از یک «بسته تحویلی» (شامل پیشنویس، شرح مخاطب و محدودیتهای سبک) تولید شود. این دقیقاً مشابه انضباط مهندسی نرمافزار در جداسازی محیط Staging از Production است تا تضمین شود محیطهایی که نباید با هم در تماس باشند، یکدیگر را آلوده نمیکنند.
این رویکرد آینهای از انضباط مهندسی نرمافزار است. همانطور که توسعهدهندگان محیطهای استقرار را برای جلوگیری از آلودگی جدا میکنند، معماران هوش مصنوعی نیز باید فرآیند نامنظم پیشنویس را از عمل استریلِ تحویل جدا کنند.
اگر شما در حال استقرار عاملهایی برای مدیریت ارتباطات خارجی با مشتری هستید، مرز بین زمینه داخلی و محصول نهایی نباید فقط در ذهن شما باشد؛ بلکه باید در معماری خط لوله (Pipeline) شما کدگذاری شود. اندازه زمینه را محدود کنید، جلسات را ایزوله کنید و خروجیها را از درگاههای سخت عبور دهید.
من خط لولههای عاملهای هوش مصنوعی را دقیقاً با همین نوع حفاظها میسازم. اگر تیم شما در حال قرار دادن عاملها در مواجهه با مشتریان است، بیایید با هم گفتگو کنیم.
این مطلب ابتدا در javieraguilar.ai منتشر شد. برای دیدن پروژههای بیشتر در زمینه عاملهای هوش مصنوعی، پورتفولیوی من را بررسی کنید؛ جایی که سیستمهای چند-عاملی، توسعه MCP و اتوماسیون انطباق (Compliance) را به نمایش گذاشتهام.



گفتگو