
سه ثانیه خیره شدن به یک صفحه خالی، برای کاربر شبیه سی ثانیه است. طبق راهنمای فنی منتشر شده در ۲۵ اوت ۲۰۲۶، شاخص کلیدی موفقیت (KPI) در اپلیکیشنهای هوش مصنوعی، «تأخیر تا نخستین توکن» است، نه زمان کل پاسخدهی.
بسیاری از توسعهدهندگان بهاشتباه تأخیر را یک مشکل سختافزاری میبینند، در حالی که این یک مسئله ادراکی است. در ساختارهای غیر استریمینگ، کاربر تا زمان تولید کامل پاسخ به یک نماد در حال بارگذاری (Loading Spinner) خیره میشود. این شکاف روانی باعث میشود حتی اگر مدل سریع باشد، اپلیکیشن کند به نظر برسد.
همانطور که در تحلیلهای قبلی ما درباره بهینهسازی تجربه کاربری در مدلهای زبانی اشاره کردیم، مدیریت انتظارات کاربر از طریق بازخوردهای لحظهای حیاتی است. برای حل این مشکل، توسعهدهندگان میتوانند از پرچم stream=True در APIهای سازگار با OpenAI استفاده کنند. این قابلیت اجازه میدهد توکن (Token) — که شبیه برشهای کوچک یک کیک طولانی است و مدل متن را تکهتکه میخورد — بهمحض تولید به کاربر برسد.
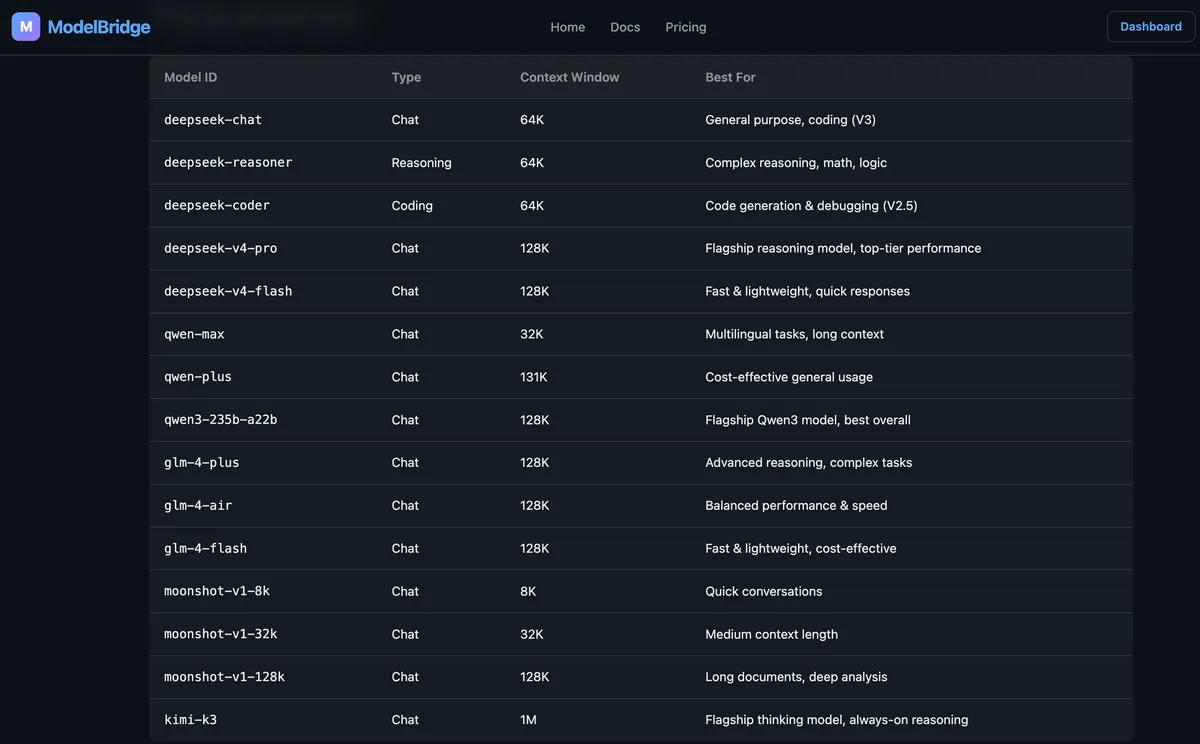
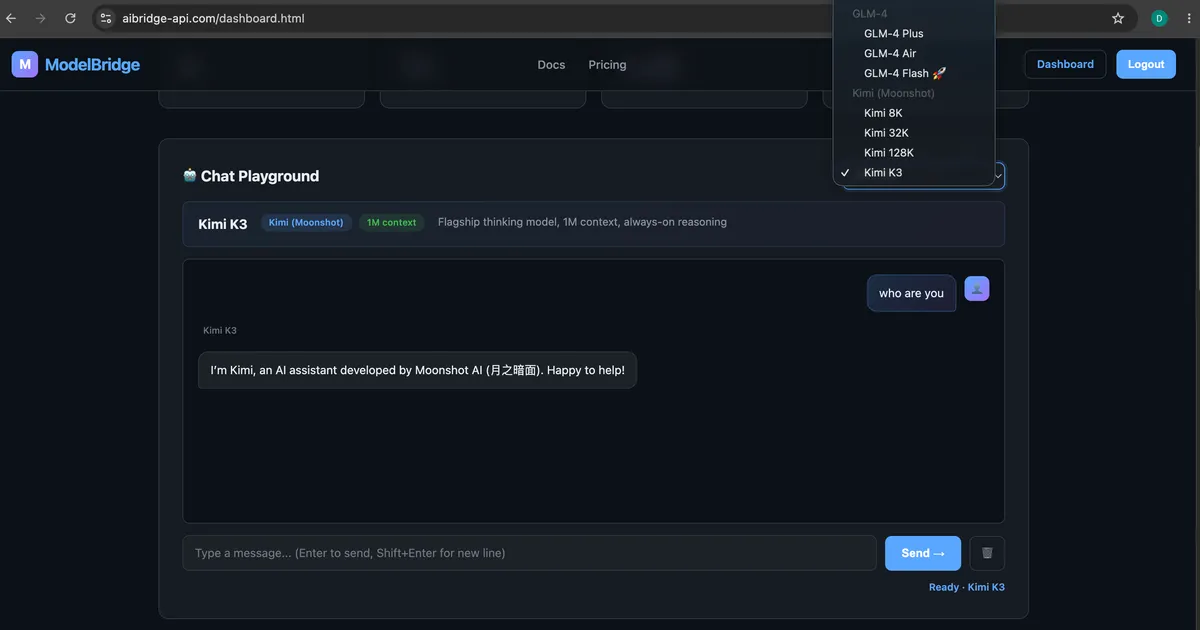
به نقل از مستندات فنی، ابزاری مانند AIBridge این امکان را فراهم میکند تا استریمینگ را در بیش از ۱۵ مدل از جمله DeepSeek، Kimi K3، GLM-4-Plus و Qwen بدون درگیر شدن با پیچیدگیهای هر ارائهدهنده پیادهسازی کنید. در این مسیر، مدیریت صحیح خطاها و جلوگیری از بازسازی نادرست پاسخها برای کاهش هزینههای تکراری در LLMها ضروری است.
جزئیات پیادهسازی فنی
- سازوکار: توکنها در بازههای میلیثانیهای به رابط کاربری (UI) میرسند و نیازی به انتظار برای دریافت کل بسته داده نیست. این رویکرد در کنار سختافزارهای پیشرفتهتر، سرعت پاسخدهی را به شدت افزایش میدهد؛ برای مثال، سختافزار Cerebras توانسته است سرعت استنتاج مدلهای پیشرفته را به ۷۵۰ توکن بر ثانیه برساند.
- مدلهای استدلالی: مدل استدلالی (Reasoning Model) — شبیه شطرنجبازی که چند حرکت جلوتر را میبیند و قبل از جواب درنگ میکند — معمولاً چند ثانیه «فکر» میکند. استریمینگ اجازه میدهد یک نشانگر «در حال تفکر...» نمایش داده شود تا کاربر احساس نکرد برنامه متوقف شده است.
- هزینه: سرویس AIBridge ماهانه ۵۰۰ هزار توکن رایگان ارائه میدهد و شارژهای بعدی هر ۱ میلیون توکن خام ۲.۹۹ دلار است.
این تغییر در پیادهسازی باعث میشود زمان کل تولید پاسخ برای رضایت آنی کاربر بیاهمیت شود. بهمحض اینکه اولین توکن روی صفحه ظاهر شود، حس انتظار فرو میپاشد و کاربر مصرف پاسخ را بهصورت لحظهای آغاز میکند.
توسعهدهندگان باید فراخوانیهای API خود را بازبینی کنند تا مطمئن شوند در رابطهای گفتگو از stream=False استفاده نمیکنند. گام بعدی، ادغام یک رابط کاربری سازگار با استریمینگ است که بتواند بهروزرسانیهای دلتا (تغییرات جزئی) را مدیریت کند تا سرعت ادراکشده به حداکثر برسد.
گام بعدی شما
- تمام فراخوانیهای API در بخش گفتگو را به حالت
stream=Trueتغییر دهید. - برای مدلهای استدلالی، یک وضعیت بصری (Visual State) برای بازه زمانی «تفکر» مدل طراحی کنید.
- رابط کاربری خود را برای پذیرش دادههای تکهای (Chunked Data) بهروز کنید.
اما داستان سختافزاری این تحول حتی شگفتانگیزتر است — به تحلیل ما درباره تراشههای Blackwell مراجعه کنید.



گفتگو