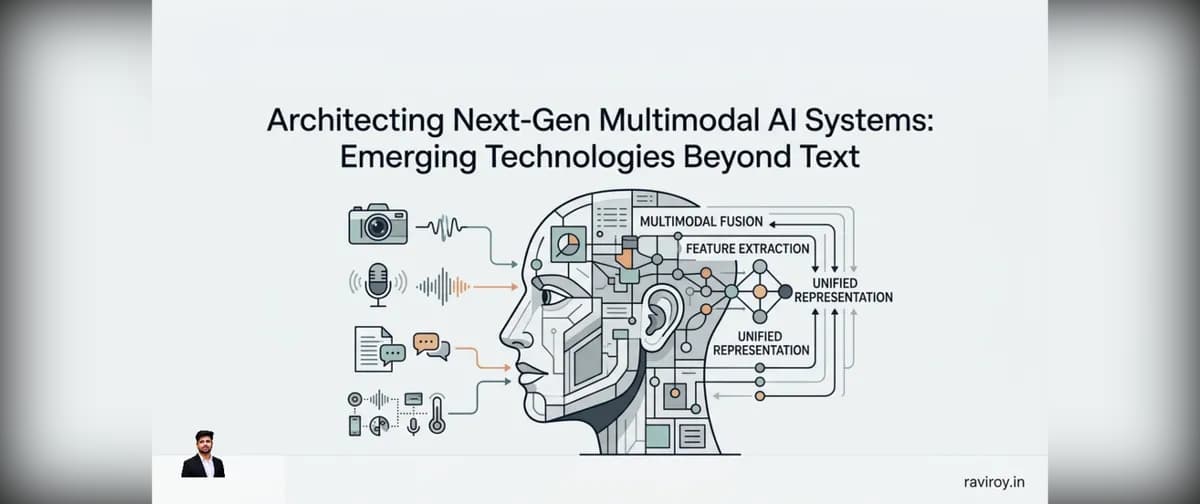
اگر امروز برای توسعه محصولات هوش مصنوعی روی مدلهای تکبعدی سرمایهگذاری میکنید، احتمالاً تا سال ۲۰۲۶ با یک پشتهٔ فناوری منسوخ روبرو خواهید شد. تکیه بر متن یا تصویر بهتنهایی، شبیه این است که بخواهید یک کنسرت را تنها با یک گوش یا یک چشم درک کنید؛ در حالی که هوش مصنوعی چندوجهی اکنون از یک کالای لوکس به یک ضرورت معماری تبدیل شده است. برای هر توسعهدهندهای که قصد دارد تا سال ۲۰۲۶ محصولاتی رقابتی روانه بازار کند، این تغییر رویکرد اکنون یک ضرورت است.
به گزارش منابع تخصصی، صنعت برای سالها با هوش مصنوعی بهعنوان مجموعهای از سیلوهای تخصصی برخورد کرده است. شما از یک مدل برای متن، یکی برای تصویر و سومی برای صدا استفاده میکردید. این رویکرد تکهتکه، «نقاط کوری» ایجاد میکند که در آن بافتهای حیاتی دادهها بهدلیل عدم ارتباط مدلها با یکدیگر، از دست میروند.
تصور کنید یک بات پشتیبانی مشتری، متن خشمگین کاربر را میخواند اما نمیتواند چهرهٔ مستأصل او را در تماس تصویری «ببیند» یا طعنه را در لحن صدای او «بشنود». با ادغام این جریانها، هوش مصنوعی از تطبیق سادهٔ الگوها به درکی جامع از تعاملات انسانی میرسد.
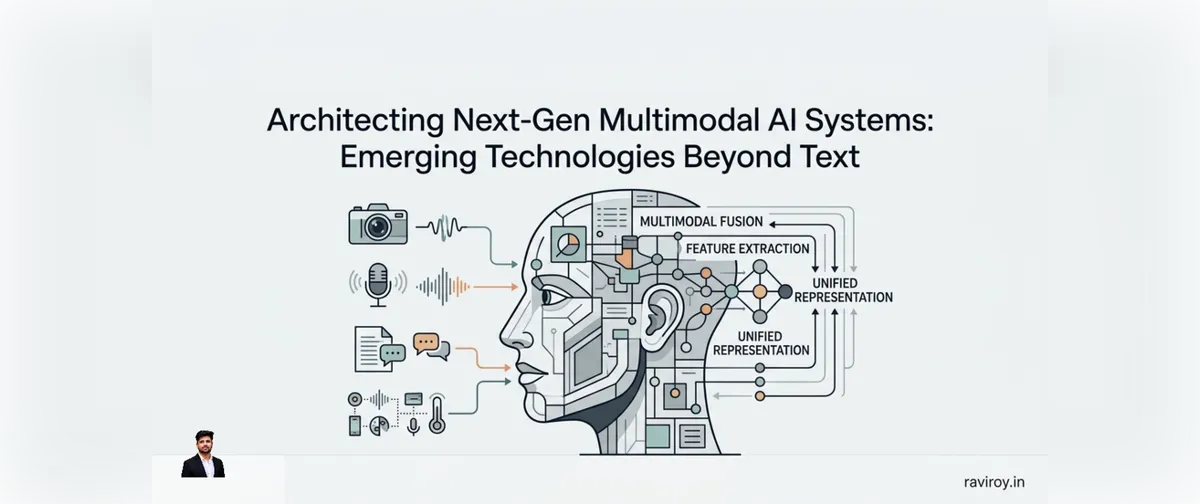
تعریف چندوجهی بودن: فراتر از متن و صدا
هوش مصنوعی چندوجهی (Multimodal AI) — شبیه انسانی است که همزمان با چشم، گوش و لمس، محیط را میفهمد — توانایی یک سامانه برای پردازش و ادغام همزمان اطلاعات از انواع مختلف ورودی یا «وجهها» است. برخلاف مدلهای سنتی مثل مدل زبانی بزرگ (LLM) — که مثل کتابخانهداری است که میلیاردها صفحه را خوانده و حالا با همان لحن جواب میدهد — مدلهای چندوجهی تلاش میکنند تعامل جامع انسان با جهان را شبیهسازی کنند. این تفاوت در یادگیری، ما را به این پرسش میرساند که چرا بهرهوری داده در انسانها بسیار بیشتر از مدلهای فعلی AI است و کودکان با دادههای بسیار کمتری به درک محیط میرسند.
بر اساس بررسیهای فنی، چندوجهی بودن واقعی فراتر از متن و صداست و حوزههای زیر را در بر میگیرد:
- بینایی: شامل تصاویر، ویدیوها، تشخیص اشیا، حالات چهره و درک کامل صحنه.
- زبان: شامل متن، گفتار، تحلیل احساسات و هر دو حوزهٔ درک زبان طبیعی (NLU) و تولید زبان طبیعی (NLG).
- صوت: فراتر از گفتار؛ شامل صداهای محیطی، موسیقی، شناسایی گوینده و تشخیص احساسات استخراج شده از روی لحن.
- لامسه (Haptic): شامل دادههای لمس، نیرو، ارتعاش و بازخوردهای لمسی.
- جریانهای حسگر: ادغام دما، فشار، GPS، لیدار (Lidar)، رادار و دادههای بیومتریک.
این تکامل بر خروجیها نیز اثر گذاشته است. سامانههای پیشرفته دیگر فقط متن تولید نمیکنند؛ آنها میتوانند از توصیفات متنی، تصویر بسازند، از متن گفتار سنتز کنند یا از ورودیهای ترکیبی، ویدیو تولید کنند و به سمت ادراک و تولید یکپارچه حرکت کنند.
سازوکار درک چندوجهی
طبق گزارشی که در ۴ سپتامبر ۲۰۲۶ در وبسایت dev.to منتشر شد، گذار به چندوجهی بودن بر سه مرحلهٔ معماری استوار است:
- رمزگذاری مجزا: دادههای خام ابتدا توسط رمزگذارهای تخصصی پردازش میشوند تا نمایشهای عددی به نام بردار معنایی (Embedding) یا بردارهای ویژگی ایجاد کنند. برای تصاویر، این کار ممکن است شامل شبکههای عصبی پیچشی (CNN) یا ترنسفورمرهای بینایی (ViT) باشد. برای متن، از مدلهای مبتنی بر ترنسفورمر مثل BERT یا GPT استفاده میشود. برای صوت، ممکن است از RNNها، CNNها یا ترنسفورمرهای صوتی برای پردازش طیفنگاشتها (Spectrograms) استفاده شود.
- فضای نهان مشترک: این بردارهای پراکنده روی یک نقشه مفهومی مشترک یا فضای نهان (Latent Space) تصویر میشوند. در این فضا، تصویر یک گربه، کلمه «گربه» و صدای میو کردن، در کنار هم قرار میگیرند. این همترازی به سامانه اجازه میدهد روابط معنایی را در وجههای مختلف درک کند.
- تلفیق (Fusion): سامانه این نمایشهای همراستا را ترکیب میکند تا یک بستر واحد بسازد. برای مثال، دیدن چهرهای غمگین (بینایی) همزمان با شنیدن صدایی آرام و بم (صوت) و خواندن متنی دربارهٔ «یک روز سخت» (زبان)، نتیجهای بسیار دقیقتر و استوارتر از هر ورودی بهتنهایی درباره وضعیت عاطفی فرد میدهد.
همانطور که در تحلیلهای قبلی ما دربارهٔ امنیت مدلهای بازمتن اشاره کردیم، هرچه پیچیدگی ورودیها بیشتر شود، مدیریت نقاط اتصال دادهها چالشبرانگیزتر میشود.
استراتژیهای تلفیق دادهها
معماران سیستم باید تصمیم بگیرند که جریانهای داده در چه زمانی و چگونه ادغام شوند. این انتخاب، عملکرد و هزینه را بهطور بنیادی تغییر میدهد:
۱. تلفیق زودهنگام (Early Fusion): ترکیب دادههای خام یا ویژگیهای اولیه در همان ابتدا. برای یک ویدیو، ممکن است ویژگیهای بصری هر فریم را با ویژگیهای صوتی متناظر پیش از ورود به یک مدل واحد، به هم متصل (Concatenate) کنید. این روش همبستگیهای ظریف را میگیرد اما فضای ورودی را بسیار حجیم و هزینهبر کرده و میتواند به نویز حساس باشد.
۲. تلفیق دیرهنگام (Late Fusion): پردازش مستقل هر وجه و ترکیب تصمیمات نهایی. برای مثال، یک مدل احساسات را از متن تشخیص میدهد و مدل دیگر احساس را از روی چهره؛ سپس یک لایه تصمیمگیرنده، میانگین وزنی آنها را محاسبه میکند. این روش عیبیابی سادهتری دارد و اجازه استفاده از مدلهای پیشآموزشدیده را میدهد، اما تعاملات غنیِ مراحل اولیه را از دست میدهد.
۳. تلفیق ترکیبی (Hybrid Fusion): ترکیبی از هر دو روش که اغلب از پردازش اولیه مخصوص هر وجه و سپس لایههای تلفیق میانی استفاده میکند. این روشها معمولاً از مکانیزمهای توجه متقاطع (Cross-attention) برای وزندهی به اهمیت یک وجه (مثلاً یک نشانه بصری) هنگام پردازش وجه دیگر (مثلاً یک توکن متنی) بهره میبرند.
ضرورت سازمانی: خروج از سیلوها
سازمانها سالها به ابزارهای گسسته تکیه کردهاند: نویسهخوانی نوری (OCR) برای اسناد، بازشناسی گفتار (ASR) برای تماسها، تبدیل متن به گفتار (TTS) برای رابطهای صوتی و سامانههای بینایی ماشین مجزا. این رویکرد منجر به سه شکست اصلی شده است:
- بینشهای تکهتکه: درک ناقص سناریوهای پیچیده بهدلیل نبود دادههای بافتی از وجههای دیگر.
- سربار ادغام دستی: صرف زمان زیاد توسعهدهندگان برای چسباندن خروجیهای سامانههای مختلف به یکدیگر.
- تجربه کاربری ضعیف: چتباتهایی که نمیبینند کاربر به چه چیزی اشاره میکند، یا دستیارهای صوتی که حالات چهره را نادیده میگیرند.
هوش مصنوعی چندوجهی با فعال کردن جریانهای کاری یکپارچه این مشکل را حل میکند. بهجای مدلهای مجزا، یک سامانه واحد اطلاعات را از کانالهای مختلف دریافت و همبسته میکند و این را به یک قابلیت محوری برای محصولات هوش مصنوعی عصر ۲۰۲۶ تبدیل میکند.
کاربردهای عملی و ارزش تجاری
مشکلات واقعی کسبوکارها ذاتاً چندوجهی هستند. گزارش dev.to چندین کاربرد پربازده را برجسته میکند:
- بهداشت و درمان: ادغام تصاویر پزشکی (X-ray، MRI، CT scan) با پروندههای الکترونیک سلامت (متن)، دادههای بیومتریک پوشیدنیها (حسگرها) و یادداشتهای پزشک (متن/صوت) برای تشخیصهای دقیقتر و تحلیلهای پیشبینانه از پیشرفت بیماری.
- تولید صنعتی: جفت کردن بازرسی بصری سطوح (تشخیص نقص در تصویر/ویدیو) با تشخیص ناهنجاریهای صوتی (گوش دادن به صداهای غیرعادی ماشینآلات) برای شناسایی سریعتر نقصها نسبت به اپراتور انسانی.
- سامانههای خودران: تلفیق لیدار، رادار، دوربین و GPS برای ایجاد نقشه محیطی ۳۶۰ درجه در لحظه برای ناوبری ایمن. رباتهای پیشرفته همچنین بینایی و لامسه را برای انجام کارهای پیچیده در محیطهای بدون ساختار ترکیب میکنند. در همین راستا، معماریهای جدیدی مانند مدل Atlas با تمرکز بر زمینه مکانی، توانستهاند دقت بازسازی سهبعدی محیط را به شکل چشمگیری ارتقا دهند.
- تجربه مشتری: تحلیل متن چت در کنار لحن صدا (صوت) و نشانههای چهره از طریق ویدیو (بینایی)، در حالی که اسکرینشاتهای مربوط به مشکل (بینایی) پردازش میشوند تا پشتیبانی همدلانه و شخصیسازی شده ارائه شود.
- شهرهای هوشمند: ترکیب دوربینهای ترافیکی (بینایی) با حسگرهای صوتی (صوت) برای تشخیص صدای شلیک یا شکستن شیشه، و حسگرهای محیطی (دما، آلودگی) برای بهینهسازی تخصیص منابع.
- خردهفروشی و آموزش: خردهفروشان از ردیابی نگاه و زمان توقف (بینایی) در کنار تاریخچه خرید (متن) استفاده میکنند. پلتفرمهای آموزشی از تحلیل حالات چهره (بینایی) برای سنجش میزان درگیری کاربر و تحلیل گفتار (صوت) برای درک میزان فهم استفاده میکنند.
پشتهٔ پیادهسازی عملی
انتقال این سامانهها به محیط تولید با اصطکاک زیادی همراه است. همزمانی دادهها (Data Synchronization) بزرگترین مانع است؛ برای مثال، یک مجموعه داده ویدئویی برای تشخیص احساسات، نیازمند تراز بودن فریمها، صدا و متن در حد میلیثانیه است. این امر مستلزم تجهیزات ضبط تخصصی و پروتکلهای ضبط دقیق است.
برچسبگذاری (Labeling) دادههای چندوجهی بسیار دشوار و زمانبر است. نه تنها هر وجه باید جداگانه برچسب بخورد (مانند جعبههای محدودکننده یا Bounding Boxes برای تصاویر)، بلکه روابط بین آنها (مثلاً کدام کلمه در متن مربوط به کدام حرکت در تصویر است) نیز باید بهطور صریح برچسبگذاری شود. پیشپردازش بسته به هر جریان متفاوت است:
- صوت: نیازمند ضرایب کپسترال فرکانس مل (MFCCs)، طیفنگاشتها، کاهش نویز و نرمالسازی است.
- تصویر/ویدیو: نیازمند تغییر اندازه، نرمالسازی، افزایش دادهها (چرخش، برش) و نمونهبرداری از فریمها است.
- متن: نیازمند توکنبندی، ریشهیابی (Stemming/Lemmatization)، حذف کلمات توقف و تولید بردار (Word2Vec, GloVe) است.
- دادههای حسگر: نیازمند تراز کردن سریهای زمانی، درونیابی برای دادههای گمشده، تشخیص دادههای پرت و مقیاسبندی است.
آموزش و بهینهسازی
آموزش این مدلها بسیار منابعبر است. بهدلیل تعداد زیاد پارامترها در مدلهای چندوجهی، استفاده از واحد پردازش گرافیکی (GPU) و واحد پردازش تنسور (TPU) اجباری است. چارچوبهای آموزش توزیعشده مانند PyTorch Distributed یا TensorFlow Distributed برای مقیاسپذیری حیاتی هستند.
اکثر توسعهدهندگان بهجای آموزش از صفر، از یادگیری انتقالی (Transfer Learning) برای تنظیم دقیق (Fine-tuning) — شبیه وقتی که به یک پزشک عمومی، تخصص پوست میدهیم تا روی یک حوزه دقیق شود — استفاده میکنند.
یک نمونه کلیدی، مدل CLIP (Contrastive Language-Image Pre-training) است که یاد میگیرد توصیفات متنی را با تصاویر مرتبط کند. این کار از طریق یک تابع زیان تضادی (Contrastive Loss) انجام میشود که جفتهای مشابه را در فضای برداری به هم نزدیک و جفتهای نامرتبط را دور میکند تا توافق بین جفتهای صحیح (تصویر، متن) به حداکثر برسد.
بهینهسازی بهدلیل نیاز به مدیریت چندین تابع زیان در وجههای مختلف پیچیدهتر میشود. تکنیکهایی مانند برش گرادیان (Gradient Clipping)، زمانبندی نرخ یادگیری و تنظیم دقیق هایپرپارامترها برای پیمایش در چشماندازهای پیچیده بهینهسازی حیاتی هستند.
استقرار، تأخیر و هزینه
در مرحلهٔ استقرار، موازنه میان تأخیر و هزینه رخ میدهد. پردازش جریانهای پهنایباند بالا در لحظه نیازمند راهکارهای زیر است:
- رایانش لبه (Edge Computing): انجام استنتاج (Inference) — لحظهای که مدل واقعاً جواب تولید میکند — در نزدیکی منبع داده برای کاهش لگ.
- بهینهسازی مدل: استفاده از کوانتایزیشن (Quantization)، هرس کردن (Pruning) و تقطیر دانش (Knowledge Distillation) برای کاهش اشغال حافظه.
- پردازش نامتقارن: مدیریت موازی وجههای مختلف یا اولویتبندی وجههای حیاتی.
- شتابدهندههای سختافزاری: استفاده از شتابدهندههای استنتاج تخصصی برای مدیریت هزینههای محاسباتی بالای GPUها و TPUها.
ارکستراسیون پیشرفته و استواری
نسل بعدی سامانهها به سمت «مسیریابی پویا» میروند. بهجای اجرای تمام رمزگذارها برای هر پرسش، هوش مصنوعی بر اساس بستر تصمیم میگیرد. در یک اتاق تاریک، سامانه بهطور خودکار اولویت را به صوت میدهد تا دقت حفظ شود. این ساختار اغلب از طریق ترکیب خبرهها (Mixture of Experts) اجرا میشود که در آن خبرههای مخصوص هر وجه تنها زمانی فراخوانده میشوند که ورودی آنها باکیفیت تشخیص داده شود.
این افزونگی باعث افزایش استواری میشود. اگر ضبط صدا بهدلیل نویز خراب شود، سامانه میتواند روی لبخوانی یا زبان بدن تکیه کند تا شکافها را پر کند. این افزونگی متقاطع، هوش مصنوعی را در برابر حملات خصمانه (Adversarial Attacks) و دادههای گمشده مقاومتر میکند.
مسیر رسیدن به تفسیرپذیری
چندوجهی بودن در واقع به حل مشکل «جعبه سیاه» هوش مصنوعی کمک میکند. یک هوش مصنوعی پزشکی میتواند با استفاده از توضیحات متقاطع، ناحیه خاصی از عکس رادیولوژی (بینایی) و خط خاصی از تاریخچه بیمار (متن) را که منجر به تشخیص شده، برجسته کند.
نقشههای توجه (Attention Maps) به توسعهدهندگان اجازه میدهند دقیقاً ببینند مدل هنگام تولید یک کلمه، روی کدام بخش تصویر یا قطعهای از صدا تمرکز کرده است. نقشههای برجستگی مبتنی بر گرادیان (Saliency Maps) میتوانند بیشتر نشان دهند که کدام ویژگیهای ورودی در وجههای مختلف، بیشترین تأثیر را در یک پیشبینی داشتهاند.
چشمانداز آینده و چالشها
با وجود مسیر روشن، کمبود دادههای همزمان برچسبگذاریشده یک گلوگاه بزرگ است. همچنین ملاحظات اخلاقی حیاتی هستند؛ زیرا سوگیری در یک وجه میتواند هنگام تلفیق، سوگیری در وجه دیگر را تقویت کند، بهویژه در مورد دادههای بیومتریک حساس.
صنعت اکنون به سمت «استنتاج علی» (Causal Inference) حرکت میکند تا بهجای همبستگی ساده، روابط علت و معلولی بین ورودیهای چندوجهی و نتایج را درک کند. این موضوع برای کاربردهای حساس که در آنها «چرا» به اندازه «چه چیزی» اهمیت دارد، حیاتی است.
این تغییر نشاندهنده یک تغییر پارادایم است. ما از ابزارهای هوش مصنوعی گسسته به سمت جریانهای کاری یکپارچهای میرویم که جهان را به جامعیت انسانها درک میکنند.
گام بعدی شما
- سیلوهای دادهای فعلی خود را ارزیابی کنید و ببینید کجا اضافه کردن یک وجه دوم (مثلاً صوت یا دادههای حسگر) میتواند ابهامات تصمیمگیری مدل شما را برطرف کند.
- مدلهای پیشآموزشدیده چندوجهی مانند CLIP را برای استخراج ویژگیهای مشترک بین متن و تصویر در پروژههای خود تست کنید.
- استراتژی تلفیق (Fusion) خود را بر اساس موازنه هزینه و دقت بازنگری کنید؛ اگر نیاز به سرعت دارید، به سراغ Late Fusion بروید.
اما داستان سختافزاری این تحول حتی شگفتانگیزتر است — به تحلیل ما دربارهٔ تراشههای Blackwell و بهینهسازی استنتاج چندوجهی مراجعه کنید.



گفتگو