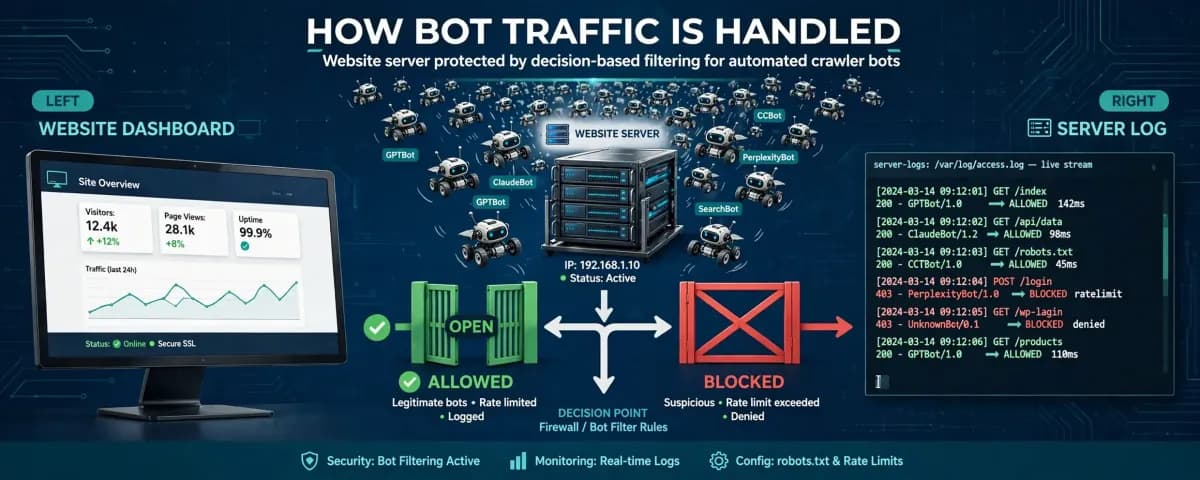
اگر امروز به لاگهای سرور خود نگاه کنید، احتمالاً با سیل عظیمی از نامهای ناشناس مثل GPTBot، ClaudeBot، CCBot، PerplexityBot، Bytespider و Amazonbot مواجه میشوید. اینها دیگر جستوجوگرهای سادهای نیستند که کاربر را به سایت شما بفرستند، بلکه موج جدیدی از باتهای هوش مصنوعی هستند که محتوا را برای تغذیه سیستمهای بازیابی آنی (Real-time Retrieval) یا آموزش مدلها جمعآوری میکنند.
به گزارش dev.to در ۳۰ سپتامبر ۲۰۲۶، این باتها اغلب پاسخ کاربر را مستقیماً میدهند و حتی یک بازدیدکننده هم برای سایت شما ارسال نمیکنند. برای یک دهه، توسعهدهندگان سایتهایشان را برای Googlebot بهینه کردند تا ترافیک بگیرند، اما حالا قواعد تبادل ارزش عوض شده است. این تغییر رویکرد را میتوان در جایگزینی پاسخهای محاورهای هوش مصنوعی به جای لینکهای سنتی موتورهای جستوجو مشاهده کرد که نحوه تعامل کاربران با وب را بنیادین تغییر داده است. در حالی که خزندههای جستوجوی سنتی ایندکسهایی میسازند تا کاربر را به سمت شما هدایت کنند، خزندههای هوش مصنوعی یا دادهها را برای تبدیل به وزنهای مدل (Model Weights) استخراج میکنند یا صفحات را برای مبنیسازی (Grounding) پاسخهای هوش مصنوعی فراخوانی میکنند. خطر اینجاست که یک بات واحد اغلب هر دو نقش را بدون هیچ شفافیتی ایفا میکند؛ به همین دلیل استراتژیهای سادهی «اجازه برای همه» یا «مسدود کردن همه»، برای زیرساخت و میزان دیده شدن شما خطرناک است.
هزینههای پنهان استخراج داده
خزندههای هوش مصنوعی بهطور قابلتوجهی تهاجمیتر از باتهای جستوجوی سنتی هستند. آنها مکرراً تنظیمات تأخیر در خزش (crawl-delay) را نادیده میگیرند و روزانه هزاران بار به سایتها حمله میکنند. این تهاجم در چند مورد ملموس ظاهر میشود:
- جهش هزینههای زیرساختی: در زیرساختهای دارای پرداخت به میزان مصرف (Metered) یا بدون سرور (Serverless)، یک بات بدرفتار میتواند با درخواستهای مکرر برای گالریهای سنگین تصاویر، URLهای جستوجوی فیلترشده (Faceted Search) یا نقاط انتهایی API، باعث جهش شدید صورتحساب میزبانی شما شود.
- آلودگی دادهها: ترافیک باتها اغلب با دادههای تبدیل (Conversion) ترکیب شده و تحلیلهای آماری شما را بههم میریزد، مگر اینکه فیلترهای سختگیرانهای اعمال شده باشد.
- فعال شدن سیستمهای امنیتی: ضربات متوالی و با فرکانس بالا از سوی باتها میتواند قوانین WAF یا محدودیتهای نرخ درخواست (Rate Limits) را فعال کند و بهطور طنزآمیزی، کاربران انسانی واقعی را که در همان محدوده IP هستند، مسدود کند.
- نشت محتوا: برخی باتها از حدس زدن تهاجمی URLها استفاده میکنند تا محتوایی که پشت مسیرهای پیشبینیپذیر یا دیوارهای پرداخت (Paywalls) قرار دارد را استخراج کنند.
اگر سایت کوچکی دارید، یک خزنده تهاجمی میتواند درصد قابلتوجهی از کل ترافیک شما را تشکیل دهد؛ بنابراین بررسی دقیق لاگها پیش از هر تصمیمی حیاتی است.
مهندسی یک سیاست گزینشی
مسدود کردن همه چیز شاید حس حاکمیت بر دادهها را بدهد، اما یک خلأ در کشف محتوا ایجاد میکند. موتورهای پاسخگوی مبتنی بر هوش مصنوعی در حال تبدیل شدن به کانالهای اصلی کشف محتوا هستند. اگر مستندات یا وبلاگ شما برای این سیستمها نامرئی باشد، شانس نقلقول شدن به عنوان منبع در «صفحه اول جدید» وب (یعنی پاسخهای هوش مصنوعی) را از دست میدهید. برای پایگاههای دانش باز و وبلاگها، این یک کانال توزیع واقعی است که با مسدودسازی آن، در واقع در حال بستن آن هستید.
برای مدیریت این وضعیت، توسعهدهندگان باید این چارچوب دادهمحور را دنبال کنند:
- ابتدا اندازهگیری کنید: لاگهای هفت روز اخیر را استخراج کنید. شناسایی کنید کدام User Agentهای هوش مصنوعی به شما حمله میکنند، هر چند وقت یکبار میآیند، کدام URLها را هدف قرار میدهند و چه مقدار پهنای باند مصرف میکنند. بدون داده، هیچ تصمیمی نگیرید.
- محتوا را طبقهبندی کنید: سایت خود را به دستههای مختلف تقسیم کنید. محتوای بازاریابی عمومی و مستندات معمولاً برای بازیابی (Retrieval) مناسباند. اما محتوای تولیدشده توسط کاربر، مطالب پشت دیوار پرداخت یا صفحاتی که رندر کردن آنها هزینهبر است، باید به سمت مسدودسازی بروند.
- تفکیک آموزش از بازیابی: به باتهایی که منابع را ذکر و به آنها ارجاع میدهند اجازه دسترسی بدهید؛ اما استخراجکنندههای صرف (Pure Scrapers) را که هیچ چیزی در مقابل نمیدهند، مسدود کنید.
- تکرار و اصلاح آگاهانه: ابتدا با سیاستهای بازتر شروع کنید و سپس قوانین را تنگتر کنید. مسدود کردن یک بازیگر بد خاص، بسیار راحتتر از جبران ماهها نامرئی بودن در پاسخهای هوش مصنوعی است.
لایههای اجرای فنی
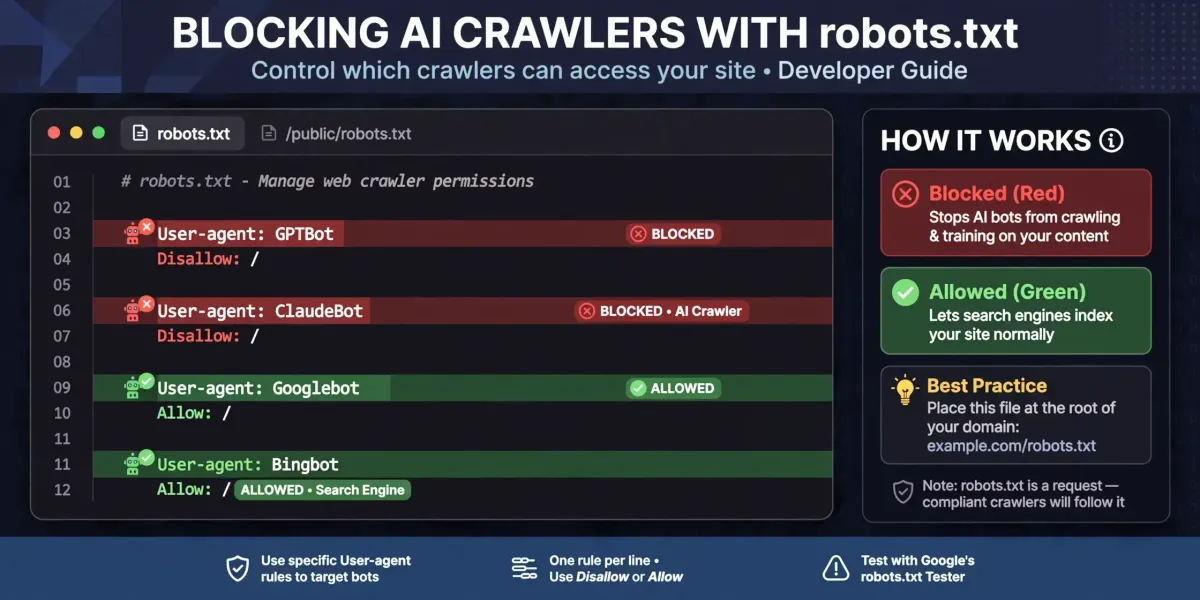
کنترل باید در چندین لایه رخ دهد. فایل robots.txt همچنان استاندارد است، اما باید بهطور صریح نوشته شود. جدا کردن باتهای هوش مصنوعی از خزندههای جستوجو مانع از آن میشود که یک خطای کوچک در استفاده از علامت ستاره (Wildcard)، کل ترافیک ارگانیک شما را نابود کند.
مثال برای مسدود کردن باتهای خاص:
User-agent: GPTBotDisallow: /
User-agent: CCBotDisallow: /
User-agent: ClaudeBotDisallow: /
برای باتهایی که robots.txt را نادیده میگیرند، اجرا باید به لایه لبه (Edge) منتقل شود. این شامل محدود کردن نرخ درخواست بر اساس User Agent یا بازگرداندن پاسخ 403 Forbidden از طریق یک دیوار آتش اپلیکیشن وب (WAF) است. به یاد داشته باشید که robots.txt یک درخواست است، نه یک قفل سختافزاری.
علاوه بر این، قرارداد نوظهور llms.txt — یک فایل مارکداون در دایرکتوری ریشه — خلاصهای ساختاریافته مخصوص مدلهای زبانی ارائه میدهد. این فایل را مثل یک نقشه سایت (Sitemap) برای سیستمهای هوش مصنوعی تصور کنید. اگرچه این قرارداد در مراحل اولیه است، اما ارزش دنبال کردن دارد.
ارتباط با RAG و عاملها
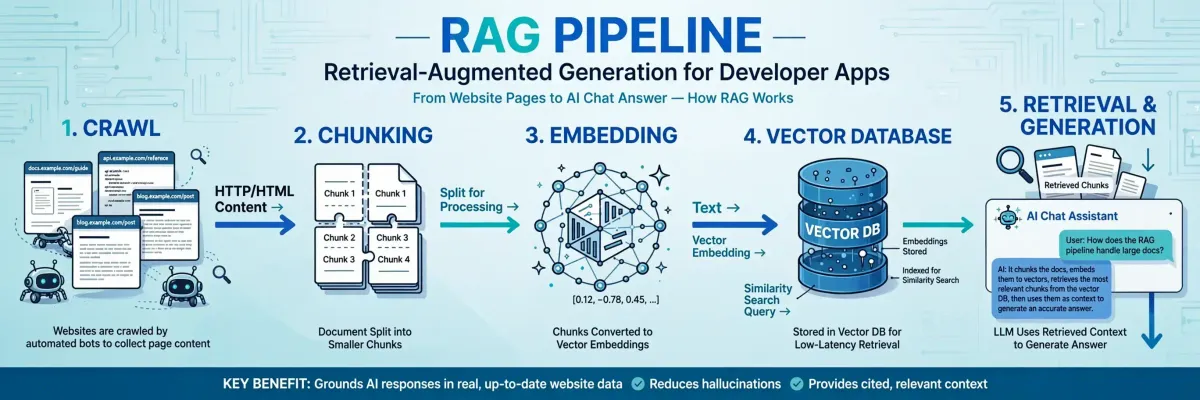
این موضوع فراتر از سئو و در قلمرو تولید بازیابیافزا (RAG) قرار دارد. محتوایی که این باتها جمع میکنند، اغلب تکهتکه (Chunked) شده، به بردار معنایی (Embedding) تبدیل شده و به خط لولههای RAG سازمانی تزریق میشود. در واقع، آموزشها و پاسخهای انجمنهای شما تبدیل به پایگاه دانش محصول هوش مصنوعی شخص دیگری میشود.
اگر محصول هوش مصنوعی میسازید، درک این مسیر ضروری است. مکانیسمهای خزش، تکهبندی و تبدیل به بردار در هر دو طرف ماجرا یکسان است. مشکل خزنده و مشکل RAG در واقع یک مسئله واحد هستند که از دو زاویه مختلف به آنها نگاه میشود.
در آینده، چالش از خزندهها به عاملهای هوش مصنوعی (AI Agents) منتقل خواهد شد. برخلاف باتها، عاملها مثل انسانها وبگردی میکنند؛ کلیک میکنند، اسکرول میکنند و فرمها را پر میکنند. چون آنها اغلب از مرورگرهای واقعی استفاده میکنند، احتمالاً robots.txt را نادیده میگیرند. این موضوع تشخیص یک کاربر مفید که در حال انجام یک وظیفه است از یک استخراجکننده پیشرفته که لباس مرورگر پوشیده است را تقریباً غیرممکن میکند و میتواند منجر به این شود که وبسایتهای محلی تا سال ۲۰۲۶ در برابر این عاملها کاملاً نامرئی شوند.
چکلیست نهایی اجرا
مدیریت باتها دیگر یک کار «یکبار برای همیشه» نیست. برای بهروز ماندن، از این چکلیست استفاده کنید:
- تحلیل لاگهای ۷ روز اخیر برای شناسایی User Agentهای هوش مصنوعی و هزینههای پهنای باند.
- طبقهبندی محتوا: عمومی/قابل ارجاع در مقابل خصوصی/پرهزینه.
- نوشتن قوانین صریح robots.txt برای هر خانواده از باتها (پرهیز از مسدودسازی کلی).
- اعمال محدودیت در لایه Edge برای باتهایی که robots.txt را نادیده میگیرند.
- بازبینی فصلی سیاستها همزمان با ظهور باتهای جدید.
توسعهدهندگانی که در لایه درست اندازهگیری و کنترل میکنند، موفق خواهند شد. کسانی که بر اساس حدس و گمان یا مسدودسازیهای کلی عمل میکنند، یا صورتحسابهای سنگین پهنای باند را پرداخت خواهند کرد یا بهطور کامل از پاسخهای هوش مصنوعی محو میشوند.
اما داستان سختافزاری این تحول حتی شگفتانگیزتر است — به تحلیل ما دربارهی تراشههای Blackwell مراجعه کنید.



گفتگو